搜索到
22
篇与
的结果
-
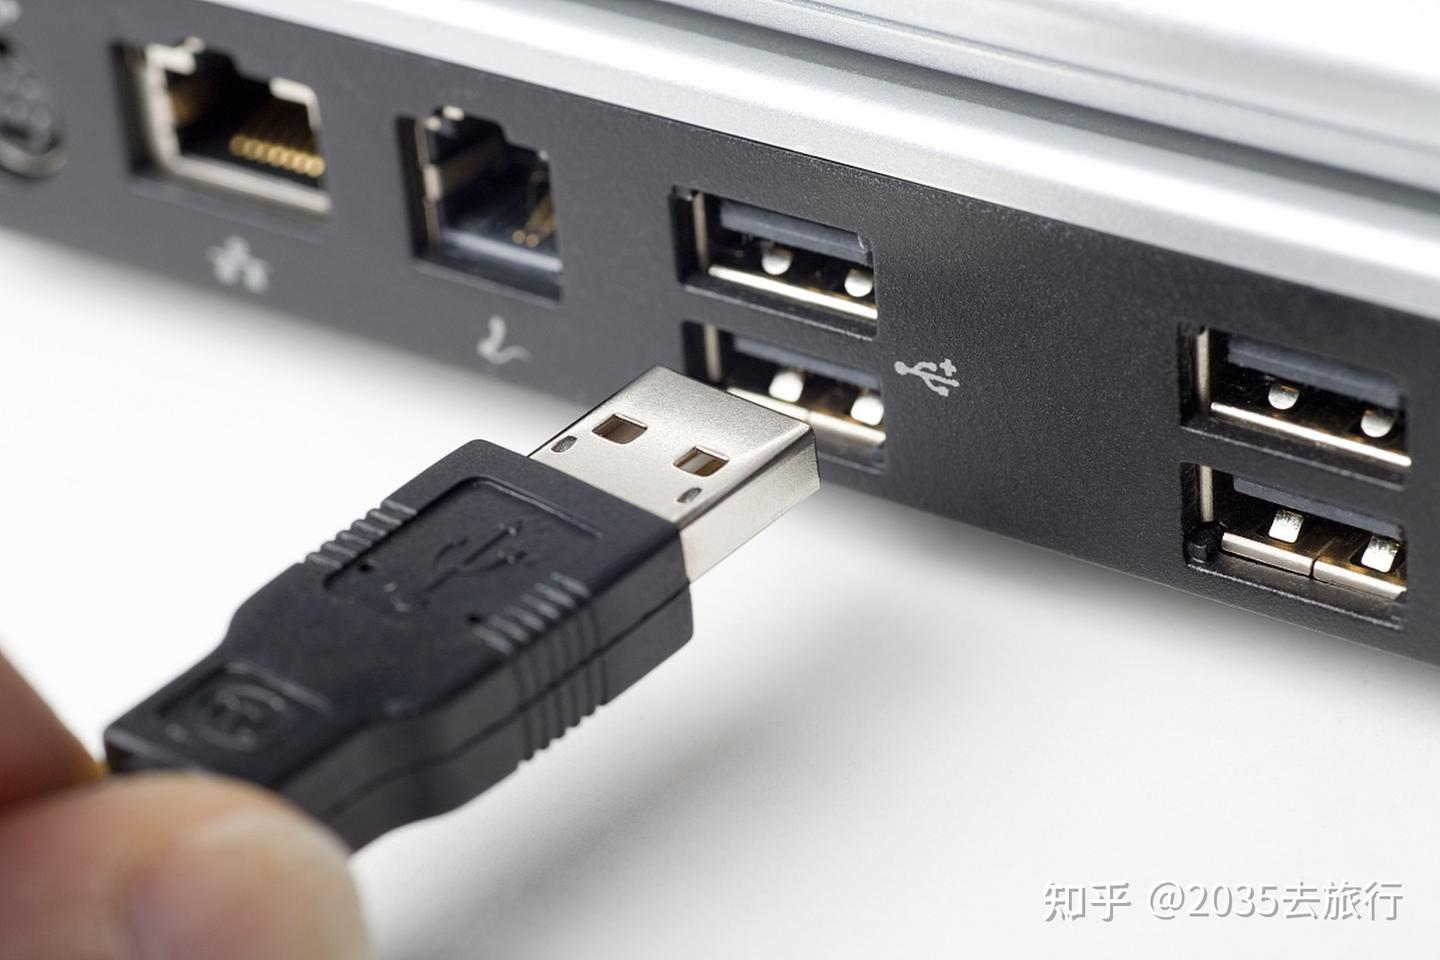
 UVC基础知识 一、什么是UVC?UVC,全称为:USB video(device) class,是微软与另外几家设备厂商联合推出的为USB视频捕获设备定义的协议标准,目前已成为USB org标准之一。UVC是USB Implementers Forum(USB-IF)制定的USB视频设备类标准协议,旨在统一USB视频设备的软硬件接口规范,实现跨平台的即插即用功能。当前主流版本为UVC 1.5。USB接口二、UVC的核心设计思想UVC将复杂的视频设备抽象为标准化的功能拓扑结构,通过定义统一的控制接口和数据传输格式,让操作系统无需安装专用驱动即可识别和使用设备。这种设计大大简化了驱动开发,降低了兼容性和维护成本UVC Camera三、UVC的协议架构:双接口模型UVC规范明确要求设备必须具备两种关键接口,两者配合完成完整功能:VC接口(Video Control Interface)功能:负责设备配置和属性控制控制对象:亮度、对比度、曝光、焦距、缩放等摄像头参数传输方式:通过USB控制传输(Control Transfer)实现VS接口(Video Stream Interface)功能:负责实时视频流传输数据内容:编码后的视频帧数据传输方式:采用等时传输(Isochronous)或批量传输(Bulk)四、拓扑结构抽象UVC将视频设备抽象为以下标准化模块,形成清晰的处理流水线:传感器数据 → [输入端子(IT)] → [选择器单元(SU)] → [处理单元(PU)] → [输出端子(OT)] → USB端点输入端子(IT):数据流入的接收器,可接传感器或其他视频源选择器单元(SU):多路输入源选择(如切换前后摄像头)处理单元(PU):图像处理流水线,执行亮度、对比度、白平衡等调节输出端子(OT):数据流出终点,对接USB端点扩展单元(XU):厂商自定义功能接口(如人脸识别、自动对焦)UVC Camera五、视频格式与编码支持UVC协议支持多种格式以适应不同带宽和应用场景:格式类型 具体格式 特点与应用未压缩格式 YUV422(YUY2)、NV12 画质无损,带宽要求高,适合USB 3.0压缩格式 MJPEG、H.264、H.265 节省带宽,适合USB 2.0高清传输数字视频 DV格式(SD-DV/HD-DV) 专业摄像设备YUV422格式是UVC的基础未压缩格式,每个像素平均占用2字节,通过共享色度分量节省空间。六、传输机制与带宽USB 2.0模式等时传输:保证带宽和实时性,适合视频流批量传输:高可靠性但无带宽保障,用于控制命令最大速率:480Mbps(High-speed)最大包大小:1024字节USB 3.0模式超高速传输:5Gbps带宽,支持4K@30fps传输单位:125微秒(USB 2.0为1毫秒)七、即插即用实现原理主机枚举流程设备接入:USB控制器检测新设备描述符读取:获取设备、配置、接口、端点描述符能力协商:通过控制传输协商视频格式、分辨率、帧率驱动加载:操作系统内置UVC驱动自动匹配流通道建立:启动VS接口的等时传输通道跨平台兼容性主流操作系统均内置UVC驱动支持:Windows:XP SP2及以后版本Linux:内核2.4.6及以后版本(主流发行版已集成)macOS:10.5及以后版本Android:4.0+(需OTG支持)嵌入式系统:Armino等RTOS框架支持UVC 1.1/1.5八、扩展与定制化XU扩展单元标准UVC仅支持有限控制命令。为满足特定需求,协议引入XU(Extended Unit)机制:通过唯一Selector值标识自定义命令使用SET_CUR/GET_CUR进行数据交互数据格式完全由开发者定义例如,可实现人脸识别、自动对焦算法、红外切换等非标功能,而无需修改核心驱动九、应用场景UVC设备广泛应用于:消费电子:网络摄像头、USB相机工业视觉:UVC工业相机、自动化检测医疗影像:内窥镜、显微镜数字化安防监控:USB摄像头即插即用方案移动设备:Android OTG外接摄像头十、技术优势总结优势:1、即插即用:标准化驱动+自动枚举2、跨平台兼容:统一协议栈,操作系统原生支持3、功能丰富:CT/PU单元控制+ XU扩展机制4、实时性保障:等时传输+带宽预留机制5、成本低廉:省略驱动开发,降低维护成本十一、开发与调试在嵌入式Linux中,可通过以下工具调试UVC设备:v4l2-ctl:查询和设置设备参数lsusb -t:查看USB拓扑和带宽分配usbmon:抓取USB数据包分析ffplay/gstreamer:实时预览视频流查看UVC设备能力v4l2-ctl -d /dev/video0 --list-formats-ext启动视频采集v4l2-ctl --set-fmt-video=width=1280,height=720,pixelformat=MJPG --stream-mmap十二、小结:UVC协议的极致在于:用标准化抽象屏蔽硬件差异,用分层设计解耦控制与数据,用扩展机制平衡通用与定制。这种设计哲学体现了"简单即强大"的工程智慧,也是我们"做到极致"理念在协议设计领域的绝佳范例。
-
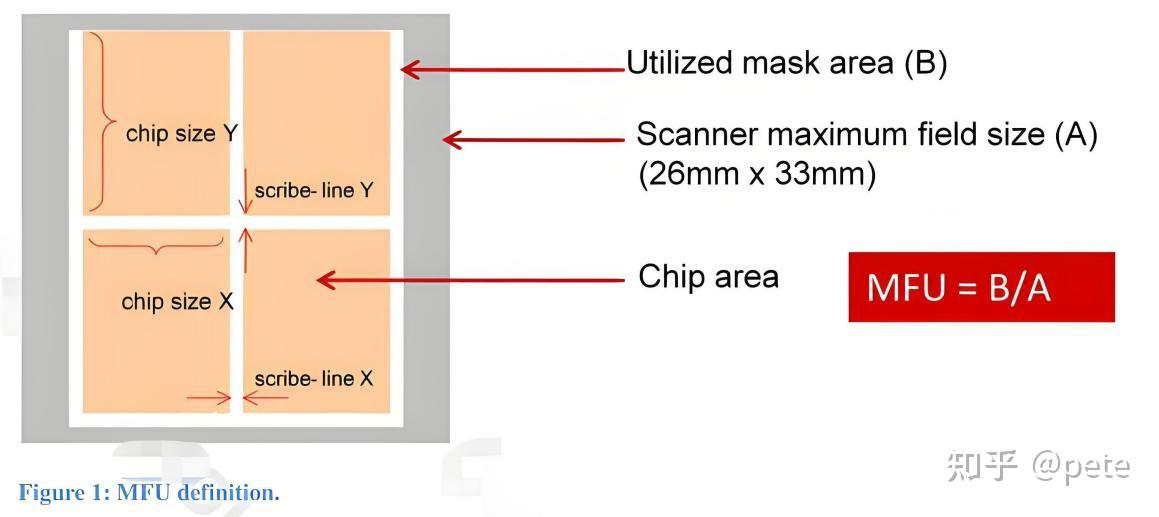
芯片MFU与GDPW 在芯片设计的宏大叙事中,我们往往聚焦于纳米级的制程竞赛、百亿级的晶体管数量和 GHz 级别的频率提升。但在晶圆厂(Foundry)的生产线上,有一群工程师每天都在思考一个看似朴素却极其关键的问题:如何在一张26mm×33mm的"小纸片"上,挤出最大的经济效益? 这张"小纸片",就是光刻掩模版(Mask)的最大曝光区域;而衡量其利用效率的核心指标,正是MFU(Mask Field Utilization,掩模场利用率)和GDPW(Gross Die Per Wafer,单片晶圆裸片数)。它们不直接决定芯片的性能,却深刻影响着每一颗芯片的出厂成本,是连接设计与制造的"隐形经济学"。一、MFU:掩模版上的"空间博弈" 1.1 什么是MFU? MFU,全称 Mask Field Utilization,定义为有效掩模面积与最大曝光镜头面积的比例。通俗地说,它衡量的是:在光刻机一次曝光能覆盖的26mm×33mm(即858mm²)的矩形区域内,有多少比例被真正用于"印刷"芯片。 计算公式为: MFU = (N × Die面积 + Scribe Line面积) / (26mm × 33mm) 其中,N 是一张掩模版上能排列的芯片(Die)数量,Scribe Line(划片槽)是芯片之间用于切割的空白区域,Seal Ring(密封环)则是保护芯片边缘的结构。台积电(TSMC)通常称之为MFU,而联电(UMC)则使用RUR(Reticle Usage Ratio)这一术语,二者本质相同。 1.2 为什么MFU如此重要? 光刻是芯片制造中最昂贵、最耗时的工序之一。现代扫描式光刻机(Scanner)在一次曝光中,除了实际的扫描时间,还需要预扫描(Pre-scan)和过扫描(Over-scan)的机械运动时间。这意味着,无论掩模版上有没有芯片图案,光刻机都要完成一整套机械动作。 MFU越低,浪费的时间就越多。 如果MFU只有50%,意味着光刻机有一半的机械运动是在"空转";而如果MFU达到95%,每次曝光都能物尽其用,整体曝光次数大幅减少,生产效率和成本优势立竿见影。 正因如此,主流Foundry通常要求MFU 大于80%。低于这一门槛,晶圆厂可能会收取额外费用;而高于特定阈值(如85%、90%、95%),则可能获得代工折扣。据行业资料,TSMC的折扣政策大致如下:MFU≥95%可获3%折扣,90%-95%获2%折扣,85%-90%获1%折扣。对于动辄数千万美元的流片费用,几个百分点的折扣绝非小数目。二、GDPW:晶圆上的"产量密码" 2.1 什么是GDPW? GDPW,即 Gross Die Per Wafer,指单片12英寸(300mm直径)晶圆上能够产出的完整裸片数量。它是衡量晶圆产出效率最直接的指标,也是芯片成本核算的基础。 GDPW的计算看似简单——用晶圆面积除以单颗Die面积——实则不然。因为晶圆是圆形的,边缘区域会存在大量无法形成完整芯片的"边角料";同时,Die的排列方式、Scribe Line的宽度、Notch(定位槽)的位置都会影响最终可收获的完整Die数量。 2.2 MFU与GDPW的"微妙关系" 一个常见的误解是:MFU高,GDPW就一定高。 事实并非如此。 举个经典例子:假设一颗Die面积为324mm²(18mm×18mm)。在26mm×33mm的掩模版上,只能放下1颗Die,MFU约为37.8%。如果我们保持面积不变,将Die尺寸调整为12mm×27mm,掩模版上可以放下2颗Die,MFU跃升至约75.6%。 但GDPW呢?由于晶圆总面积固定,单颗Die面积不变,理论上总Die数几乎不变。改变的是光刻效率,而非晶圆利用率。正如台积电的Die Size Advisor工具所揭示的:调整Die形状可以显著提升MFU,但对GDPW几乎没有影响。 这就引出了一个深刻的设计洞察:芯片Die Size并非越小越好。如果通过微调Die尺寸(哪怕增加一点点面积),能将MFU从79%提升到81%,跨越80%的门槛,所获得的代工折扣可能远超多消耗的那点硅片成本。这是一种"以面积换成本"的逆向思维。三、从理论到实践:如何在设计中优化MFU? 3.1 最佳优化时机:越早越好 根据TSMC的设计指南,MFU的优化应贯穿芯片设计的三个阶段: 阶段一:产品定义期(Product Definition) 这是最关键的阶段。此时芯片功能、尺寸、封装和引脚尚未固化,设计团队拥有最大的灵活性来调整Die的X/Y长宽比。通过Foundry提供的在线MFU/GDPW计算器,可以快速评估不同尺寸组合下的MFU值,选择最优方案并写入芯片规格书。 阶段二:芯片实现期(RTL到物理设计) 随着设计深入,Die尺寸可能因IP面积、时序收敛、电源规划等因素发生变化。此时应持续使用MFU Advisor工具,重新计算并调整纵横比,确保MFU始终处于高位。 阶段三:Tapeout前 在最终流片前,Foundry会根据实际的Scribe Line宽度和Seal Ring尺寸,计算最终的MFU值,并进行DRC检查。TSMC甚至在DRC Rule Deck中专门增加了MFU检查规则,确保设计符合制造要求。 3.2 实战技巧:如何"挤"出更高的MFU? 技巧一:巧用旋转与纵横比 掩模版是矩形(26mm×33mm),而Die可能是方形或矩形。通过旋转Die 90度,或微调长宽比,往往能产生截然不同的排列效果。例如,在2×2和2×3布局的边界尺寸附近,微小的纵横比变化可能导致MFU的巨大跃升。TSMC的在线工具通常会同时给出原方向和旋转90°的MFU值,取大者用之。 技巧二:IP选型与方向规划 在Floorplan阶段,优先选择方形的数字模块和IP。对于不可避免的矩形IP,最好提供水平和垂直两种方向版本,以便在布局时灵活调整,匹配最优的Die形状。对于I/O受限的设计,可能需要调整I/O和接口IP的排布;对于Core受限的设计,则需调整IP和Block的大小。 技巧三:避开"陷阱尺寸" 某些Die尺寸恰好处于MFU的"断崖边界"——例如,略大于掩模版半宽或三分之一的尺寸。此时,哪怕只缩小几十微米,就可能从1颗/掩模版跃升为2颗/掩模版,MFU翻倍。设计时应主动避开这些低效区间,而非被动接受。四、前沿挑战:High-NA EUV时代的MFU变局 当前,半导体行业正迈入High-NA EUV光刻时代。ASML的新一代0.55 High-NA EUV光刻机采用了变形透镜,导致X和Y方向的缩小倍率不同,视场尺寸从26mm×33mm减半至26mm×16.5mm(约429mm²)。 这意味着,单颗芯片的最大面积从858mm²骤降至约445mm²。英伟达A100的GA100核心面积高达826mm²,在当前技术下尚能单片制造;但在High-NA时代,这类"大芯片"将被迫采用Chiplet(芯粒)或多芯片封装方案。 视场减半直接冲击了MFU的计算基准。掩模版上的"可用画布"变小,对Die尺寸的优化提出了更严苛的要求。英特尔CEO帕特·基辛格已公开表示,正与ASML探讨采用6英寸×12英寸的大型掩模版(现有为6英寸×6英寸),以恢复原有的视场大小。但这涉及整个掩模供应链的重构,短期内难以实现。 对于芯片设计师而言,High-NA时代的MFU优化将更加精细——在更小的"画布"上排布Die,每一分空间的浪费都意味着更昂贵的曝光成本。Chiplet架构的兴起,某种程度上也是对这一物理限制的回应:将大芯片拆分为多个小Die,每个Die都能获得更高的MFU,再通过先进封装互联,以系统级方案延续摩尔定律的经济效益。五、结语:细节之处见真章 MFU和GDPW,这两个看似枯燥的缩写,实则是半导体产业链中设计与制造协同优化的缩影。它们提醒我们:芯片设计不仅是架构的艺术、电路的魔法,更是空间的几何、成本的算术。 对于数字后端工程师和物理设计(PV)人员而言,在Floorplan阶段多花一小时调整Die尺寸,可能在量产阶段节省数百万美元的代工费用。正如一位资深工程师所言:"一个好的PR(Place & Route)工程师,首先要是一个好的PV(Physical Verification)工程师。"而MFU/GDPW的考量,正是这种跨界思维的起点。 在先进制程成本飙升、晶圆厂产能紧张的今天,"向掩模版要效率"已成为芯片设计不可或缺的一环。下一次当你面对Floorplan中的Die Size选择时,不妨多问自己一句:这个尺寸,能让MFU跨过下一个折扣门槛吗?
-
AI专题二十一:AI专业术语汇总(1) 今天这篇文章,我用最人话的类比,零门槛讲透AI圈最核心的8个概念:LLM、Prompt、Context、RAG、Skills、MCP、Harness、Agent。不仅让你懂「是什么」,更让你懂「怎么用」「怎么组合」「怎么落地」,看完这篇,你对AI的理解,会超过90%的碎片化学习者。一、底层核心:所有AI应用的根,都是LLMLLM(Large Language Model,大语言模型),是整个AI世界的大脑核心。你可以把它理解成一个读了万亿页人类文本、精通语言逻辑、推理、创作的超级学霸。它天生就能听懂人话、写文案、写代码、做逻辑推导,是所有AI功能的基础底座——我们后面讲的所有概念,都是围绕这个大脑做的增强、扩展和管控。但必须先讲透它的天生短板,这也是后面所有概念存在的意义:知识有截止日期,不知道训练完成之后的新信息;容易出现「幻觉」,一本正经地编造不存在的内容;没有专属知识,不懂你公司的内部制度、你的产品详情、你的个人数据;没法直接操作外部工具,不能帮你查数据库、拉取后台数据、操作电脑文件;短期记忆有限,聊多了就会忘记前面的内容,答非所问。新手避坑:别把LLM等同于AI的全部。它只是核心零件,不是完整的解决方案。就像汽车发动机再强,没有方向盘、轮胎、刹车,也没法上路。二、和AI对话的基本功:Prompt & Context,90%的人都用错了这两个是和LLM大脑交互的基础,也是AI学习者的第一门必修课,更是最容易被轻视、用错的环节。Prompt(提示词):和AI对话的「精准指令语言」你可以把它理解成:给超级学霸的提问方式。同样一个需求,你问「帮我写个文案」,和「帮我写一篇面向30岁职场女性的抗老护肤品种草文案,小红书风格,800字以内,要有痛点、成分解析、真实使用感受,结尾加互动话题」,得到的结果天差地别。Prompt的核心,不是网上传的「玄学咒语」,也不是越长越好,而是把你的需求,拆成LLM能精准理解、严格执行的指令,核心四要素:明确需求、限定边界、给出范式、对齐预期。新手避坑:别沉迷于收藏各种Prompt模板,模板只能解决单一问题。真正的核心能力,是学会拆解需求,用精准的语言对齐AI的输出,这是所有AI操作的基本功。Context(上下文):LLM的「短期记忆」你可以把它理解成:学霸和你对话时,能同时记住的内容上限。你跟AI说「我是做ToB软件销售的」,后面问「怎么给客户做产品演示」,AI会结合你销售的身份给出答案,这就是Context在起作用。但如果你们连续聊了几百句,超出了它的记忆上限,它就会忘记你最开始说的身份,给出泛泛的回答。Context的核心价值,是决定了AI能不能连贯对话、基于长文本完成任务——比如你给它100页的合同让它审核,给它几十万字的小说让它写续写,前提都是它的Context窗口能装下这些内容。新手避坑:不是Context窗口越大越好。窗口太大,会导致AI推理变慢、注意力分散,甚至抓不住核心信息。真正的高阶能力,是学会管理Context,只给AI传递最关键的信息,过滤无效内容,这也是解决AI答非所问的核心方法。三、给AI装外挂:RAG,解决LLM的天生短板RAG(Retrieval Augmented Generation,检索增强生成),是给LLM大脑装的专属知识库+外挂硬盘,也是新手最容易落地的进阶技能。前面我们说过,LLM的核心痛点是知识过时、容易幻觉、没有专属数据。而RAG,就是专门解决这个问题的。你可以这么理解:学霸虽然读书多,但不知道你公司的内部制度、你家店铺的产品详情、你最新的项目文档、你个人的笔记资料。这时候你给它装一个RAG,就相当于给它配了一个专属私人图书馆。你提问的时候,它会先去这个图书馆里,检索和你问题相关的精准资料,再结合自己的语言能力和推理能力回答问题,从根源上避免幻觉,同时能用上你的专属数据。它的核心逻辑非常简单,只有四步:把你的文档、资料、笔记,拆成AI能处理的小片段;把这些片段转换成向量,存储到向量数据库里;你提问时,AI先去数据库里,检索和问题最相关的内容;把检索到的内容和你的问题一起,交给LLM生成精准答案。新手避坑:RAG不是简单的「把文档复制粘贴给AI」。直接丢长文档给AI,会超出Context上限,也会让AI抓不住重点。RAG的核心是「精准检索」,只给AI传递和问题相关的内容,这也是它和直接喂文档的本质区别。不管是做个人专属AI笔记助手、企业内部知识库,还是行业客服AI,RAG都是必备的核心技术,也是新手从「用AI」到「做AI工具」的第一步。四、让AI变专业:Skills,把重复工作变成一键搞定的技能包Skills(技能),是给LLM提前练好的专项本领包,是把AI从「聊天工具」变成「效率工具」的关键。你可以这么理解:学霸虽然全能,但你每次都让它从零开始写SQL、算Excel函数、审核合同、写固定格式的周报,不仅效率低,还容易每次输出的标准不统一。而Skills,就是你提前给学霸封装好的、可复用的、带完整流程的专项技能。比如「SQL生成与查询技能」,你把「用户需求→生成SQL→语法校验→执行查询→结果整理」整个流程,提前封装成一个固定的技能包,以后用户只要说一句话,AI就能自动走完整个流程,不用你每次都重新教。Skills和Prompt的核心区别:• Prompt是单次指令,解决一个具体问题;• Skills是封装好的、带逻辑、带流程、可复用的专项能力,解决一类重复问题。比如你是电商运营,你可以把「竞品标题分析」「直播话术生成」「订单数据对账」这些每天都要做的重复工作,分别封装成不同的Skills,以后只要一键调用,AI就能按固定标准、固定流程完成,效率直接拉满。五、给AI接手脚:MCP,让AI操控整个数字世界的通用桥梁MCP(Model Context Protocol,模型上下文协议),是2024年爆火的AI基础设施,也是让AI从「只能聊天」变成「能做事」的核心桥梁。先讲一个痛点:LLM本身是个纯语言模型,它没法直接操作你的电脑文件、查你的本地数据库、调用企业微信API、拉取直播后台数据、控制你的办公软件。之前要实现这些功能,你必须给每个工具、每个软件,单独写定制化的对接代码,10个工具就要写10套对接逻辑,非常麻烦,新手根本搞不定。而MCP,就是一套通用的翻译协议。你可以把它理解成:给所有软件、工具、系统、API,都装了一个统一的翻译器。只要支持MCP协议,LLM不用单独写代码对接,就能直接调用这些工具,就像人长了手脚,能直接操控整个数字世界。举个例子:之前你要让AI帮你查数据库里的销售数据,还要发到企业微信群里,你需要分别写数据库对接代码、企业微信API对接代码,还要写逻辑让AI调用。现在只要数据库和企业微信都支持MCP,AI一句话就能自动完成,不用写一行代码。新手避坑:不用深究MCP的底层协议细节,你只要知道,它是一套通用的工具对接标准,能让你零代码给AI加上各种工具能力,是AI Agent落地的核心基础设施。现在主流的AI框架都已经支持MCP,新手直接用就好。六、给AI装刹车:Harness,让AI敢用在生产环境的安全中枢Harness(大模型管控框架),是给AI装的安全刹车+管理中枢,是AI能从「玩具」变成「企业级生产工具」的核心前提。你可以这么理解:你让一个学霸帮你管公司的业务、处理客户敏感数据、操作财务系统、执行数据库指令,你肯定要给它定死规矩:什么能做、什么绝对不能做、数据不能泄露、操作不能越权、出了问题要能追溯、有风险的操作要提前拦截。Harness,就是专门干这个的。它是一套完整的管控框架,核心负责这几件事:权限管控:谁能调用AI、能调用什么功能、能访问什么数据,都由它说了算;安全审计:所有AI的操作、对话、调用记录,全程留痕,可追溯、可审计;合规校验:自动拦截违规提问、敏感内容输出,符合数据安全、行业合规要求;风险兜底:对高风险操作(比如删除数据库数据、批量发送消息)进行二次校验,不符合规则直接拦截;流量管控:控制AI的调用频率、成本上限,避免超量调用产生高额费用。新手避坑:很多人做AI应用,只关注功能好不好用,完全忽略了管控和安全。尤其是企业级应用,没有Harness的AI,就像一辆没有刹车的汽车,跑得越快,风险越大。哪怕是个人用的AI工具,也要有基础的管控逻辑,避免误操作导致数据丢失、泄露。七、最终形态:Agent,把所有零件拼成一个真正的智能机器人Agent(智能体),不是一个单一的技术,而是把上面所有概念,整合起来的完整AI机器人,也是当前AI应用的最终形态。我们来做一个完整的类比,你瞬间就能懂:• LLM是大脑,负责思考、推理、决策;• Prompt是沟通语言,负责精准传递指令;• Context是短期记忆,负责记住当前的任务和对话;• RAG是长期记忆/专属知识库,负责存储专属数据和资料;• Skills是专项本领,负责高效完成固定类型的任务;• MCP是手脚,负责调用外部工具、操作系统、软件;• Harness是安全中枢,负责全程管控、规避风险。把这些所有的零件,完整地组装起来,就是一个Agent。它能听懂你的最终目标,自主拆解任务,自主规划执行步骤,自己调用知识库找资料,自己用技能完成子任务,自己调用工具操作外部系统,全程自己纠错、自己优化,直到完成你的目标。举个最直观的例子,你跟电商运营Agent说:「帮我整理一下上周的直播带货数据,生成复盘报告,同步给运营团队」,它会自动完成这一整套流程:理解你的目标,拆解成「拉取数据→数据分析→生成报告→同步团队」4个子任务;通过MCP协议,调用直播后台的API,拉取上周的全量直播数据;调用「直播数据分析」Skill,对数据进行清洗、计算、分析,找出亮点和问题;从RAG知识库中,调取公司的复盘报告模板和过往优秀案例;基于Context里的你的需求,生成符合公司标准的复盘报告;再通过MCP调用企业微信API,把报告发到运营团队群里;全程由Harness管控,校验数据权限、操作合规性,避免敏感数据泄露,确保不会出现误操作。整个过程,完全不用你插手,这就是Agent的真正魅力——它不是一个只会聊天的机器人,而是一个能帮你自主完成完整任务的「数字员工」。八、新手必看:从入门到落地的正确路径,别再瞎学了看到这里,你已经搞懂了8个核心概念的逻辑和关系,最后给所有AI学习者,一个绝对不会踩坑的入门路径,小步快跑,快速落地:第一步:打牢基本功,别上来就搞Agent先把LLM的基础逻辑搞懂,花1-2周时间,练熟Prompt编写和Context管理。这是所有AI操作的基本功,基本功不牢,后面全是白搭。第二步:小步快跑,从RAG入手快速落地先做一个自己的专属知识库AI,比如个人笔记助手、行业资料知识库、电子书问答助手。这是最容易落地、最容易出成果的进阶项目,能快速建立你的信心,也能真正解决你自己的痛点。第三步:逐步进阶,封装自己的Skills把你日常工作中,重复度最高的工作,比如写周报、查数据、审核文档、写固定格式的文案,封装成可复用的AI Skills,实现工作自动化,真正用AI提升自己的效率。第四步:整合落地,做一个属于自己的Agent学习MCP和基础的管控逻辑,把前面的RAG、Skills、工具调用整合起来,做一个属于自己的Agent,比如个人办公助理、私域运营助手、客服机器人,真正从「用AI」,变成「造AI工具」。
-
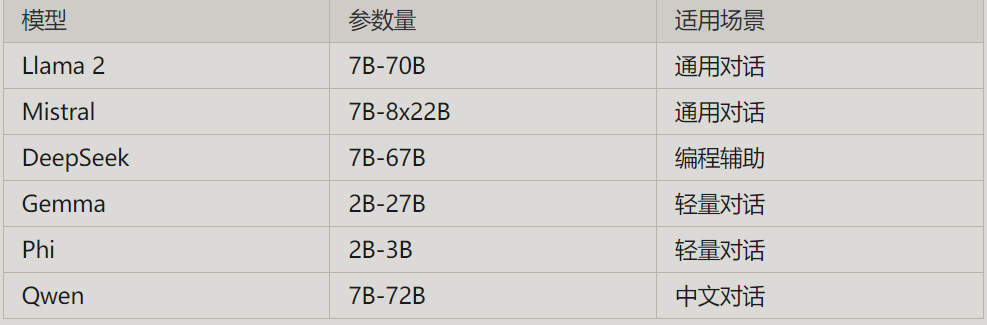
AI专题二十:大模型本地部署工具 1. ollamaOllama 是一款开源的大模型本地部署工具,GitHub Star 数超过 80K。它提供了简单的命令行界面来下载、运行和管理大模型,同时支持通过 API 调用模型。Ollama 的核心特点:简单易用:一行命令即可运行模型模型库丰富:支持 Llama 2、Mistral、DeepSeek、Gemma 等跨平台:支持 macOS、Windows、LinuxAPI 支持:提供 RESTful API 集成GPU 加速:自动利用 GPU 加速推理轻量高效:资源占用优化Ollama 模型库涵盖多种类型的模型:硬件架构amd64:适用于 Intel/AMD x86_64 架构的 CPU(普通台式机、服务器)。arm64:适用于 ARM 架构的 CPU(如树莓派、苹果 M 系列芯片、高通骁龙)。显卡加速支持无后缀(如 ollama-linux-amd64.tgz):仅支持 CPU 推理,无 GPU 加速。-rocm后缀(如 ollama-linux-amd64-rocm.tgz):支持 AMD 显卡加速(需兼容 ROCm 驱动)。-jetpack后缀(如 ollama-linux-arm64-jetpack6.tgz):专为 NVIDIA Jetson 嵌入式设备优化(如 Jetson Nano/Orin)。操作系统.tgz:Linux/macOS 系统压缩包(需手动解压安装)。.zip:Windows 系统压缩包(需解压后运行)2. LM studioLM Studio 是一款支持在本地运行 AI 大模型的工具,支持 Mac、Linux 和 Windows 全平台。和 Ollama 不同,LM Studio 自带一个漂亮的图形界面,入门门槛极低——下载、搜索模型、点击运行,三步搞定。目前支持的主流模型相当多:gpt-oss、Qwen3、Gemma 3、DeepSeek 等等,基本上 Hugging Face 上热门的 GGUF 和 MLX 模型都能跑。1). 本地模型管理一键下载:内置 Hugging Face 模型库浏览器,可直接搜索并下载数千种开源模型(如 Llama、Mistral、Qwen、DeepSeek 等)多格式支持:兼容 GGUF、Safetensors 等主流格式版本管理:轻松切换不同模型版本和量化精度(Q4、Q5、Q8 等)2). 聊天与推理界面可视化聊天:提供类似 ChatGPT 的对话界面,支持多轮对话参数调节:实时调整 Temperature、Top-p、上下文长度等推理参数系统提示词:可自定义 System 来设定 AI 角色和行为3). 开发者工具本地 API 服务器:提供 OpenAI 兼容的 REST API(http://localhost:1234/v1),方便集成到第三方应用模型信息查看:详细展示模型架构、词汇表大小、上下文窗口等元数据4). 硬件优化自动硬件检测:智能识别 NVIDIA/AMD/Intel 显卡,自动启用 GPU 加速CPU 回退:无独显时自动使用 CPU 推理,支持 AVX2 等指令集优化LM studio有哪些技术优势?LM Studio 底层基于 llama.cpp 高性能运行时,并针对 NVIDIA RTX GPU 做了深度优化。通过 CUDA 12.8 集成,支持 CUDA Graph 和 Flash Attention,可在 RTX GPU 上实现最高 35% 的吞吐量提升。软件自动检测并启用 GPU 加速(CUDA/Metal),用户也可手动调整 GPU 卸载比例和 CPU 线程数以平衡性能。3.AnythingLLMAnythingLLM 是开源免费且支持多模态交互的全栈 AI 客户端。AnythingLLM支持文本、图像和音频等多种输入方式,将任何文档或内容转化为上下文,供各种语言模型(LLM)在对话中使用。AnythingLLM支持本地运行和远程部署,提供多用户管理、工作区隔离、丰富的文档格式支持以及强大的 API 集成。所有数据默认存储在本地,确保隐私安全。AnythingLLM支持多种流行的 LLM 和向量数据库,适合个人用户、开发者和企业使用。AnythingLLMAnythingLLM的主要功能多模态交互:支持文本、图像和音频等多种输入方式,提供更丰富的交互体验。文档处理与上下文管理:将文档划分为独立的“工作区”,支持多种格式(如PDF、TXT、DOCX等),保持上下文隔离,确保对话的清晰性。多用户支持与权限管理:Docker版本支持多用户实例,管理员能控制用户权限,适合团队协作。AI代理与工具集成:支持在工作区内运行AI代理,执行网页浏览、代码运行等任务,扩展应用的功能。本地部署与隐私保护:默认情况下,所有数据(包括模型、文档和聊天记录)存储在本地,确保隐私和数据安全。强大的API支持:提供完整的开发者API,方便用户进行自定义开发和集成。云部署就绪:支持多种云平台(如AWS、GCP等),方便用户根据需求进行远程部署。AnythingLLM的项目地址项目官网:https://anythingllm.com/GitHub仓库:https://github.com/Mintplex-Labs/anything-llmAI工具集获取AnythingLLM安装包,扫码关注回复:AnythingLLMAnythingLLM的技术原理前端:用ViteJS和React构建,提供简洁易用的用户界面,支持拖拽上传文档等功能。后端:基于NodeJS和Express,负责处理用户交互、文档解析、向量数据库管理及与LLM的通信。文档处理:基于NodeJS服务器解析和处理上传的文档,将其转化为向量嵌入,存储在向量数据库中。向量数据库:用LanceDB等向量数据库,将文档内容转化为向量嵌入,便于在对话中快速检索相关上下文。LLM集成:支持多种开源和商业LLM(如OpenAI、Hugging Face等),用户根据需求选择合适的模型。AI代理:在工作区内运行AI代理,代理能执行各种任务(如网页浏览、代码执行等),扩展应用的功能。AnythingLLM支持的模型和数据库大型语言模型(LLMs):支持多种开源和闭源模型,如 OpenAI、Google Gemini Pro、Hugging Face 等。嵌入模型:支持 AnythingLLM 原生嵌入器、OpenAI 等。语音转文字和文字转语音:支持多种语音模型,包括 OpenAI 和 ElevenLabs。向量数据库:支持 LanceDB、Pinecone、Chroma 等。AnythingLLM的使用和部署桌面版:系统要求:操作系统:支持 Windows、MacOS 和 Linux。硬件要求:建议至少 8GB 内存,推荐 16GB 或更高。下载和安装:访问 AnythingLLM 官方网站。根据操作系统选择对应的安装包。安装程序:Windows:双击安装程序并按照提示完成安装。MacOS:双击 DMG 文件,将应用程序拖入“应用程序”文件夹。Linux:基于包管理器安装 DEB 或 RPM 文件。启动应用:安装完成后,打开 AnythingLLM 应用。初始化设置:选择模型:首次启动时,选择一个语言模型(LLM)。配置向量数据库:选择默认的向量数据库(如 LanceDB)或配置其他支持的数据库。创建工作区:点击“新建工作区”,为项目或文档创建一个独立的工作区。上传文档(如 PDF、TXT、DOCX 等),应用自动解析并生成向量嵌入,存储在向量数据库中。开始对话:在工作区内输入问题或指令,应用根据上传的文档内容生成智能回答。支持多模态交互,上传图片或音频文件,应用根据内容进行处理。Docker 版:系统要求:操作系统:支持 Linux、Windows(WSL2)和 MacOS。硬件要求:建议至少 8GB 内存,推荐 16GB 或更高。Docker 环境:需要安装 Docker 和 Docker Compose。部署步骤:访问 GitHub 仓库:前往 AnythingLLM GitHub 仓库。4 DifyDify 是一个 开源 LLM 应用开发平台(Low-code/No-code),目标是让开发者和团队更快地构建和运营基于大语言模型(LLM)的应用。它的名字来自 “Do It For You”。特点:🛠️ 低代码/可视化:支持在 Web 界面拖拽配置工作流。🧩 即插即用:支持各种大模型(OpenAI、Claude、DeepSeek、Llama、Ollama 等)。🖥️ 开发者友好:支持 Python/JS SDK,API 接口调用。📊 监控 & 调优:提供日志、评测、向量库管理、数据观测等功能。Dify 可以做什么?AI 助手:客服机器人、个人助理。知识库问答:上传 PDF、文档,接入企业知识库。多模型编排:结合不同大模型完成复杂任务。Agent 工作流:让 AI 具备工具调用、Web 搜索、数据库查询能力。RAG 应用:Retrieval-Augmented Generation,结合向量库问答。对NVIDIA GPU的支持AnythingLLM对NVIDIA GPU的支持最为成熟和全面。这主要得益于其底层依赖的Ollama框架和CUDA生态系统的完善支持。NVIDIA GPU可以通过CUDA Toolkit实现硬件加速,并且AnythingLLM的开发者针对NVIDIA的Tensor Core进行了专门优化,能够显著提升本地大语言模型和RAG工作流的响应速度。在实际部署中,用户只需确保已安装正确的NVIDIA驱动和CUDA工具包,AnythingLLM便可自动利用GPU进行加速。1[10]对AMD GPU的支持AnythingLLM理论上支持AMD GPU,但其支持程度和易用性通常不如NVIDIA。实现支持的关键在于AMD GPU需要安装ROCm(Radeon Open Compute)平台,这是一个对标CUDA的开源计算平台。用户必须确保其AMD显卡型号在ROCm的支持列表内,并正确安装相应的驱动程序。与NVIDIA的“开箱即用”体验相比,使用AMD GPU可能需要更多的手动配置和环境调优,且在不同操作系统下的支持状态可能存在差异Dify 的核心功能Dify 核心组件概览Dify 的架构主要由 Web Frontend、API Backend、Worker 以及多个核心子系统构成,这些组件通过数据库、缓存和消息队列进行连接与协作。Web Frontend作用: 提供用户与 Dify 平台交互的图形化界面。开发者在这里创建、管理、调试和部署他们的 AI 应用(如聊天机器人、自动化工作流等)。所有操作,包括编排 Workflow、上传文件构建知识库、查看对话历史等,都通过它完成。技术: 通常基于现代框架如 Next.js 和 React 构建。API Backend作用: 这是 Dify 的核心大脑和交通枢纽。它承担了以下关键职责:请求处理: 接收来自 Web Frontend 或第三方集成的所有 RESTful API 请求。业务逻辑: 执行应用程序的核心逻辑,例如管理对话、协调工作流执行、处理检索增强生成(RAG)请求等。系统协调: 它本身不处理所有任务,而是作为协调者,调用其他子系统(如 Model Provider System, RAG System)并与其他基础设施(数据库、缓存)交互来完成请求。身份验证与授权: 验证用户身份和权限。技术: 通常使用 Python 框架(如 Flask 或 Django)构建。Celery Worker作用: 专门处理异步和耗时任务的后台进程。它的存在是为了避免长时间运行的任务阻塞 API Backend 的即时响应。典型任务: 为上传的文档构建索引。这个过程涉及读取文件、文本分块、生成向量嵌入(Embeddings)并写入向量数据库,非常消耗资源和时间,必须异步处理。关系: 通过消息队列(如 Redis)从 API Backend 接收任务。处理完成后,会更新数据库中的任务状态。核心子系统 (Core Subsystems)这些子系统是 API Backend 内部的逻辑模块,是实现不同功能的核心。Conversation System作用: 管理用户与 AI 应用之间的所有对话交互。负责创建对话会话(Session)、保存和检索对话历史消息、维护对话的上下文状态。这是实现连贯多轮对话的基础。Workflow System作用: 提供一个可视化工具(基于 ReactFlow 等库),允许用户通过拖放节点(Node)的方式,编排复杂、多步骤的 AI 任务流水线。节点类型包括 LLM 调用、工具调用、条件判断、知识检索等。关系: 在执行时,它会调用 Model Provider System 来获取 LLM 响应,也可以调用 RAG Knowledge System 来检索信息,或执行代码、调用外部 API 工具。RAG Knowledge System (或 Dataset System)作用: 实现检索增强生成(RAG)全流程的系统。处理知识库: 管理数据集的创建、文档上传、解析、分块。生成与存储索引: 协调文本的向量化过程,并将向量嵌入(Embeddings)存储到向量数据库(VectorDB)中。检索: 在查询时,根据用户问题从向量数据库中快速检索出最相关的文本片段,作为上下文提供给 LLM。关系: 严重依赖 VectorDB 和 Celery Worker(用于异步索引文档)。Model Provider System作用: 作为 LLM 的抽象层和统一网关。它集成了众多模型提供商(如 OpenAI, Anthropic, Azure OpenAI, 本地部署模型等),并对上层应用提供一致的调用接口。开发者在这里配置和管理不同模型的 API 密钥和参数。关系: 被 API Backend(处理直接聊天请求时)和 Workflow System(执行 LLM 节点时)调用,是平台与外部 AI 模型连接的桥梁。数据存储与基础设施 (Data Storage & Infrastructure)PostgreSQL:作用: 主数据库。存储所有结构化数据,包括但不限于:用户账户和权限设置AI 应用的配置信息对话记录(Conversation history)Workflow 的编排定义数据集(Dataset)元数据信息VectorDB (e.g., Qdrant, Weaviate, Milvus):作用: 向量数据库。专门用于存储和高效查询由文本生成的向量嵌入(Embeddings)。是 RAG 知识系统的核心存储,通过相似性搜索实现语义检索。Redis:作用: 多功能用途。缓存(Cache): 缓存频繁访问的数据(如会话状态、应用配置),减轻数据库压力,提升响应速度。消息代理(Message Broker): 作为 Celery 的任务队列,在 API Backend 和 Worker 之间传递异步任务消息。File Storage (e.g., S3, MinIO, Local Storage):作用: 存储用户上传的原始文件(如 PDF、Word 文档、图片等)。组件间如何协作Dify 的各个组件并非孤立工作,而是紧密协作的:用户通过 Web 前端 发起请求,例如创建一个新的聊天应用或启动一个工作流。请求到达 API 后端 (Flask),后端根据请求类型协调相应的核心子系统。子系统处理:如果是聊天请求,会话系统 会管理对话状态,并可能调用 模型供应系统 来获取LLM的响应,必要时通过 RAG 知识系统 从知识库检索信息增强上下文。如果是工作流执行,工作流系统 会解析流程定义,按顺序执行各个节点。节点可能调用 模型供应系统 中的LLM、通过 工具集成 访问外部服务,或使用 RAG 知识系统 进行检索。数据存储与访问:在整个过程中,PostgreSQL 用于存储结构化数据(如用户信息、应用配置),向量数据库 为 RAG 提供支撑,Redis 用于缓存和任务队列,文件存储 系统保存用户上传的文档。异步任务处理:对于耗时操作(如文档索引),API 后端会将任务发送到 消息队列 (Redis),由 Celery 工作节点 在后台异步处理。最终响应 通过 API 后端返回给 Web 前端,呈现给用户。安装 Dify 系统设备最低要求:CPU >= 2 CoreRAM >= 4 GiB安装 Dify 前,要先确保你的电脑上已经安装了 Docker 和 Docker Compose,使用 Docker Compose 启动 Dify 服务器是最简便的方式。git clone https://github.com/langgenius/dify.gitcd difycd dockercp .env.example .envdocker compose up -d5 GPT4AllGPT4All是一个强大的生态系统,它允许用户在本地计算机上运行自定义的大型语言模型(LLMs)。本文将详细介绍GPT4All的安装、使用方法以及案例应用,帮助用户全面理解和有效利用这一工具。GPT4All概述什么是GPT4AllGPT4All是一个开源项目,旨在提供一种在通用硬件上运行大型语言模型的方式。该项目由Nomic AI支持和维护,确保软件的质量和安全。GPT4All能在CPU和GPU上运行,支持多种操作系统,包括Windows、MacOS和Linux。GPT4All官网GPT4All的新功能GPT4All持续更新,引入了多项新功能,如GGUF格式的支持、Nomic Vulkan、LocalDocs功能和基于Docker的API服务器。这些功能进一步增强了GPT4All的灵活性和可用性。GPT4All的安装从官网下载GPT4All用户可以直接从GPT4All官网下载软件。下载后,用户需要更改安装目录以适配自己的计算机环境。更改安装目录创建模型文件夹安装GPT4All后,用户需要在软件目录中创建一个名为models的文件夹,用于存放下载的模型文件。创建模型文件夹启动GPT4All启动GPT4All后,用户需要在软件中修改目录,指向之前创建的models文件夹。修改目录GPT4All的使用方法加载模型用户可以通过GPT4All下载或从浏览器直接下载所需的模型文件,并将其移动到models目录下。GPT4All目前仅支持.gguf格式的文件。下载模型开始测试选择模型后,用户可以开始测试GPT4All的功能,如对话生成等。开始测试GPT4All的案例应用个人对话助手GPT4All可以作为个人对话助手,帮助解答日常问题。团队内知识库在团队中,GPT4All可以作为知识库,用于文档索引和搜索。网站客服智能对话GPT4All还可以作为网站客服,提供在线问题支持。教育培训辅助系统在教育培训领域,GPT4All可以作为辅助系统,提供学习问答帮助。LLMs之LLaMA3:基于GPT4All框架的模型部署通过GPT4All框架,用户可以实现LLaMA-3模型的部署和推理。用户可以加载训练后的LLaMA-3的.gguf模型文件,并在GUI界面中实现对话聊天。GPT4All Python SDK安装要开始使用,请在你的 python 环境中通过 pip 安装 gpt4all 包。pip install gpt4all我们建议使用 venv 或 conda 将 gpt4all 安装到其自己的虚拟环境中。加载 LLM模型通过 GPT4All 类按名称加载。如果这是你第一次加载模型,它将被下载到你的设备并保存,以便下次创建同名 GPT4All 模型时可以快速重新加载。GPT4All 经过优化,可在消费级硬件上运行参数范围为 30 亿至 130 亿的大型语言模型(LLMs)。LLMs 会被下载到您的设备上,因此您可以在本地私密地运行它们。借助我们的后端,任何人都可以在自己的硬件上高效安全地与 LLMs 进行交互。下载模型GPT4All 最便捷的部署方式是下载其官方桌面客户端(支持windows、linux(ubuntu)、macos)。这是一个可以直接安装和运行的应用程序,用户无需配置复杂的编程环境。安装后,用户可以在客户端内直接下载所需的模型文件(如 gguf 格式的模型),随后即可开始在本地与模型进行对话。这种方式极大地简化了部署流程,适合非技术背景或希望快速体验的用户,真正实现了“开箱即用”。2通过 Python 库进行部署对于开发者或希望进行深度集成的用户,GPT4All 支持通过 Python 环境进行部署。用户需要在本地安装 Python,并通过安装依赖包来运行模型。主要的步骤通常包括:配置 Python 环境并安装必要的依赖包。在代码中下载或指定模型文件路径。调用 GPT4All 的接口加载模型并进行推理对话。这种方式提供了更高的灵活性和控制权,例如可以集成到自定义的应用流程中。需要注意,在网络配置不当时(如开启了某些代理设置),可能会在下载或加载模型时遇到连接错误,通常的解决方法是调整本地网络环境。6 LocalAIocalAI的终极目标是成为OpenAI API的1:1本地替代品。如果你现有的应用是针对OpenAI开发的(比如用了LangChain或AutoGPT),你只需把API地址指向LocalAI服务器,就能在不修改代码的情况下,将云端AI替换为本地运行的模型。核心优势全模态支持,远超文本生成LocalAI不仅能跑文本大模型,还能直接运行:音频转录(Whisper、WhisperX支持说话人分离)语音合成(Pocket-TTS、VoxCPM,支持流式输出)图像生成(Stable Diffusion,v3.10.0新增视频生成)实时语音对话(v3.11.0引入Realtime Audio功能)音乐生成(Ace-Step MusicGen界面)原生支持Agent和MCP协议这是LocalAI相较于前两者的最大差异化优势。LocalAI原生支持模型上下文协议(MCP),可以让AI模型连接外部工具和API,实现实时数据访问、文件检索、命令执行等能力。2026年3月发布的v4.0.0更将LocalAI升级为一个完整的AI编排平台,带来了:全新React UI:完整的前端重写,交互体验大幅提升Agenthub社区中心:可以分享和导入预制的智能体配置Canvas代码预览模式:在聊天界面中并排显示代码块MCP客户端全面支持:工具流式传输、多服务器配置MLX分布式实验性支持:利用Apple MLX框架运行分布式工作负载极低的硬件要求LocalAI的模块化架构采用”按需下载后端”的设计,可自动检测硬件并支持CPU、GPU、Metal、Jetson甚至分布式加速。即使没有GPU,也能在普通CPU上流畅运行大模型。适合谁深入研究Agent协同架构、MCP协议的技术探索者需要在单一项目中同时处理语音、图像、文本多模态任务的人希望完全本地替代云端API,具备后端工程能力的DevOps工程师硬件配置建议:入门级:8GB内存 + 4核CPU体验级:16GB内存 + 8核CPU专业级:32GB内存 + GPU加速🚀 三种部署方案任你选方案A:Docker一键部署(最适合新手)基础CPU版本(推荐首次尝试):docker run -d --name my-localai \ -p 8080:8080 \ -v ./models:/models \ localai/localai:latest-aio-cpubashGPU加速版本(性能追求者):docker run -d --name localai-gpu \ -p 8080:8080 \ --gpus all \ -v ./models:/models \ localai/localai:latest-aio-gpu-nvidiabash方案B:源码编译安装(定制化需求)适合需要深度定制或开发环境搭建的用户:git clone https://gitcode.com/gh_mirrors/loc/LocalAIcd LocalAImake buildbash方案C:二进制包直装(极速体验)追求最简单快捷的用户选择:下载并运行wget https://github.com/go-skynet/LocalAI/releases/latest/download/local-ai-linux-x86_64chmod +x local-ai-linux-x86_64./local-ai-linux-x86_647 XinferenceXinference 是由 Xorbits 团队开发的一套 本地大模型推理和服务框架,目标是让你像用数据库一样简单地使用 LLM (大语言模型) 和 Embedding 模型,支持 Chat / Completion / Embedding / TTS / STT 等多种任务。官网:http://xinference.io[1]GitHub:http://github.com/xorbitsai/i…[2]模型任务类型说明二、核心特性支持多模型和多任务Chat :Qwen, ChatGLM, LLaMA, Baichuan, MistralEmbedding :BGE, Nomic, E5, InstructorCompletion :GPT-J, Pythia, RWKVTTS/STT :Whisper, Bark, Coqui一行命令启动xinference-local2025-07-21 10 28 11.png提供 REST API + OpenAI 符合接口REST 接口可直接调用兼容 OpenAI SDKWeb UI简洁易用,支持模型添加、操作、清除支持自由添加 HuggingFace 模型2025-07-21 10 26 12.png分布式和 CPU/GPU 选择支持单机 CPU ,多 GPU ,简易分布式启动三、安装指南依赖Python >= 3.9pip / conda 环境pip 安装pip install "xinference[all]"如果只需基础 REST 接口:pip install xinference四、启动 Xinferencexinference-local --log-level=info启动后访问:http://127.0.0.1:9997如看到 Web UI 界面,表明启动成功。五、注册模型注册 Chat 模型curl -X POST http://127.0.0.1:9997/v1/models \ -H "Content-Type: application/json" \ -d '{ "model_name": "qwen:0.5b", "model_format": "xinference", "quantization": "q4", "task": "chat" }'注册 Embedding 模型(本地免费推荐)注册 Embedding 模型前要安装 sentence_transformers 引擎,否则会启动失败。pip install -U sentence-transformerscurl -X POST http://127.0.0.1:9997/v1/models \ -H "Content-Type: application/json" \ -d '{"model_name": "bge-base-zh", "model_format": "xinference", "model_type": "embedding", "model_engine": "sentence_transformers" }' 8 llamafile你还在为部署大语言模型(LLM)时的复杂流程烦恼吗? llama.cpp框架虽强大但配置繁琐,Docker容器又占用过多资源,云服务更是存在数据隐私风险。现在,llamafile彻底解决了这些问题——一个文件即可分发和运行LLM,无需安装依赖,本地执行保障数据安全。本文将带你通过3个简单步骤,从零基础到成功运行自己的AI助手,同时揭秘跨平台兼容的核心技术原理。准备工作:认识llamafilellamafile是一种革命性的LLM分发格式,它将模型权重、运行时和Web服务打包成单个可执行文件。这种技术基于Mozilla的APE(Application Portable Executable)格式,实现了"一次构建,到处运行"的跨平台能力。项目核心优势包括:零依赖部署:无需预装Python、CUDA或特定系统库跨平台兼容:支持Windows、macOS、Linux等主流操作系统数据本地处理:所有计算在本地完成,避免隐私泄露体积优化:采用GGUF格式压缩模型,平衡性能与存储需求官方文档提供了完整技术细节:技术规格说明步骤一:获取llamafile文件llamafile提供两种使用方式:内置模型权重的完整包或仅含运行时的轻量版。对于新手,推荐从官方示例开始:下载预打包模型访问HuggingFace获取LLaVA多模态模型(4.29GB):llava-v1.5-7b-q4.llamafile该模型支持图像理解,可直接上传图片提问。验证文件完整性下载完成后检查文件大小是否为4.29GB,避免因网络中断导致的文件损坏。⚠️ 注意:Windows系统存在4GB可执行文件限制,若使用超过此容量的模型(如13B参数版本),需采用外置权重模式:外置权重使用指南步骤二:系统配置与权限设置不同操作系统需要进行简单的权限配置,以确保llamafile能够正常执行:Windows系统将下载的文件重命名为llava-v1.5-7b-q4.llamafile.exe右键文件 → 属性 → 安全 → 编辑,确保当前用户拥有"读取和执行"权限macOS系统打开终端,导航至下载目录:cd ~/Downloads添加可执行权限:chmod +x llava-v1.5-7b-q4.llamafile解决开发者验证问题:系统设置 → 隐私与安全性 → 底部允许"llava-v1.5-7b-q4.llamafile"运行Linux系统终端执行权限命令:chmod +x llava-v1.5-7b-q4.llamafile对于部分发行版(如Ubuntu),可能需要安装APE格式支持:sudo wget -O /usr/bin/ape https://cosmo.zip/pub/cosmos/bin/ape-$(uname -m).elfsudo chmod +x /usr/bin/apesudo sh -c "echo ':APE:M::MZqFpD::/usr/bin/ape:' >/proc/sys/fs/binfmt_misc/register"bash详细的系统兼容性问题解决方案:故障排除指南步骤三:启动与使用AI助手完成上述准备后,只需一个命令即可启动完整的AI服务:基础启动方式在终端中执行:./llava-v1.5-7b-q4.llamafilebash首次运行会显示初始化进度,成功后将自动打开浏览器,展示Web界面。若浏览器未自动启动,手动访问:http://localhost:80809 llama.cpp什么是 llama.cpp?llama.cpp 是一个用 C/C++ 编写的大语言模型推理框架,目标是在消费级硬件上高效运行 LLM。它支持 macOS、Linux、Windows 以及各种 GPU 加速后端,是目前最流行的本地 AI 推理工具之一。安装指南方式一:包管理器(推荐新手)macOS (Homebrew)brew install llama.cppWindows (winget)winget install llama.cppNix/NixOSnix-env -iA nixpkgs.llama-cpp方式二:下载预编译二进制访问 Releases 页面 下载对应系统的预编译版本,解压即可使用。方式三:使用 Dockerdocker run -it --gpus all ghcr.io/ggml-org/llama.cpp:latest方式四:从源码编译克隆仓库git clone https://github.com/ggml-org/llama.cppcd llama.cppmacOS / LinuxmakeWindows (使用 CMake)cmake -B buildcmake --build build --config Release启用 GPU 加速(可选)NVIDIA CUDAmake LLAMA_CUDA=1Apple Metalmake LLAMA_METAL=1Vulkanmake LLAMA_VULKAN=1获取模型llama.cpp 使用 GGUF 格式的模型文件。获取模型有几种方式:方式一:直接从 Hugging Face 下载使用 llama-cli 直接下载并运行llama-cli -hf ggml-org/gemma-3-1b-it-GGUF方式二:手动下载访问 Hugging Face 搜索 GGUF 格式的模型,例如:https://huggingface.co/ggml-orghttps://huggingface.co/TheBloke (大量量化模型)下载 .gguf 文件到本地。方式三:自己转换如果有原始模型(如 Hugging Face 上的 PyTorch 模型),可以使用 convert-hf-to-gguf.py 脚本转换:python convert-hf-to-gguf.py path/to/model --outfile model.gguf基本使用命令行交互使用本地模型文件llama-cli -m path/to/model.gguf指定更多参数llama-cli -m model.gguf \ -p "你好,请介绍一下自己" \ -n 512 \ --temp 0.7常用参数:-m:模型文件路径-p:提示词(prompt)-n:生成最大 token 数--temp:温度(创造性,0-1)--ctx-size:上下文窗口大小启动 API 服务器llama.cpp 可以启动一个 OpenAI 兼容的 API 服务器:llama-server -m model.gguf --host 0.0.0.0 --port 8080启动后,可以用任何 OpenAI 客户端连接:from openai import OpenAIclient = OpenAI(base_url="http://localhost:8080/v1", api_key="not-needed")response = client.chat.completions.create(model="local-model", messages=[ {"role": "system", "content": "你是一个有帮助的助手"}, {"role": "user", "content": "你好!"} ])print(response.choices[0].message.content)多模态使用(图像 + 文本)llama-cli -m llava-model.gguf \ --mmproj mmproj-model.gguf \ -i image.jpg \ -p "描述这张图片"高级配置GPU 加速NVIDIA CUDAllama-cli -m model.gguf -ngl 99-ngl 指定卸载到 GPU 的层数,99 表示全部卸载。Apple Metalllama-cli -m model.gguf -ngl 99Vulkanllama-cli -m model.gguf -ngl 99 -vgpu 0量化模型选择量化可以在几乎不影响质量的情况下大幅降低显存占用:上下文窗口调整llama-cli -m model.gguf --ctx-size 8192更大的上下文窗口可以处理更长的文档,但会增加内存占用。常见问题显存不足怎么办?使用量化程度更高的模型(如 Q4 instead of Q8)减少 -ngl 参数,让部分层在 CPU 上运行选择更小的模型(7B instead of 70B)推理速度太慢?确保启用了 GPU 加速(-ngl 99)使用量化模型减少 --ctx-size关闭不必要的后台程序如何保存对话历史?使用 --conversation 参数或自行管理对话历史:llama-cli -m model.gguf \ --conversation \ --conversation-file chat.json生态系统工具桌面应用LM Studio:图形界面,适合新手Jan:开源的本地 AI 平台Ollama:简化的模型管理工具编辑器插件VS Code: llama.vscodeVim/Neovim: llama.vim编程语言绑定Python: pip install llama-cpp-pythonNode.js: npm install node-llama-cppRust: cargo add llama-cpp-rs推荐的入门模型新手推荐(显存 8GB 以下)Gemma 3 1B/4BPhi-3 Mini (3.8B)Qwen2.5 3B/7B (量化版)中端配置(显存 12-16GB)LLaMA 3 8BMistral 7BGemma 2 9B高端配置(显存 24GB+)LLaMA 3 70B (量化版)Mixtral 8x7BQwen2.5 72B (量化版)总结llama.cpp 让本地运行大模型变得简单。无论你是想保护隐私、节省成本,还是单纯想学习 AI 技术,它都是一个优秀的起点。快速开始三步:安装 llama.cpp下载一个 GGUF 模型运行 llama-cli -m model.gguf开始你的本地 AI 之旅吧!9 JanJan 的主要功能之一是支持本地运行 AI 模型,如 Llama 或 Mistral,这样可以提高隐私性,不需要互联网连接。如果你需要讨论敏感内容,本地运行模型更为安全。例如,在需要保密的项目中,Jan 的本地模型功能可以确保对话的私密性和安全性。如果你不需要本地模型,Jan 也可以连接到远程模型,如 OpenAI、Gro 或 Mistral API,这样你就不需要高级硬件来访问这些模型的功能。这种灵活性特别有用,当你需要在线模型的能力但仍希望在必要时切换到本地模型。所有对话内容都存储在本地。此外,Jan 跨平台支持 Mac、Linux 和 Windows,极大地提升了可访问性。Jan 还提供了 API 端点,方便你在自定义应用程序或其他 AI 应用中使用,这些 API 端点与 OpenAI 兼容,所以你可以与任何支持 OpenAI 模型的应用程序一起使用。你还可以通过扩展选项设置其他功能,例如添加自定义插件以增强 Jan 的功能或将其与其他工具和服务集成。它支持处理 PDF、文档等任何可以解析的文本文件。Jan 有两个内置引擎用于推理:Llama CPP 和 Tensor RT LM,默认使用 Llama CPP。双引擎的设计为模型推理提供了更多的灵活性和选择。你还可以将 Jan 连接到 LM Studio 或 AMA 的端点。现在让我们安装并试用一下。首先,访问 Jan 的网站并点击下载按钮,选择你的操作系统并下载安装文件。10 本地大模型运行原理:以ollama 为例子简单来说,Ollama的工作流程确实是:将模型权重从硬盘加载至内存(或GPU显存),然后通过优化的推理后端进行计算。 但其中包含几个关键细节:模型存储与格式:GGUFOllama使用 GGUF (GPT-Generated Unified Format) 格式的模型文件。这种格式的特点是:已量化:您从Ollama库下载的模型,如 deepseek-r1:7b,已经是经过量化(例如Q4_K_M)的版本,文件大小比原始FP16模型小得多(如7B模型约3.8GB)。分层加载友好:GGUF格式允许系统只将当前计算需要的部分模型层加载到最快的内存(如GPU显存),其余部分可以留在系统内存或硬盘,这在资源有限的设备上至关重要。加载过程:动态且分层当您运行 ollama run deepseek-r1:7b 时,发生以下步骤:检查与准备:Ollama检查本地是否已有该模型文件。如果没有,则从服务器下载到硬盘(默认位置如 ~/.ollama/models)。分配计算设备:Ollama自动检测您的硬件环境。如果检测到性能足够的NVIDIA/AMD GPU,它会优先将模型权重加载到GPU显存中以获得最快速度。如果GPU显存不足或无GPU,它会自动回退到使用CPU和系统内存进行推理。智能加载:它不会一次性将整个模型文件“笨拙”地全部塞进显存。对于非常大的模型或显存不足的情况,Ollama的后端(通常是llama.cpp)可以执行分层卸载,只将最关键的层(如前20层)放在GPU显存,其余层留在内存甚至需要时从硬盘动态读取,以平衡速度与资源限制。推理计算:不直接调用CUDA后端引擎:Ollama本身不直接编写CUDA内核。它依赖一个名为 llama.cpp 的高效推理库作为其核心计算引擎。llama.cpp 是用C++编写的,它针对CPU和GPU(通过CUDA for NVIDIA,Metal for Apple Silicon)进行了深度优化。跨平台支持:在Mac上,llama.cpp 会调用 Metal Performance Shaders;在Windows/Linux的NVIDIA显卡上,它会调用 CUDA;在AMD显卡或纯CPU环境下,它使用高度优化的AVX指令集进行计算。简化操作:Ollama的价值在于,它为您封装了所有这些底层细节。您无需手动安装CUDA驱动、配置PyTorch或编译llama.cpp,一个简单的 ollama run 命令就完成了从下载、加载到运行的全部过程。总结流程整个流程可以概括为:硬盘(GGUF模型文件)↓ (按需、分层加载)系统内存 / GPU显存 (根据硬件自动选择)↓ (通过封装好的 llama.cpp 引擎)计算推理(在CPU/GPU上进行)↓ 生成回答 Ollama的魔力在于它通过GGUF格式、智能资源管理和封装的llama.cpp后端,让这个过程变得极其简单、自动化和高效,使得在消费级硬件上运行大模型成为可能
-
AI专题十九: AI 应用从低级到高级分类 山姆·奥特曼提出的官方框架:AI发展的“五个级别”奥特曼在多次访谈中(如2024年的一次闭门分享)清晰地提出了AI能力演进的五个级别,其核心是AI的自主性和解决问题的能力,而非单纯的应用形态。这五个级别是:级别1:对话式AI(Chatbot):能够进行开放域对话,但仅限于对话本身。代表:ChatGPT的对话模式。级别2:推理者(Reasoner):能够解决与人类博士水平相当的复杂问题。代表:OpenAI的o1模型。级别3:执行者/智能体(Agent):能够代表用户主动执行多步骤任务,例如“帮我预定下周的整个行程”。级别4:创新者(Innovator):能够自主进行研究和创造,提出新的想法和解决方案。级别5:组织者(Organizer):能够管理一个组织或大型项目,承担类似CEO的职能。结论:奥特曼的框架是 “能力等级”。从AI 应用场景从低级到高级:业界对这类 AI 应用没有一个完全统一的官方标准命名,但目前比较常见的分法,通常会按“能力层级 / 行为方式 / 所在环境”来命名。你提到的四类,可以大致对应成下面这样:1) 对话式 AI常见命名:Conversational AIChatbots / AI ChatbotsLLM assistantsCopilots(偏“辅助型”产品语境)特点:主要在文本/语音对话中完成问答、生成、总结、检索等任务不直接执行复杂动作,更多是“说”和“写”2) 智能体工作流 AI常见命名:AI AgentsAgentic WorkflowsWorkflow AgentsTask AgentsTool-using Agents / Tool-augmented Agents特点:不只是聊天,而是能调用工具、拆解任务、按步骤执行常见于:自动写邮件、查资料、生成报告、调用 API、触发业务流程“Workflow”一词强调人设计流程,AI 执行流程“Agentic”一词强调AI 自主性更强3) 操作电脑的 AI常见命名:Computer-Using Agents (CUA)Computer Use AIDesktop AgentsGUI AgentsBrowser Agents / Web AgentsRPA + AI(在企业场景里常和 RPA 融合提法)特点:AI 直接操作鼠标、键盘、浏览器、桌面软件不依赖 API 接口,而是像人一样看屏幕、点按钮、输入内容典型场景:自动填写表单、跨系统搬运信息、网页操作、后台流程执行这个方向近两年业界很常见的关键词就是 Computer Use 或 Computer-Using Agent。4) 进入物理世界的 AI 机器常见命名:Embodied AIRobotics / AI RoboticsPhysical AIRobot AgentsAutonomous RobotsGeneralist Robots(更偏前沿叙事)特点:AI 不再只在数字世界行动,而是驱动机器人、机械臂、无人设备等需要感知、规划、控制、与真实环境交互典型场景:仓储机器人、工业机械臂、家庭机器人、自动驾驶、无人机等其中:Embodied AI 更强调“具身智能”Physical AI 是近年 NVIDIA 等厂商带火的说法,强调 AI 进入现实物理环境Robotics 则是最通用、最传统的总称一个更常见的业界分层说法如果按“从低到高”或“从虚拟到物理”来概括,常会这样写:Conversational AIAI Agents / Agentic WorkflowsComputer-Using Agents / GUI AgentsEmbodied AI / Physical AI / RoboticsAI 智能等级L0~L5 定义根据搜索结果,目前全球范围内尚未形成像自动驾驶SAE标准那样唯一、权威且被强制遵循的AI智能程度分级标准。但借鉴自动驾驶分级思想,业界已涌现出多个从不同维度对AI智能化程度进行划分的分类框架,这些框架旨在为AI技术的发展路径提供评估坐标。自动驾驶分级标准作为参考基准自动驾驶的分级为AI智能化分级提供了直接的灵感来源。根据国际自动机工程师学会(SAE)的定义,驾驶自动化分为L0至L5六个等级,核心在于明确系统与驾驶员在动态驾驶任务中的角色分配。L0-L2级为辅助驾驶,驾驶员需持续监控;从L3级开始进入自动驾驶范畴,系统可在特定条件下执行全部驾驶任务;L5级为在任何环境下都能实现的完全自动驾驶。这一分级清晰地量化了机器替代人类驾驶的程度1121516。AI智能分级同样希望量化机器在认知、决策和行动任务上替代或辅助人类的程度。AI智能体与Agent能力分级的主要提案业界借鉴自动驾驶分级逻辑,提出了多个AI智能分级方案,其核心在于评估AI的自主决策和执行能力。360创始人周鸿祎提出了五级分类法:L1是仅有对话能力的聊天助手;L2是需人类设置流程的低代码工作流智能体;L3是能自主规划完成任务的推理型智能体(领域专家);L4是多智能体蜂群协作系统;L5则是具备完全自主意识的超级AI系统26。学术研究领域,有论文将AI智能体分为五个能力级别:从L0的无AI工具,到基于规则的L1,再到应用模仿/强化学习的L2,进而发展到基于大语言模型并具备记忆反思的L3,以及能自主学习和泛化的L4,最高级的L5则引入个性情感与多智能体协作35。OpenAI也建立了内部五级标准,从当前的ChatGPT(接近L2)到能够代表用户行动的L3、能创造新事物的L4,直至能执行组织工作的L5。这些分级框架都将关注点从单一的对话能力,扩展到了AI的任务规划、工具调用、自主执行及多智能体协作能力48。其他领域的智能等级评估标准智能化分级的思想已扩展到更广泛的终端领域。在AI手机领域,中国信息通信研究院联合厂商发布的《终端智能化分级研究报告》定义了L1至L5五个等级,从仅响应指令的L1,到能识别简单意图的L2,再到能处理复杂意图并自主规划的L3,最终发展到能预测意图并基于全场景自主规划的L59。在人形机器人领域,业界也发布了全球首个《人形机器人智能化分级》团体标准,围绕感知认知、决策学习、执行表现和协作交互四大维度,将智能化划分为L1至L5级10。这些标准表明,针对特定应用场景的智能化水平评估正在走向标准化。总结:概念框架而非统一标准综上所述,尽管汽车自动驾驶的L1-L5分级已被国际标准化,但AI智能程度目前尚未形成与之对应的全球统一官方标准。现有的多种分级方案均为企业、学术界或行业组织提出的概念性框架或团体标准,其目的在于为技术演进、产品定位和产业讨论提供参考坐标8。这些分级共同揭示了AI从被动工具到自主智能体的发展路径,有助于公众和业界理解AI技术的发展阶段与未来方向