首页
游戏
影视
直播
广播
听书
音乐
图片
更多
看书
微视
主播
统计
友链
留言
关于
论坛
邮件
推荐
我的云盘
我的搜索
我的记录
我的图片
我的图书
我的笔记
我的音乐
我的影视
我的邮件
我的游戏
Search
1
virtuoso和empyrean alps模拟仿真和混仿教程
359 阅读
2
在IC617中进行xa+vcs数模混仿
300 阅读
3
文档内容搜索哪家强? 15款文件搜索软件横向评测
264 阅读
4
科普:Memory Compiler生成的Register file和SRAM有何区别?
257 阅读
5
通俗易懂的AI知识体系图及其产业链全景图
198 阅读
默认分类
芯片市场
数字电路
芯片后端
模拟电路
芯片验证
原型与样片验证
算法与架构
DFX与量产封装
PC&Server OS设置
移动OS设置
软件方案
新浪备份
有道备份
登录
Search
标签搜索
AI
python
Docker
vcs
PyQT
STM32
cadence
linux
systemverilog
EDA
Alist
vscode
uos
package
MCU
C
QT
CXL
sed
sv
bennyhe
累计撰写
387
篇文章
累计收到
33
条评论
首页
栏目
默认分类
芯片市场
数字电路
芯片后端
模拟电路
芯片验证
原型与样片验证
算法与架构
DFX与量产封装
PC&Server OS设置
移动OS设置
软件方案
新浪备份
有道备份
页面
游戏
影视
直播
广播
听书
音乐
图片
看书
微视
主播
统计
友链
留言
关于
论坛
邮件
推荐
我的云盘
我的搜索
我的记录
我的图片
我的图书
我的笔记
我的音乐
我的影视
我的邮件
我的游戏
搜索到
22
篇与
的结果
2026-04-16
AI专题十五:AI算力卡互联
备注:未来主要是看Nvlink、UAlink、Unified Bus在 AI 训练和推理中,单卡性能固然重要,但当模型规模、数据量持续膨胀时,模型参数到达几十亿甚至上千亿参数,单张 GPU 的显存与算力已无法独立承载训练、推理任务,多卡并行成为唯一选择。这时候,卡与卡之间的互联带宽、延迟、拓扑结构 就成了制约整体性能的关键瓶颈。(图源:GOPS 全球运维大会暨研运数智化技术峰会 2024 · 上海站)本文主要介绍节点内部的GPU互联,节点间的GPU互联涉及网络部分,后面开新篇详细讲解。大模型训练时,模型的权重矩阵被切分到不同 GPU,每次前向/反向传播都要交换激活或梯度。这种通信量大但延迟敏感的场景,放在节点内更高效,因此单节点内,会经常有张量并行的场景。这种高带宽、低延迟的互联需求,也催生了GPU互联技术的发展。1、PCIe最初,大家都使用PCIe 进行互联,GPU 插卡通过 PCIe 接入主板,生态成熟、通用性强、设备即插即用。(图源:《电子发烧友》)但随着模型规模不断增大,PCIe 的带宽逐渐显得不足。以某PCIE GPU服务器为例,每个CPU下连接一个PCIe Switch芯片,每个PCIe Switch芯片连接5张GPU。GPU0-GPU3、GPU4-GPU7的两组GPU,内部可以通过PCIe switch通信,但如果需要跨组通信,只能通过CPU之间UPI来进行(GPU 1 -> PCIe 总线 -> CPU -> PCIe 总线 -> GPU 8)。(图源:元脑®服务器 NF5468G7 系列技术白皮书)不过,即使是最新的PCIe 技术,提供的带宽也有限。PCIe 4.0 x16 单向带宽约 32 GB/s,PCIe 5.0 64 GB/s。相比 GPU 内部早已上TB/s的显存带宽,这显然成了“木桶效应”中的短板,成了拉低通信效率的瓶颈。为了解决这一瓶颈,GPU 厂商开始探索专门的GPU互联通道。2、英伟达NVLinkNVLink首次作为GPU互联技术随NVIDIA P100 GPU推出,此后与每一代新的NVIDIA GPU架构同步发展。从最初的简单GPU-GPU连接,到如今的全系统互联解决方案,NVLink已经成为高性能GPU互联的代名词。2016年,NVLink 1.0 与 P100 GPU 一同发布(顺便说一句,Tesla P100也是全球首个支持高带宽 HBM2 内存技术的 GPU 架构),一张 GPU 支持最多 4 条 NVLink,每条链路双带宽约 40 GB/s ,整个芯片的总双向带宽达到了 160GB/s,大大突破了PCIe 3.0 带宽限制(PCIe 3.0 x16 双向仅 ~32 GB/s)。2017 年,NVLink 2.0 随 V100 (Volta 架构) 推出,每条链路双向带宽提升至 50 GB/s,单卡支持 6 条链路,总带宽最高 300 GB/s。NVLink2.0 技术虽然大大提高了带宽,但是单服务器中 8 个 GPU仍然无法做到全连接,为解决该问题,NVIDIA 在V100发布同年,发布了 NVSwitch,实现了 NVLink 的全连接。GPU所有的端口都用于与SW互联,数据在所有NVLink通道上交错传输,支持任意两块 GPU 之间的全带宽,NVLinks 的总带宽未超,对单个 GPU 的传输就不会阻塞。到如今,NVLink已经发展到了第五代,几乎每一代的带宽都是翻倍增长,最新的第五代性能已经高达1.8T/s。第五代NVIDIA NVSwitch更是配备144 个NVLink 端口,无阻塞交换能力达到了14.4 TB/s。备注:NVLink 和 NVSwitch 是英伟达(NVIDIA)为解决高性能计算和人工智能(AI)场景下多 GPU 间通信瓶颈而设计的两项核心技术。它们虽然紧密相关,但角色和功能有本质区别。下面从基础概念、功能定位、技术演进、工作原理和实际应用等方面进行详细分析。NVLink:点对点连接最初设计用于替代带宽受限的 PCIe 接口。支持两个设备(如 GPU-GPU 或 GPU-CPU)之间直接通信,提供远高于 PCIe 的带宽和更低的延迟。例如:两张 A100 GPU 通过 NVLink 直连,可实现高达 600 GB/s 的双向带宽(A100 SXM4)。NVSwitch:全互连拓扑构建者解决多 GPU 系统中“无法全互联”的问题。在一个服务器内(如 DGX 系统),NVSwitch 芯片允许多个 GPU(如 8 个或 16 个)通过 NVLink 连接到同一个交换矩阵上,实现“每个 GPU 都能直接与其它所有 GPU 通信”。消除了传统 PCIe Switch 或树状拓扑中的通信瓶颈。3、AMD Infinity FabricAMD 2017年随Ryzen/EPYC 首次提出Infinity Fabric,是一种专有的系统互联架构,用于促进所有连接组件之间的数据和控制传输。目前,Infinity Fabric已经进入了第四代,每条 Infinity Fabric 链路支持高达 32 Gbps 的传输速率,提供 128 GB/s 的双向带宽(跟PCIe 5.0很像呢)。 主要为环形或者网状拓扑。4、国产厂商互联技术国产芯片厂商的资料一般不公开,以下内容也是基于互联网资料整理的。华为昇腾HCCS昇腾 910B(尤其是 910B2)使用的是 HCCS 高速缓存一致性系统,相当于华为版本的 NVLink,专门用于芯片间高速通信与缓存一致性,卡间互连带宽为约 392 GB/s。华为unified bus衢定义为面向超节点(SuperPoD) 的统一互联协议,旨在将 I/O、内存访问、异构计算单元(CPU/NPU/GPU等)之间的通信融合到同一技术体系中,实现高性能、高协同、高弹性的计算基础设施。寒武纪 MLU-Link™多芯互联技术(公开资料比较老)MLU370-X8智能加速卡支持MLU-Link™多芯互联技术,提供卡内及卡间互联功能。寒武纪为多卡系统专门设计了MLU-Link桥接卡,可实现4张加速卡为一组的8颗思元370芯片全互联,每张加速卡可获得200GB/s的通讯吞吐性能,带宽为PCIe 4.0 的3.1倍,可高效执行多芯多卡训练和分布式推理任务。沐曦 MetaXLink采用自研MetaXLink高速接口,支持单机8卡全互联,显著提升多卡协同效率壁仞BLink原创BLink™高速GPU互连技术,单卡互连带宽最高达448 GB/s,并支持单节点8卡全互连燧原 GCU-LAREGCU-LARE全域互联技术是燧原专为AI训练集群研发的互联技术,提供双向300 GB/s互联带宽,支持数千张云燧CloudBlazer加速卡互联,可实现优异的线性加速比。Gen-ZGen-Z 其实是一堆行业巨头不满意 Intel 技术垄断和演进的情况下,合作搞出的新型高速互连标准,AMD、ARM、博通、Cray、戴尔 EMC、HPE、华为、IBM、联想、Mellanox (NVIDIA)、美光、红帽、三星、希捷、SK 海力士、西数、赛灵思等等都在其中,CPU,模组,网络,服务器,存储,连接器,操作系统,硬盘,FPGA的龙头老大都已经齐聚一堂,好像也看到无处不在的大陆连接器线缆龙头大哥,立迅精密.Gen-Z架构专注于提供高效率、高带宽和低延迟.Gen-Z 面向数据中心和服务器市场,是一种以内存为中心的总线结构式协议,具备高带宽、低延迟、先进工作负载、良好兼容性和经济性等优点.通过利用经过验证的装载/存储模型实现高效率。简化了Gen-Z硬件接口层,从而最大限度地减少了对软件层的需求。消除这种复杂性、开销和诱导系统延迟可以显着提高系统性能。高带宽以两种方式实现。Gen-Z支持非对称通信路径,这意味着可以将更多通道专用于读取路径而不是写入路径,反之亦然。此外,Gen-Z支持多种信令速率,包括16,25,32,56和112 GT / s,总而言之,这些功能将使Gen-Z能够跟上行业不断增长的速度需求,同时还允许将Gen-Z通信路径调整为特定的工作负载流量模式.通过减少软件堆栈来实现低延迟,与传统的服务器存储和大量分层的网络堆栈不同,Gen-Z采用轻量级软件接口,直接对硬件进行内存读写操作.Gen-Z 1.0 标准采用 PCIe 物理层和修改的 IEEE 802.3 以太网电气层标准,但在物理层上只定义了 PCIe 4.0,因此每通道速度最快只有 25GT/s,要想充分利用标准的全部性能,也必须满足 PHY 物理层面的所有规定.Gen-Z 1.1 则引入了 PCIe 5.0,每通道速度提高到 32GT/s,同时在比较宽松的技术限制下,就可以实现 Gen-Z-E-PAM4-50G-Fabric 链接,原始数据率 53.125GT/s,一切都以达到更高的传输速度、更低的延迟为目标,毕竟这也是该标准的初衷目前主流的AI算力芯片板卡(如NVIDIA、AMD、Intel的GPU/AI加速卡)均未采用Gen-Z接口。它们主要使用PCIe和厂商私有的高速互联协议(如NVLink、Infinity Fabric)。这背后是技术路线、生态锁定和成本效益等多重因素共同作用的结果。以下是详细分析:一、当前主流AI算力卡的互联接口PCI Express:行业标准与“基线”作用:这是所有AI加速卡与主机CPU、系统内存及其他设备通信的标准、必需的接口。目前主流是PCIe 5.0,正在向PCIe 6.0过渡。原因:PCIe是服务器和PC行业的通用标准,提供了必不可少的系统兼容性、枚举和基础I/O功能。任何加速卡都必须通过PCIe与主机连接。厂商私有高速互联协议:性能的“核心”NVIDIA NVLink:用于H100、B200等卡间的直接高速互联。其带宽远超PCIe(例如,H100的NVLink 4.0带宽达900GB/s),是构建多卡统一内存域、实现高效模型并行(如张量并行)的关键。它通过SXM形态或NVLink Bridge实现。AMD Infinity Fabric:在AMD Instinct MI300系列等加速卡上,用于GPU to GPU的直接高速连接,功能与NVLink类似,是AMD生态内构建多卡系统的核心。为什么用私有协议? 因为这些协议由芯片设计方深度定制,可以与自家GPU的架构(如内存控制器、缓存一致性协议)实现最优协同,达到极低的延迟和极高的带宽,这是通用标准短期内难以匹敌的。二、为什么Gen-Z未被AI算力卡采用?Gen-Z是一种以内存语义为中心的开放互连标准,旨在实现CPU、内存、加速器和存储之间的高效数据共享。它未能成为AI算力卡主流接口的主要原因如下:生态锁定与先发优势NVIDIA的统治地位:其NVLink + CUDA 生态已成为AI训练和高端推理的事实标准。客户购买H100不仅买硬件,更是购买整个软件栈和优化过的多卡通信库(如NCCL)。切换到Gen-Z意味着打破这个封闭但高效的生态,对NVIDIA和客户都无益处。AMD的路径依赖:AMD同样选择了发展自己的Infinity Fabric,并在其CPU(EPYC)和GPU(Instinct)之间通过 Infinity Architecture 进行深度集成,形成了自己的协同生态。技术定位与需求错配Gen-Z的核心优势在于内存池化和解耦,让各种设备可以像访问本地内存一样访问共享内存池。这对于某些数据中心架构(如分解式存储、内存池)很有吸引力。AI算力卡的核心需求是极致的点对点通信带宽和低延迟,以支持大规模模型并行训练。NVLink/Infinity Fabric作为紧耦合的专用互联,在为特定芯片对优化这方面,比通用的Gen-Z更有优势。成本与复杂性在主芯片(GPU)上集成额外的Gen-Z控制器会增加芯片面积、功耗和设计复杂性。在板卡和主板层面,需要增加Gen-Z所需的物理接口和线缆,这会增加系统成本和设计难度,而性能收益对于AI工作负载而言并不明确。标准竞争的结局近年来,另一个标准 CXL 在内存语义互连的竞争中逐渐占据了上风,得到了Intel、AMD、ARM及整个服务器生态链的更广泛支持。CXL基于PCIe物理层,兼容性更好,发展路径更清晰。行业焦点已从Gen-Z转向了CXL。三、未来趋势:CXL与UCIe虽然Gen-Z未成为主流,但解决内存墙和异构计算通信问题的需求依然存在,新的接口标准正在崛起:CXL:目前最受瞩目的行业标准。它运行在PCIe物理层之上,专注于实现缓存一致性的内存共享。未来,AI加速卡可能会集成CXL接口,目的不是为了卡间直连,而是为了让GPU能够更高效、更一致地访问CPU内存甚至池化内存,从而突破单卡显存容量限制。UCIe:这是一个芯片级的裸片互连标准。未来,AI算力芯片可能通过UCIe在封装内部直接与其他芯片(如CPU、专用加速器、HBM)连接,实现比板级互联更高的带宽和能效。这可以看作是“更近一步”的NVLink5.桥接器、SXM、OAM : 高速互联GPU的硬件实现这么多GPU高速互联的技术,最终都要落到实际的服务器硬件实现。第一种就是桥接器,最开始是NVIDIA 专为 PCIe GPU 而设计的物理桥接设备。它能让两个 GPU 建立直接高速连接,绕开主板的 PCIe 主干,总带宽远高于单纯依赖 PCIe 通道的多卡互联方式。后面很多其他厂商也学过去了。桥接器的好处就是,只用PCIe 服务器,就能获得高速互联,但是相对而言限制比较大,大部分可以做到2卡高速互联。要想做到单节点所有GPU全互联,就需要改变服务器的硬件形态了。以H100为例,板卡有两种形态,一种是PCIe板,一种是SXM板。SXM板集成了 H100 GPU 和 HBM3 内存堆栈,并支持第四代 NVLink 以及 PCIe Gen 5 连接,提供最优的应用性能。这种SXM卡用于英伟达的DGX/HGX平台,就是我们常说的GPU模组,这个模组里面集成了GPU、NVLink、NVIDIA 网络以及全面优化的 AI 和高性能计算 (HPC) 软件堆栈的全部功能。各家服务器厂商就根据英伟达的这个模组来开发服务器的硬件平台,大部分就是专供英伟达使用了。但是英伟达的模组都是自己私有化的,其他GPU厂商怎么办呢?2019年OCP全球峰会期间,百度宣布与Facebook、微软展开合作,联合制定OAM (OCP Accelerator Module)标准。该标准用于指导AI硬件加速模块和系统设计。2019年在美国丹佛举行的SC19全球超算大会上,浪潮正式发布全新的AI开放加速系统MX1,可在一个AI服务器支持多种符合OAM(OCP Accelerator Module)规范的AI芯片,这也是全球首个可支持多家不同型号的AI芯片直接更换的AI开放加速系统。OAM标准定义了AI加速器的统一接口,支持ASIC、GPU和FPGA等多种架构,并在物理形态、电源、连接器、引脚定义和系统架构方面提供创新设计。6. 未来演进UAlinkUALink 是 Alibaba、AMD、Apple、Astera Labs、AWS、Cisco、Google、HPE、Intel、Meta、Microsoft和Synopsys 发起。国内的一些AI 芯片厂商大概率会放弃自研的link 方式,切换到UAlink,因为实力和市场不容许。通用的UAlinkUltra Accelerator Link™ (UALink™)联盟于2024年10月注册成立,是致力于制定UALink规范的开放行业标准组织。该规范作为高速、可扩展的加速器互联技术,可提升下一代AI和高性能计算集群性能。联盟由行业领军企业组成的董事会领导,包括:Alibaba、AMD、Apple、Astera Labs、AWS、Cisco、Google、HPE、Intel、Meta、Microsoft和Synopsys。联盟制定的技术规范为新兴AI应用模式实现突破性性能提供便利,同时支持构建数据中心加速器的开放生态系统。UALink通用规范2.0为UALink技术引入网内计算,促进加速器之间的计算和通信。降低延迟、节省带宽,提升UALink系统在复杂和多工作负载环境下的AI解决方案分布式训练和推理的扩展效率。UALink 200G数据链路和物理层(DL/PL)规范2.0将DL/PL规范从UALink通用规范中拆分,使UALink能够根据行业对新型物理层和速率的需求快速迭代,无需修改其他规范。引入UALink作为具备集中控制平面和管理平面的系统。采用gNMI、Yang、SAI和Redfish等标准化协议、模型和应用程序接口。定义将UALink技术集成至基于芯粒的片上系统所需的关键信息,包括接口、外形规格、流量控制和芯粒管理标准化。完全兼容UCIe® 3.0规范,简化与现有芯粒生态系统的集成。UALink可管理性规范1.0UALink芯粒规范1.0随着UALink技术持续发展,联盟计划推出互操作性与合规项目,以支撑稳健的多厂商生态系统。欢迎有意推动UALink技术发展并参与相关项目建设的企业加入联盟,共同制定未来UALink规范。AMD 是为放弃Infinity Fabric 还是全面拥抱UAlink,AMD有这个实力。根据当前公开的技术信息和行业趋势,AMD在未来很可能会采取“双轨制”策略,即继续发展和使用Infinity Fabric作为其自家产品内部的核心互联技术,同时积极参与并推广UAlink作为跨厂商、开放生态的外部互联标准。两者并非替代关系,而是互补共存。Infinity Fabric将继续作为AMD产品架构基石Infinity Fabric是AMD自Zen架构以来为其处理器和加速器设计的专有、高性能内部互连总线。它深度集成于AMD的芯片设计中,用于连接CPU核心、CCD、IO芯片以及GPU,是实现其模块化设计和高性能的关键。放弃这一成熟且不断演进的技术(如发展到IFOP 3.0)对AMD而言既不现实也无必要。它将继续在EPYC CPU与Instinct GPU的紧耦合计算单元(如MI300X的8卡互联)中发挥核心作用。410AMD积极主导UAlink以构建开放生态对抗NVLinkUAlink的定位与Infinity Fabric不同。它是由AMD、英特尔、谷歌、微软等巨头联盟推动的开放式加速器互联行业标准,旨在为AI服务器集群中的任意品牌加速器(AMD、Intel等)提供高速、低延迟的互连方案,直接目标是打破英伟达NVLink的封闭生态壁垒。AMD是UAlink联盟的核心发起者和主推者之一,其动机在于通过开放标准吸引更多客户和合作伙伴,扩大其AI加速器的市场渗透率。因此,AMD必将大力支持并推广UAlink。2612两种技术将并存于不同场景未来AMD的产品路线图很可能呈现以下分工:内部紧密集成场景:在单机或机架内纯AMD硬件(如EPYC + Instinct MI系列GPU)构成的计算单元中,将继续优化并使用Infinity Fabric以实现最高效的內部通信。这是其性能优势所在。外部异构集群场景:在需要大规模扩展、或与其他厂商硬件(如英特尔GPU、第三方交换机)混合组网的AI数据中心集群中,AMD的加速器将支持并首选UAlink标准进行互联。这符合其开放生态战略。AMD已明确表示,其下一代机架级解决方案“Helios”将同时支持Infinity Fabric和UAlink。58结论:互补而非切换AMD不会“全面切换”到UAlink而放弃Infinity Fabric。相反,它将:对内巩固:持续投资Infinity Fabric,作为其芯片内部及自家产品组合间的高性能私有通道。对外开放:全力推动UAlink成为行业事实标准,确保其AI硬件能在多供应商环境中无缝互联,增强市场竞争力。这种策略使AMD既能保持核心技术优势,又能参与定义开放生态,是最符合其商业和技术利益的路径。对于用户而言,未来的AMDAI解决方案将根据部署环境(纯AMD栈或异构集群)灵活启用这两种互联技术。英特尔将采取“两手准备、优先自研、拥抱开放”的战略,最终会以自研技术为核心,同时积极兼容并影响开放标准(如UALink)。一、核心判断:英特尔的选择逻辑作为追赶者,必须打造差异化核心竞争力 英特尔深知,若只在通用GPU领域跟随英伟达,难以超越。其真正的差异化路线是 “XPU”异构计算,即将CPU、GPU、AI专用加速器(如Gaudi)、FPGA等通过高速互连集成。为此,自研的互联技术是其异构战略的“骨架”和核心技术壁垒,不可能完全放弃。生态建设的现实需求:必须加入开放阵营 作为市场挑战者,英特尔没有英伟达CUDA生态那样的统治力。要吸引客户(尤其是微软、谷歌等云巨头),就必须证明其产品能与现有基础设施(通常包含多厂商硬件)良好互通。加入并支持UALink这样的开放标准,是降低客户采用门槛、融入多云生态的必经之路。对于英特尔而言,自研互联技术(Xe Link, Foveros)与拥抱开放标准(UALink, CXL)不是非此即彼的选择,而是同时进行的双重战略:对内/底层:用顶尖的自研封装和互连技术(Foveros/EMIB/Xe Link)来保证其AI芯片产品的绝对性能和能效竞争力,这是与英伟达H100、AMD MI300系列正面竞争的硬实力。对外/上层:积极参与并领导CXL、UALink等开放标准,打造开放的、以CPU和通用标准为中心的异构计算生态。这既是团结盟友对抗英伟达的需要,也是其作为系统平台厂商和潜在代工厂商的长期利益所在。Unified BusUB协议在设计上旨在分层支持这四种互联场景,但其在不同层级的物理实现和性能目标有所不同。关于UB是否会全面替换华为原有的HCCS(High-Performance Computing and Communication Switching) 协议,答案是:UB是HCCS在架构上的演进和升级,预计将逐步成为华为未来全场景互联的单一协议栈,但替代过程是渐进的。技术演进关系:HCCS的定位:HCCS是华为早期自研的高速片上互联网络协议,主要用于鲲鹏CPU多核之间以及升腾NPU之间的高速互联18。它类似于AMD的Infinity Fabric或Intel的UPI,实现了多核间的一致性互联,为华为突破单芯片性能瓶颈提供了基础。UB的超越:UB不仅仅是芯片内或板级互联协议,其愿景更宏大——它旨在成为从芯片内到数据中心级别的统一互联架构。UB在协议层抽象了物理介质,可以运行在从封装内裸片链路到长距离光缆的不同物理层上10。替代的必然性与路径:架构代差:UB提供的“对等架构”和“统一内存空间”理念,比HCCS所服务的主从架构更先进,能更好地支撑超大规模智算集群10。产品路线图驱动:华为已经发布了基于UB的Atlas 950/960 SuperPoD超节点和TaiShan 950 SuperPoD通算超节点,这些新一代产品的核心互联已明确采用UB协议2711。这表明在新一代硬件平台上,UB已成为首选。生态统一需求:华为推行“硬件开放、软件开源”策略,一个统一的互联协议栈(UB)有利于降低生态伙伴的开发复杂度和成本712。过渡期安排:短期并存:在现有已部署的基于HCCS的硬件(如某些型号的鲲鹏服务器、升腾910等)生命周期内,HCCS仍将被支持。长期收敛:在2026年及之后的新一代产品(如升腾950、鲲鹏950后续型号)和超节点集群中,UB将全面成为互联基础,HCCS的角色将逐渐弱化或被整合进UB协议栈中311。结论华为Unified Bus是一个雄心勃勃的跨层级统一互联协议,旨在用一套架构覆盖从芯片到数据中心的全场景。它将不仅是HCCS的功能性替代,更是一次互联范式的升级,以适应“数据中心即计算机”的未来算力需求。因此,在华为未来的技术蓝图中,UB将成为唯一的、贯穿各级的互联主干,而HCCS将作为前期技术积累融入并最终收敛到这一主干中。NVlink这个没啥好说,英伟达为继续使用演进根据提供的搜索结果,NVLink技术自诞生至今的演进路线清晰展现了英伟达从构建高速GPU间互联到打造超大规模AI集群网络的雄心。其核心路径是从机内点对点互联演变为跨机箱的网络化超级互联。以下是其主要的演进阶段与关键里程碑:第一阶段:奠基与内部互联 (2016-2017)这一阶段的核心目标是突破PCIe瓶颈,在单台服务器内实现GPU间的高带宽直接通信。首发:NVLink 1.0 - 随Pascal架构(P100 GPU)推出。每块GPU配备4个端口,每个端口由8个速率为20 Gbps的通道组成,单端口双向带宽40 GB/s,单卡总带宽160 GB/s,在当时达到PCIe 3.0带宽的5-10倍。它实现了GPU间的点对点直接内存访问。1389第二阶段:规模化与拥抱CPU (2017-2020)目标从单个连接扩展到多GPU系统全互联,并开始将CPU纳入高速互联生态。NVLink 2.0 / NVSwitch 1.0 - 随Volta架构(V100 GPU)推出。单卡端口数增至6个,单通道速率提升至25 Gbps,单卡总带宽翻倍至300 GB/s。关键的创新是引入了NVSwitch交换芯片(最初18端口),首次实现了8个GPU间的全连接(Full Mesh),并开始支持与IBM POWER CPU的缓存一致性连接。239NVLink 3.0 / NVSwitch 2.0 - 随Ampere架构(A100 GPU)推出。单卡端口数大幅增至12个,采用更高速的50 Gbps通道(每端口4通道),总带宽再次翻倍至600 GB/s。NVSwitch升级至36端口,并支持通过背对背连接组建16卡全互联系统(如DGX A100)。269第三阶段:迈向超级网络 (2022年至今)技术定位从“内部互联”升级为可与InfiniBand竞争的独立网络设备,支撑千卡级AI集群。NVLink 4.0 / NVSwitch 3.0 - 随Hopper架构(H100 GPU)推出。单卡端口数达18个,采用PAM4调制实现100 Gbps通道速率(每端口2通道),单卡总带宽高达900 GB/s。NVSwitch 3.0支持64个端口,并集成了用于集合通信优化的SHARP功能。更重要的是,NVLink Network开始支持通过OSFP光模块进行机箱间的连接,实现了“单一节点”概念的巨大扩展。12469未来:NVLink 5.0及生态系统开放 - 根据路线图,下一代预计采用200 Gbps通道速率,带宽将继续提升。更重大的趋势是英伟达推出NVLink Fusion项目,计划通过IP授权方式,允许第三方厂商(如Intel, Arm, SiFive RISC-V)的CPU或其他加速器接入NVLink网络,旨在构建一个以NVLink为核心、更开放的异构计算生态。1710演进规律总结性能跃进:单通道速率按“20G→25G→50G→100G→200G(预计)”翻倍提升,同时通过增加单卡端口数(4→6→12→18→24预计)实现总带宽的指数级增长。79架构变革:从点对点连接,到引入NVSwitch实现全互联,最终演变为支持光电混合的跨机箱网络。145生态扩张:从专为NVIDIA GPU设计,到逐步开放生态,试图成为未来高性能计算和AI集群的统一互联标准。1011总而言之,NVLink的演进路线清晰地反映了AI计算对互联带宽和规模的需求增长,其发展已超越了单纯的GPU互联技术,成为定义现代超大规模AI基础设施架构的关键基石。PCIePCIe互联在高性能训练场景中的劣势PCIe在算力卡互联中的劣势主要体现在带宽和延迟上,使其难以胜任大规模AI训练任务。在高性能计算场景,尤其是需要多卡紧密协同的大模型训练中,PCIe的共享总线架构与NVLink等专用互联技术存在本质差距。NVLink专为GPU间高速直连设计,提供高达数百GB/s的带宽和微秒级延迟,并支持全互联拓扑;而PCIe最初为外设互联设计,用于多卡通信时带宽有限且延迟较高。例如,RTX 4090集群通过PCIe 4.0互联时,有效P2P带宽仅为理论值的12.5%-18.75%,8卡分布式训练AI模型时通信延迟可达NVLink方案的3.6倍,导致GPU利用率暴跌和大量算力空转。因此,在追求极致效率的数据中心训练场景,纯PCIe互联的算力卡难以与配备NVLink的专业卡竞争。139PCIe在推理、边缘及灵活部署场景中的优势尽管在高性能训练中存在瓶颈,但PCIe凭借其通用性、灵活性和成熟的生态,在推理、边缘计算和企业级部署中仍有显著优势与前途。PCIe接口具有极强的通用兼容性,无需改造服务器架构即可便捷部署,大幅降低了AI算力导入的门槛与成本。这在推理、轻量级训练、工业自动化等场景中至关重要,因为此类任务对通信带宽的要求相对较低,更注重部署的灵活性与经济性。同时,PCIe提供灵活的链路宽度(×1到×16),带宽代际演进清晰(目前已至PCIe 5.0/6.0),能适配不同算力等级的需求。在汽车等新兴领域,PCIe的超低延迟、高可靠性和直接内存访问优势,使其成为实时性要求高的边缘互连方案的补充。因此,专注于推理市场或采用非GPU架构的AI加速卡,完全可以依赖PCIe获得成功。257市场多元化与国产化带来的新兴机会在全球算力市场多元化与供应链自主可控的趋势下,仅使用PCIe互联的算力卡正迎来新的发展机遇。随着美国对高端AI芯片的出口限制,中国市场加速推动国产算力发展。许多国产AI芯片企业,如平头哥、寒武纪、燧原科技等,其产品主要通过PCIe形态切入市场。这些芯片在性能上可能不及顶级国际产品,但凭借PCIe的通用接口,能快速适配现有服务器,满足企业级推理、工业计算等广泛需求。此外,PCIe交换芯片作为算力网络的神经枢纽,在国产化进程中地位关键,其发展支撑了全国一体化算力网的建设。这意味着,在特定市场区域和差异化应用场景中,纯PCIe互联的算力卡不仅具有前途,而且是实现供应链安全与成本控制的重要路径。6810未来演进:CXL融合与专用交换芯片提升潜力PCIe互联的未来前途与其技术演进紧密相关,尤其是通过与CXL协议的融合以及专用交换芯片的智能化发展,PCIe有望突破传统外设接口的局限。未来,PCIe加速卡将随异构计算架构普及和CXL协议成熟进入新发展阶段。CXL建立在PCIe物理层之上,支持缓存一致性与内存池化,这将使通过PCIe连接的加速卡从外设转变为对等计算单元,大幅降低数据搬运开销。同时,专为PCIe优化的交换芯片正朝着超低延迟、CXL融合及光电共封装方向发展,以解决大规模集群的内部通信瓶颈。这些演进将使PCIe互联不仅能继续服务边缘与推理市场,更有潜力参与更复杂的异构计算任务,保持其作为通用高速互连基石的长期价值。
2026年04月16日
56 阅读
0 评论
0 点赞
2026-04-16
AI专题十三:地球上算力芯片参数汇总、整理、对比
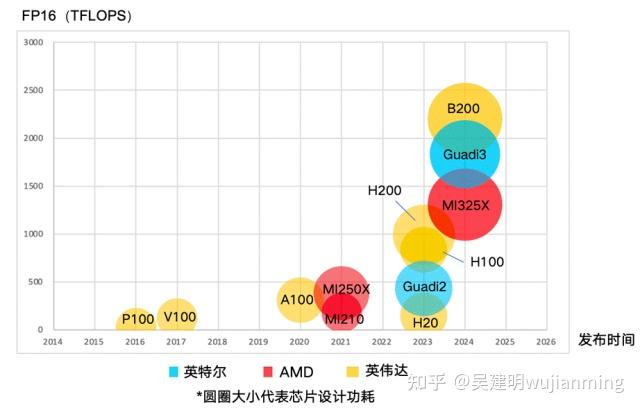
摘自:https://zhuanlan.zhihu.com/p/1908027882829244313前言:AI大模型能力的快速提升(如Qwen3、Llama4的多模态升级与逻辑推理优化)正推动AI从辅助工具向核心生产力渗透。而算力芯片的性能对大模型的训练、推理至关重要。本文通过统计全球主要算力芯片的算力、显存和互联带宽指标,对比海外第三方设计公司、海外大厂自研和国产芯片的单卡性能。不考虑软件(如CUDA)、Scale out架构(如华为CloudMatrix超节点)和成本。华为芯片缺少官方公布数据,所有暂时没有收录。英伟达、英特尔、AMD英伟达的芯片覆盖最广,包括高性能的H100、H200和B200,以及较早的V100、P100等,其产品线在算力和迭代速度均占据领先地位。英特尔的AI芯片为Guadi系列(如Guadi3),而AMD是MI系列(如MI325X、MI250X)。从时间线看,英伟达迭代速度最快,2023年后密集发布新品;AMD的MI300系列和英特尔的Guadi3则瞄准了同期的英伟达B200竞争。功耗设计上,英伟达B200的圆圈显著更大,凸显其高功耗高性能定位。美国互联网大厂谷歌的TPU系列最为成熟,从v2到v7p逐步提升算力,其中v5p和v7p的能效比设计突出;亚马逊的Trainium3、Meta的MTIA v2和微软的Maia 100是较新的竞争者,发布时间集中在2023-2024年。这些芯片的算力普遍低于英伟达旗舰(如TPU v7p的FP16性能接近B200),但功耗更低(圆圈较小),反映其优化能效的特点。谷歌的TPU发布时间跨度大,显示其长期投入,而Meta、亚马逊和微软的布局更晚但速度迅猛。国产芯片寒武纪的思元590、海光信息的BW100和沐曦科技的曦云C500在算力和功耗上领先,发布时间集中于2023-2024年。整体来看,国产芯片的算力水平与英伟达中端产品(如A100)接近,但功耗控制更分散(圆圈大小差异大),反映技术路线多样性。发布时间显示2020年后中国AI芯片进入爆发期,但国际巨头仍保持性能代差。一、算力指标制程:海外:第三方设计公司:为后续产品制程的升级预留了空间。英伟达最新的Blackwell系列使用了TSMC 4NP,相当于4nm高性能版本。AMD、英特尔最新产品的制程都是5nm。Groq为了追求性价比,使用GlobalFoundries的14nm。大厂自研:谷歌最新的TPU Ironwood(TPU v7p)和亚马逊的Trainium3都使用了最先进的3nm,Meta和微软使用了5nm。中国大陆:国内厂商在受到制裁之前,旗舰产品绝大多数都是使用TSMC 7nm。目前正在转向中芯国际7nm。燧原科技的所有产品都采用GlobalFoundries 的12nm工艺。晶体管数量/芯片面积/晶体管密度:芯片面积:由于掩膜版的尺寸,单个芯片最大曝光区面积限制为858mm²,可以通过Chiplet构建更大的芯片。晶体管密度:更高的晶体管密度允许在相同芯片面积内集成更多计算核心,直接提升并行计算能力。海外:第三方设计公司:英伟达的B200首次使用了Chiplet技术,包含了两个B100 Die,两个Die通过NV-HBI互联,芯片面积达到1600mm²,晶体管密度达到130百万/mm²。AMD的芯片一直都采用Chiplet,由许多小芯粒组成大芯片,芯粒之间通过Infinity Fabric互联.大厂自研:谷歌最新的TPU Ironwood(TPU v7p)晶体管密度达到了308 百万/mm²,是英伟达Blackwell的两倍多。TPU v6e和微软的Maia 100分别达到110百万/mm²和128百万/mm²。中国大陆:国内厂商多使用Chiplet技术,增强算力、降低成本。燧原科技2021年发布的邃思2.0的芯片面积3306 mm²,采用GlobalFoundries 12nm工艺,号称中国最大AI单芯片,达到了日月光 2.5D 封装的极限。各浮点运算次数海外:第三方设计公司:英伟达Blackwell系列的推出,巩固了其在深度学习训练和推理的领导地位。GB200的FP16算力达到5000TFLOPS,相比于H200提升了5倍以上。AMD的MI325X为1300TFLOPS,英特尔Gaudi3为1835TFLOPS,谷歌TPU Ironwood(TPU v7p)为2307TFLOPS,与GB200都有明显差距。同时,Blackwell通过第二代Transformer引擎和定制Tensor Core,首次在硬件上实现了FP4数据类型的直接处理。H20/H800:H20基于H200进行性能裁剪,通过牺牲计算性能换取合规性。H20的FP16算力为148 TFLOPS,FP8算力为296 TFLOPS,仅为H200的15%左右。H800与H100算力指标保持一致,根据美国商务部2023年10月17日发布的出口管制新规,H800 被列入禁售名单。大厂自研:多数ASIC聚焦于低精度领域,除谷歌外都处于起步阶段。谷歌最新的TPU Ironwood(TPU v7p)是首款专为推理而设计的加速器,FP16算力达2307TFLOPS,比前代提升了两倍多。亚马逊的Trainium3预计FP16算力达1310TFLOPS,是Trainium2的两倍。中国大陆:除华为外,FP16算力能达到300TFLOPS以上的国产芯片,只有寒武纪的思元590和海光信息的BW100。壁仞科技在2022年推出的BR100的FP16算力能达到1024TFLOPS,但因受到制裁,无法量产落地。功耗/能效比能效比:FP16运算次数/功耗(TFLOPS/W)海外:第三方设计公司:英伟达Blackwell的能效比在所有架构里面最高,体现英伟达超强的硬件设计能力。尽管GB200的功耗达到了2700W,但能效比仍能达到1.9,在业内处于领先地位。大厂自研:多数ASIC的功耗在700W以下,达到降本目的。但能效比仍低于英伟达的GPGPU。中国大陆:根据不完全统计,国产芯片的功耗绝大多数都在500W以下,能效比低于1。二、显存指标显存/显存带宽/显存容量海外:绝大多数海外厂商最新产品都配备HBM3e,因堆叠层数、频率和HBM堆栈数量的配置不同,显存带宽和容量不同。英伟达从H200开始使用HBM3e。GB200的显存带宽达16TB/s,容量达384GB,是H200的三倍多。H20和H800的显存分别与H200和H100保持一致,远高于国产芯片。中国大陆:因受到制裁,绝大多数国产芯片最新产品使用HBM2e。除采用HBM外,还有国产芯片使用GDDR和LPDDR。如昆仑芯二代芯片和摩尔线程S4000、S3000均使用GDDR6,寒武纪MLU370系列均使用LPDDR5。算术强度算术强度:总浮点运算次数/内存带宽(FLOPS/Byte) 算术强度过高,说明内存带宽过低,芯片运行有内存瓶颈。海外:英伟达H100的算术强度较高,接近600FLOPS/Byte,随着HBM3e的使用,算术强度在H200和Blackwell系列逐渐降低。其他厂商因使用HBM3e且算力不高,算术强度都较低。中国大陆:国产芯片的算力水平较低,所以尽管显存带宽低,算术强度都较低,不存在带宽瓶颈。三、互联带宽双向互联带宽=每条链路单向带宽x链路数x 2海外:绝大多数厂商都开发了专有协议,带宽普遍在500GB/s以上。英伟达的NVLink5相比于NVLink4带宽翻倍,达到了1800GB/s。英伟达的NVLink依然有较强壁垒。AMD的Infinity Fabric4达到896GB/s。谷歌的ICI Links最高能达到672GB/s。H20使用NVLink4,带宽达到900GB/s,相较于国产芯片有较大优势。H800和A800都使用特供版NVLink,带宽只有400GB/s。中国大陆:国产芯片的互联能力普遍较弱,除华为外,带宽普遍在400GB/s以下。寒武纪思元270和思元590采用的MLU-Link,带宽分别达到600GB/s和372GB/s。海光信息BW100和沐曦科技的曦云C500的互联带宽能达到400GB/s。References:[1]英伟达:公司官网https://www.nvidia.cn/CSDN博客https://blog.csdn.net/qq_39815222/article/details/136897603墨天轮https://www.modb.pro/db/1830075219425452032[2]AMD:公司官网https://www.amd.com/zh-cn.html[3]英特尔:公司官网https://www.intel.cn/content/www/cn/zh/homepage.html[4]Groq:http://Sacra.comhttps://sacra.com/c/groq/[5]谷歌:The Next Platformhttps://www.nextplatform.com/2025/04/09/with-ironwood-tpu-google-pushes-the-ai-accelerator-to-the-floor/[6]亚马逊:Semianalysishttps://semianalysis.com/2024/12/03/amazons-ai-self-sufficiency-trainium2-architecture-networking/[7]Meta:公司官网https://ai.meta.com/blog/next-generation-meta-training-inference-accelerator-AI-MTIA/[8]微软:Semianalysishttps://semianalysis.com/2023/11/15/microsoft-infrastructure-ai-and-cpu/[9]寒武纪:公司官网https://www.cambricon.com/格隆汇https://finance.sina.com.cn/wm/2025-01-19/doc-inefpcsy0554481.shtml北方算网https://zhuanlan.zhihu.com/p/18044815862[10]昆仑芯:电子元件采购网https://www.ameya360.com/hangye/108036.html电子元器件采购网https://www.ameya360.com/hangye/108036.html知乎https://zhuanlan.zhihu.com/p/603925398捷睿星云http://www.jieruixingyun.com/busniess/intro/百度昆仑芯Product Briefhttps://paddlelite-demo.bj.bcebos.com/devices/baidu/K100_K200_spec.pdf[11]平头哥:公司官网https://img.102.alibaba.com/1622193035686/9898014ba4eb8adfd3f31db3b2cf26f3.pdf?spm=a2ouz.12987056.0.0.68229352l5LGSa&file=9898014ba4eb8adfd3f31db3b2cf26f3.pdf集微网https://www.sohu.com/a/374479009_166680[12]海光信息:鲸起Studiohttps://mp.weixin.qq.com/s/Oq3HZxFwOJuLTuwzj9RYQw北方算网https://zhuanlan.zhihu.com/p/18044815862华西证券研究所http://www.qdatis.com/files/20250207/447df7d38b08845b0b7fdf376030fd19.pdf格隆汇https://finance.sina.com.cn/wm/2025-01-19/doc-inefpcsy0554481.shtml[13]燧原科技: 美通社https://www.prnasia.com/story/296402-1.shtml与非网https://www.eefocus.com/article/498969.html智东西https://chedongxi.com/news/21214.htmlIT之家https://news.qq.com/rain/a/20211208A02G3B00[14]摩尔线程:公司官网https://www.mthreads.com/product/S3000TechPowerUphttps://www.techpowerup.com/316881/moore-threads-launches-mtt-s4000-48-gb-gpu-for-ai-training-inference-and-presents-1000-gpu-cluster[15]沐曦科技:CSDN博客https://blog.csdn.net/qq_23934063/article/details/132473834飞桨https://www.paddlepaddle.org.cn/support/news?action=detail&id=3334[16]壁仞科技:第一财经https://m.yicai.com/news/101501217.html电子工程专辑https://www.eet-china.com/mp/a152602.html[17]天数智芯:电子发烧友https://www.elecfans.com/d/2253998.html安信力http://www.anssionic.com/sgproducts_view.asp?main_id=20&small_id=71&id=244
2026年04月16日
72 阅读
0 评论
0 点赞
2026-04-14
AI专题十一:AI系统全景概述
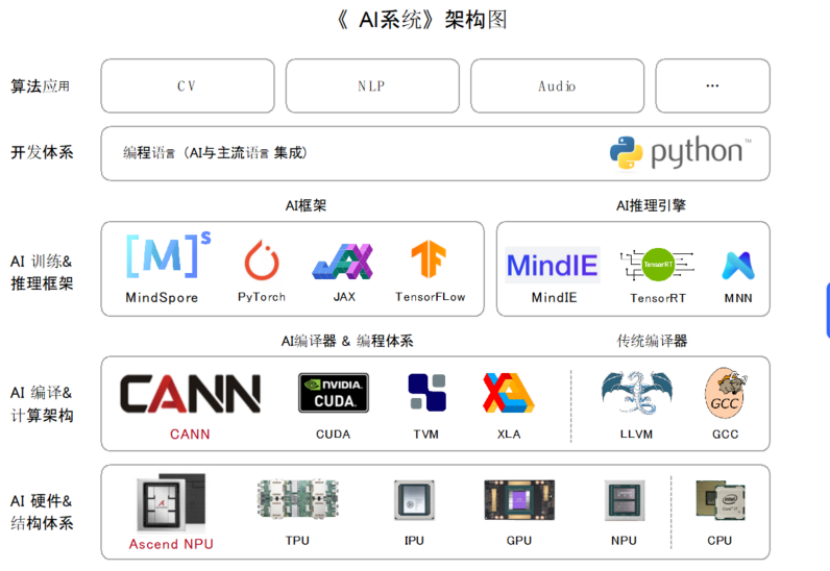
部分内容来自:https://www.cnblogs.com/ZOMI/articles/18555010AI 系统:AI 时代连接硬件和上层应用的中间层软硬件基础设施。因此在部分语境中,又有人称为 AI Infra 人工智能的基础设施,但是因为基础设施更偏向于底层硬件、集群等内容,而 AI 系统是多的是强调让 AI 执行起来的系统体系结构,因此更愿意称包括软硬件的内容为 AI 系统。传统本地部署时代,三大基础软件(数据库、操作系统、中间件)实现控制硬件交互、存储管理数据、网络通信调度等共性功能,抽象并隔绝底层硬件系统的复杂性,让上层应用开发者能够专注于业务逻辑和应用功能本身的创新实现。云时代同理,形成了 IaaS、PaaS、SaaS 三层架构,其中 PaaS 层提供应用开发环境和基础的数据分析管理服务。类比来看,我们认为,进入 AI 时代也有承担类似功能的、连接算力和应用的基础设施中间层即 AI 系统,提供基础模型服务、赋能模型微调和应用开发。包括了如下图几个方面:大模型(算法应用)-AI训练和推理框架-AI编译和计算架构-AI硬件体系这四大体系的主要技术栈:下面分开简述这四大体系:AI 大模型AI 大模型框架实现解析:以 DeepSeek 系列为例目前主流 AI 大模型(包括 DeepSeek 系列)的底层实现主要依托于 PyTorch 生态,但在此基础上构建了高度定制化的训练与推理基础设施。具体的技术栈通常不对外完全公开,但通过开源模型结构与行业惯例可以推断其核心架构。以下是关于 AI 大模型实现框架的核心要点分析:.基础深度学习框架:PyTorch 主导 绝大多数现代大模型(包括 DeepSeek、Llama 系列)均使用 PyTorch 作为基础开发框架。PyTorch 的动态图机制便于模型调试与研究,其丰富的生态库(如 torch.nn、torch.distributed)为构建复杂的 Transformer 架构提供了标准接口。..分布式训练基础设施:定制化加速 为了支撑千亿参数规模的训练,团队通常会在 PyTorch 之上集成 DeepSpeed 或 Megatron-LM 等分布式库,甚至开发内部专有系统。针对 DeepSeek 特有的 MoE(混合专家)架构,训练框架需专门优化专家路由与负载均衡算法,以实现高效的稀疏计算。..推理引擎与部署优化:高性能运行时 模型部署阶段通常不再直接使用原生 PyTorch,而是转换为高性能推理引擎。常见的方案包括 vLLM、TensorRT-LLM 或自研推理后端,通过算子融合、量化(INT8/FP8)及显存优化技术,显著降低延迟并提升吞吐率。..模型互操作性与开源生态 为了兼容不同硬件与框架,大模型权重常支持导出为 ONNX 或 Safetensors 格式。DeepSeek 等开源模型允许社区在 Hugging Face 等平台直接加载,这意味着其结构定义遵循通用的 Transformers 库规范,便于跨框架迁移与二次开发。.综上所述,虽然具体的内部工程细节属于企业机密,但基于 PyTorch 的开源生态配合定制化分布式训练与推理引擎,是目前包括 DeepSeek 在内的大模型行业通用技术路径。这种架构既保证了研发的灵活性,又满足了生产环境对性能与稳定性的严苛要求。AI 训练与推理框架AI 训练和推理框架是深度学习生态系统中的基础设施,主要用于简化模型的开发、优化及部署流程。PyTorch 和 TensorFlow 确实属于这类框架,它们不仅支持模型的训练过程,也提供了推理能力,但在实际生产环境中,二者往往配合专用的推理引擎使用。框架的核心职能:从算法到算力的桥梁AI 框架的核心价值在于屏蔽底层硬件差异,让开发者专注于算法逻辑。它们通过自动微分机制计算梯度,利用计算图优化技术调度资源,从而实现高效的模型迭代。训练阶段:负责数据加载、前向传播、损失计算、反向传播及参数更新,支持分布式训练以加速大规模模型收敛。推理阶段:加载训练好的权重,对新数据进行预测计算,注重低延迟、高吞吐及内存占用优化。PyTorch 与 TensorFlow 的定位与差异这两款主流框架均覆盖了训练与推理的全链路,但设计哲学略有不同。PyTorch 以其动态图机制和灵活的 Python 接口著称,深受学术界和研发人员喜爱;TensorFlow 则拥有成熟的静态图优化能力和强大的服务端部署生态(如 TF Serving),在企业级生产中应用广泛。通用性:两者均支持构建复杂的神经网络结构,并提供丰富的预训练模型库。部署能力:虽然都支持直接推理,但为了极致性能,通常会将模型导出为中间格式(如 ONNX)或使用专用编译器(如 TorchScript、TFLite)进行加速。训练框架与推理引擎的生态协同在实际工程落地中,"训练框架"与"推理引擎"常有分工。训练框架侧重灵活性与易用性,而推理引擎侧重性能与资源管控。模型导出:训练完成后,模型常被转换为特定格式(如 .pt、.pb、.onnx),以便在不同硬件上运行。专用加速:生产环境常使用 TensorRT、OpenVINO 等推理引擎加载框架导出的模型,以充分发挥 GPU 或 NPU 的算力,实现比原生框架推理更高的效率。核心能力总结为了更清晰地理解这两类框架的功能边界,以下列举其关键能力:自动微分系统:自动计算梯度,免除手动推导公式的繁琐,是训练深度学习模型的基础。计算图优化:通过算子融合、内存复用等技术,减少计算开销并提升执行效率。硬件抽象层:统一接口支持 CPU、GPU 及各类 AI 加速芯片,实现代码的跨平台运行。生态工具链:提供数据预处理、模型可视化、调试及部署服务的一站式解决方案。动态与静态模式:支持动态图便于调试研发,支持静态图便于生产部署优化。综上所述,PyTorch 和 TensorFlow 是典型的 AI 训练与推理框架,它们构成了现代人工智能开发的主干。但在高性能部署场景下,通常会结合专用的推理引擎或编译器,以实现从算法研发到终端落地的最佳性能平衡。类似验证中的UVM、OVMAI编译器概述编译器可以将整个程序转换为目标代码(object code),这些目标代码通常存储在文件中。目标代码也被称为二进制代码,在进行链接后可以被机器直接执行。典型的编译型程序语言有 C 和 C++。当前,AI 编译器的发展阶段似乎回到了 GCC 出现之前的时代。每家 AI 芯片公司都在推出自己的 AI 编译器、框架 甚至软件栈,市场上出现了极度碎片化的现象。这种理解抓住了 AI 编译器的核心流向,但在具体的技术实现细节上存在简化。AI 编译器的工作流程比“直接编译 Python 到二进制”更为复杂,涉及多层抽象与优化。以下是对其输入输出机制的详细解析:输入层面:计算图与中间表示(IR)而非纯 Python 代码AI 编译器的直接输入通常不是原始的 Python 脚本,而是由深度学习框架(如 PyTorch、TensorFlow)生成的计算图(Computational Graph)或中间表示(IR)。技术细节:Python 在此过程中主要充当“宿主语言”,用于定义模型结构。编译器前端会通过追踪(Tracing)或图捕获(Graph Capture)技术,将 Python 代码转换为与语言无关的中间表示(如 ONNX、TorchScript、HLO 等)。原因:直接编译动态类型的 Python 代码效率极低,转换为静态 IR 后,编译器才能进行算子融合、内存优化等高级变换。输出层面:运行时引擎与集成库而非单一 Kernel 文件编译后的产出物通常不是一个独立的 GPU Kernel 二进制文件,而是一个包含多个优化算子、内存管理逻辑及调度策略的运行时库或模型引擎。技术细节:最终产物可能是动态链接库(.so/.dll)、序列化模型文件(如 TensorRT 的 .engine 或 TVM 的 .tar),其中封装了多个针对特定硬件优化的 Kernel 代码(如 CUDA PTX 或机器码)。原因:深度学习模型由成百上千个算子组成,编译器需要生成完整的执行计划,处理数据搬运、内核启动及同步,单一二进制文件无法承载完整的推理逻辑。Python 的角色:接口调度而非计算主体在整个编译与部署链路中,Python 主要承担接口调用与数据调度的角色,而非实际计算负载的承担者。技术细节:在推理阶段,Python 脚本负责加载编译好的二进制引擎,将输入数据张量传递给底层运行时,由编译后的 native 代码在 GPU 上执行密集计算。补充信息:这种架构设计实现了“开发效率”与“运行性能”的解耦,开发者使用友好的 Python 生态,而机器执行高效的底层二进制指令。综上所述,AI 编译器实质上是一个将高层模型描述转换为硬件专属高效指令集的翻译与优化系统,其核心价值在于屏蔽硬件差异并最大化算力利用率。AI硬件架构AI硬件架构主要包括CPU、GPU、TPU、NPU和LPU五大类型,并通过系统级协同和混合部署实现高效算力支撑。核心硬件类型与特点CPU(中央处理器)CPU专为通用计算设计,适合处理复杂逻辑、分支和系统级任务,严格遵循冯·诺依曼结构,核心包括控制单元和算术逻辑单元(ALU)。在AI系统中,CPU负责任务调度、队列管理、资源分配以及强化学习(RL)环境的仿真和多智能体控制。 GPU(图形处理器)GPU擅长大规模并行浮点运算,适合深度学习训练和推理。现代GPU通过CUDA、Tensor Core等技术支持通用计算,成为AI计算的核心加速器。 TPU(张量处理单元)TPU是Google开发的专用AI加速器,针对矩阵运算和深度学习优化,提供高吞吐量和低延迟,适合大规模模型训练和推理。NPU(神经网络处理器)NPU面向边缘设备和移动端AI应用,优化低功耗、高效推理,支持语音识别、图像处理等任务。LPU(逻辑处理单元)LPU用于特定逻辑加速场景,如AI推理中的规则计算和控制逻辑,通常与NPU或GPU协同工作。来源系统级协同与混合部署CPU-GPU协同:在多智能体、强化学习和复杂仿真场景中,CPU负责环境步进、控制逻辑和数据管理,GPU负责梯度计算和模型训练。提高CPU:GPU比值可优化GPU利用率,降低空转和延迟。 混合算力架构:结合本地GPU与云端租用GPU,形成“本地核心算力池+云端弹性算力池”,既保证数据安全和低延迟,又能应对突发峰值需求,实现成本和效率的平衡。 AI应用解决方案中的硬件架构成熟的AI应用通常由三大模块构成:智能硬件终端:支持多模态交互,如语音、人脸、触觉等。AI技术中台:提供核心算力和模块化能力,快速响应定制化需求。数据服务体系:收集用户行为数据,进行分析和策略输出,实现全链路闭环的智能决策。 发展趋势AI芯片市场持续增长,专用推理芯片和系统级性能优化成为核心竞争力。CPU与GPU的协同效率将成为数据中心设计重点,系统级优化取代单芯片性能。混合部署和垂直整合将加速,满足大模型训练、实时推理和多任务并发需求。 通过理解这些硬件架构及其协同方式,开发者可以根据应用场景选择合适的算力方案,实现AI系统的高效运行。
2026年04月14日
36 阅读
0 评论
0 点赞
2026-04-10
AI专题八:大模型的指标与评估方法
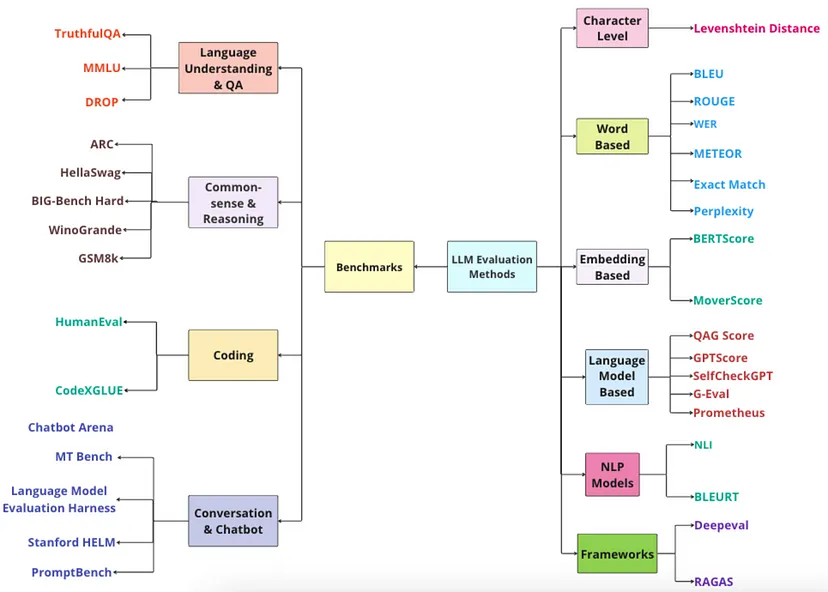
来自:https://zhuanlan.zhihu.com/p/26098146564首先,通过下面的表格来了解传统机器学习、深度学习和大语言模型之间的区别。大语言模型的出现为解决以往被认为不可能的问题开辟了新途径。但有一个问题仍待解答:如何有效地评估基于大模型的应用程序呢?在本文中,我们将试图揭开这个谜题,了解用于基准测试大语言模型的方法,讨论最前沿(SOTA)的方法、可用的框架,以及评估基于大语言模型的应用程序时面临的挑战。评估大语言模型的基本思路从哪里开始评估大语言模型?模型选择至关重要,因为它会影响项目的最终结果。在选定模型后,下一步就是思考如何评估它。许多从业者最初会依赖提示工程来评估模型的选择,但这不足以全面评估大语言模型的有效性,我们需要一个更全面的评估策略。模型评估是复杂的,涉及各种指标,这些指标因优先事项而异,无论是优先考虑准确性、成本效益还是性能。你选择的方向应与特定需求保持一致,确保所选模型不仅适用,还能优化你的应用场景。在为应用选择最佳大语言模型时,可参考以下简化方法(上图中有更多详细信息):是否有标准答案?是:如果模型提供离散输出,可使用传统的准确率指标。若不是,则考虑其他相似性指标,如ROUGE。否:进入步骤2。是否需要自动化评估?是:使用大语言模型评判器或评估器。否:进入步骤3。是否面临时间限制?是:选择独立指标,如文本质量、可读性或困惑度。否:黄金标准是人工评估。虽然它速度较慢且成本较高,但由于需要大量人力投入,能提供最可靠的反馈。接下来,我们将详细讨论这些技术。大语言模型基准测试与评估的差异虽然大语言模型的基准测试和评估紧密相关,但它们的目的存在细微差别:基准测试主要是标准化测试。它使用预定义的数据集和指标,评估大语言模型在特定任务上的表现。可以把它想象成给语言模型进行阅读、写作和数学测试(只不过是针对语言的测试!)。基准测试的优势如下:便于比较:研究人员可以通过基准测试,比较不同大语言模型在相同任务上的性能,有助于确定哪些模型在特定领域表现出色。量化结果:基准测试提供数值分数,清晰展示大语言模型的优势和劣势。评估的范围则更为广泛。它不仅仅是运行测试,还包括对大语言模型能力更全面的评估。在评估时,研究人员会考虑以下方面:实际适用性:大语言模型在模拟现实应用场景中的表现如何?公平性和偏差:大语言模型的输出是否存在偏差?可解释性:研究人员能否理解大语言模型得出答案的过程?评估通常以基准测试为基础。研究人员可能会将基准测试分数作为起点,但也会深入探究基准测试未涵盖的方面。简单来说,基准测试通过标准化测试进行定量评估,而评估则能让我们更定性地了解大语言模型的整体优势、劣势以及对现实应用的适用性。大语言模型基准测试大语言模型基准测试框架大语言模型基准测试是一组标准化测试,旨在评估大语言模型在各种技能(如推理和理解能力)上的表现,并使用特定的评分器或指标来衡量这些能力。根据不同的基准测试,指标范围可以从基于统计的度量(如精确匹配的比例),到由其他大语言模型评估的更复杂的指标。不同的基准测试评估模型能力的不同方面,包括:推理和常识:这些基准测试大语言模型运用逻辑和日常知识解决问题的能力。语言理解和问答(QA):评估模型解释文本和准确回答问题的能力。编码:该类别基准测试评估大语言模型解释和生成代码的能力。对话和聊天机器人:测试大语言模型参与对话并提供连贯、相关回复的能力。翻译:评估模型将文本从一种语言准确翻译成另一种语言的能力。数学:聚焦于模型解决数学问题的能力,从基础算术到微积分等更复杂的领域。逻辑:逻辑基准测试评估模型应用逻辑推理技能(如归纳和演绎推理)的能力。标准化测试:学术水平测试(如SAT、ACT)或其他教育评估也用于评估和基准测试模型的性能。有些基准测试可能只有几十项测试,而其他的可能包含数百甚至数千个任务。重要的是,大语言模型基准测试为跨不同领域和任务评估大语言模型的性能提供了标准化框架。为项目选择合适的基准测试意味着:• 目标一致:确保基准测试与大语言模型需要出色完成的特定任务相匹配。• 任务多样:选择具有广泛任务的基准测试,能全面评估大语言模型。• 贴合领域:选择与应用相关领域的基准测试,无论是理解语言、生成文本还是编码。可以把它们想象成高中生的学术水平测试,只不过是针对大语言模型的。虽然它们无法评估模型能力的方方面面,但确实能提供有价值的见解。下面是Claude 3在多个基准测试中与其他最前沿模型的性能对比。在接下来的部分,我们将讨论4个关键领域(语言理解、推理、编码和对话)的主要大语言模型基准测试。这些基准测试在行业应用中广泛使用,并经常在技术报告中被引用,包括:语言理解和问答基准测试3.1.1 TruthfulQA发布时间:2022年论文代码数据集点击可查看,或者文末在参考文献中查找目标:基于模型提供准确和真实答案的能力对其进行评估。这对于打击错误信息和促进人工智能的道德使用至关重要。• 数据集:原始数据集包含38个类别的817个问题,涵盖健康、法律、金融和政治等类别。问题聚焦于人类可能因错误信念或误解而给出错误答案的领域。• 性能:原始论文中表现最佳的模型GPT-3,成功率仅为58%,而人类基线为94%。• 评分:最终分数基于模型生成的真实输出的比例计算。经过微调的GPT-3(称为“GPT-Judge”)用于判断答案的真实性。3.1.2 MMLU(大规模多任务语言理解)• 发布时间:2021年• 论文代码数据集点击可查看,或者文末在参考文献中查找目标:基于模型的预训练知识评估模型,专注于零样本和少样本设置。基准测试:综合基准测试,通过涵盖57个学科(包括STEM、人文、社会科学等)的选择题评估模型,难度级别从基础到高级不等。该基准测试能很好地识别模型在特定领域的知识差距。评分:MMLU根据正确答案的比例对大语言模型进行评分。输出必须完全匹配才被视为正确(如上述示例中的“D”)。如果觉得MMLU难以使用,有个好消息。有人在开源大语言模型评估框架DeepEval中实现了几个关键基准测试,这样我们只需几行代码就能轻松对任何选定的大语言模型进行基准测试。首先,安装DeepEval:pip install deepeval然后,运行基准测试:from deepeval.benchmarks import MMLU from deepeval.benchmarks.tasks import MMLUTask benchmark = MMLU( tasks=[MMLUTask.HIGH_SCHOOL_COMPUTER_SCIENCE, MMLUTask.ASTRONOMY], n_shots=3 ) benchmark.evaluate(model=mistral_7b) print(benchmark.overall_score)更多实现细节,请访问DeepEval MMLU文档。3.1.3 DROP描述:DROP要求大语言模型对段落进行离散推理。这涉及解析问题中的引用,并执行加法、计数或排序等操作,需要对段落内容有全面的理解。评估设置:3次示例指标:在9536个段落理解问题上的F1分数论文:DROP: A Reading Comprehension Benchmark Requiring Discrete Reasoning Over Paragraphs以上就是开源大语言模型排行榜的七个主要基准测试任务。这些测试不仅评估大语言模型的知识,还评估它们的推理、理解和解决问题的能力。其他值得注意的语言理解和问答基准测试:GLUE、SuperGLUE、SQuAD和GPT任务、CoQA、QuAC、TriviaQA。常识和推理基准测试3.2.1 ARC(AI2推理挑战)发布时间:2018年论文代码点击可查看,或者文末在参考文献中查找描述:AI2推理挑战(ARC)使用小学水平的选择题科学问题测试大语言模型,问题难度从简单到复杂不等。例如,“光合作用产生什么帮助植物生长?”,选项为(a)水 (b)氧气 ©蛋白质 (d)糖。评估设置:25次示例指标:在3548个问题上的准确率,其中33%被指定为具有挑战性的问题。论文:Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge数据集:数据集大小为681MB,分为两组问题:ARC-Easy和ARC-Challenge。3.2.2 HellaSwag• 发布时间:2019年• 论文代码数据集描述:HellaSwag通过句子补全评估大语言模型的常识推理能力。它测试大语言模型是否能从10,000个句子的4个选项中选择合适的结尾。在预训练阶段,当时的最前沿模型得分很难超过50%,而2023年GPT-4通过10次示例提示达到了创纪录的95.3%。与MMLU类似,HellaSwag根据模型给出的完全正确答案的比例进行评分。使用方法:通过DeepEval使用HellaSwag基准测试的方法如下:from deepeval.benchmarks import HellaSwagfrom deepeval.benchmarks.tasks import HellaSwagTaskbenchmark = HellaSwag(tasks=[HellaSwagTask.TRIMMING_BRANCHES_OR_HEDGES, HellaSwagTask.BATON_TWIRLING], n_shots=5)benchmark.evaluate(model=mistral_7b)print(benchmark.overall_score)更多信息,请访问DeepEval的HellaSwag文档页面。3.2.3 BIG-Bench Hard(超越模仿游戏基准测试)发布时间:2022年、代码、数据集:论文代码数据集描述:BIG-Bench Hard(BBH)从最初的BIG-Bench套件中选择了23个具有挑战性的任务,该套件包含204个任务,这些任务在当时超出了大多数语言模型的能力范围。评估方式对比:标准(少样本)提示与思维链(CoT)提示(Wei等人)。在BIG-Bench发布时,没有一个最前沿的语言模型能够在这23个任务中的任何一个上超过平均人类评估者的表现。有趣的是,BBH的作者使用思维链提示,在其中17个任务上超越了人类表现。评分方式:虽然BBH的预期输出比其他基于选择题的基准测试更加多样化,但它同样基于精确匹配的比例对模型进行评分。思维链提示有助于使模型输出符合预期格式。使用方法:使用BBH基准测试的方法如下:from deepeval.benchmarks import BigBenchHard from deepeval.benchmarks.tasks import BigBenchHardTask benchmark = BigBenchHard( tasks=[BigBenchHardTask.BOOLEAN_EXPRESSIONS, BigBenchHardTask.CAUSAL_JUDGEMENT], n_shots=3, enable_cot=True ) benchmark.evaluate(model=mistral_7b) print(benchmark.overall_score)3.2.4 WinoGrande描述:WinoGrande测试人工智能的常识推理能力,要求模型解决Winograd Schema Challenge(WSC)。例如,完成句子:“门打开的声音比窗户大,因为___(选项:门或窗户)的铰链上有更多油脂。”评估设置:5次示例指标:在1267个问题上的准确率论文:WinoGrande: An Adversarial Winograd Schema Challenge at Scale3.2.5 GSM8k描述:GSM8K提供小学数学应用题,测试大语言模型的多步数学推理能力。例如:“一件长袍需要2卷蓝色纤维和蓝色纤维数量一半的白色纤维。总共需要多少卷纤维?”答案是3卷。评估设置:5次示例指标:在1319个问题上的准确率论文:Training Verifiers to Solve Math Word Problems其他值得注意的常识和推理基准测试:CommonsenseQA、COPA、SNLI、MultiNLI、RACE、ANLI、PIQA、COSMOS QA。编码基准测试3.3.1 HumanEval发布时间:2021年论文代码数据集描述:HumanEval由164个独特的编程任务组成,旨在评估模型的代码生成能力。这些任务涵盖从算法到编程语言理解的广泛领域。3.3.2 CodeXGLUE发布时间:2021年论文代码数据集![mnsif8描述:CodeXGLUE提供10个不同任务的14个数据集,用于在各种编码场景(如代码补全、代码翻译、代码摘要和代码搜索)中直接测试和比较模型。它是由微软开发部门和必应合作开发的。评估指标:CodeXGLUE的评估指标因编码任务而异,从精确匹配到BLEU分数不等。其他值得注意的编码基准测试:CodeBLEU、MBPP、Py150、MathQA、Spider、DeepFix、Clone Detection、CodeSearchNet。生成式人工智能模型根据其在4个数据集上的平均性能进行排名:ARC(25次示例)HellaSwag(10次示例)MMLU(5次示例)TruthfulQA(零样本)25次示例意味着在每个问题的提示中插入数据集中的25对(问题,解决方案)。3.4对话和聊天机器人基准测试3.4.1 Chatbot Arena(由LMSys开发)发布时间:2024年论文 代码Chatbot Arena是一个使用超过20万个人类投票对语言模型进行排名的开放平台。用户可以匿名向ChatGPT或Claude等人工智能模型提问并进行评判,且只有在模型身份保持隐藏的情况下,投票才会计入排名。所以它不是一个使用指标客观评分的传统基准测试!分数本质上就是 “点赞” 的数量。3.4.2 MT Bench发布时间:2021年论文 代码 数据集MT-bench通过向聊天助手提出一系列多轮开放式问题来评估其质量,并利用大语言模型作为评判者。这种方法测试了聊天助手处理复杂交互的能力。MT-Bench使用GPT-4对对话进行10分制评分,并计算所有轮次的平均分数以得到最终得分。所有这些基准测试在评估特定技能方面都非常有用,但是如果现有的基准测试与我们项目的独特需求不太匹配呢?3.4.3 语言模型评估工具包(由EleutherAI开发)语言模型评估工具包(Language Model Evaluation Harness)提供了一个统一的框架,用于在大量评估任务上对大语言模型进行基准测试。我特意强调 “任务” 这个词,因为在Harness(我将用Harness代替语言模型评估工具包)中没有 “场景” 这个概念。在Harness中,我们可以看到许多任务,每个任务包含不同的子任务。每个任务或一组子任务在不同领域评估大语言模型,比如生成能力、在不同领域的推理能力等。每个任务下的子任务(甚至有时任务本身)都有一个基准数据集,并且这些任务通常与一些在评估方面的重要研究相关。Harness致力于将所有这些数据集、配置和评估策略(比如与评估基准数据集相关的指标)统一并整合在一个地方。不仅如此,Harness还支持不同类型的大语言模型后端(例如:VLLM、GGUF等)。它在更改提示和进行实验方面具有很大的可定制性。下面是一个如何在HellaSwag任务(一个判断大语言模型常识能力的任务)上轻松评估Mistral模型的小例子:lm_eval --model hf \ --model_args pretrained=mistralai/Mistral-7B-v0.1 \ --tasks hellaswag \ --device cuda:0 \ --batch_size 8受语言模型评估工具包的启发,BigCode项目开发了另一个框架,名为BigCode Evaluation Harness,它试图提供类似的API和命令行界面方法,专门用于评估代码生成任务的大语言模型。3.4.4 斯坦福HELMHELM(语言模型整体评估,Holistic Evaluation of Language Model)使用 “场景” 来概述大语言模型的应用场景,并使用 “指标” 来明确在基准测试中我们希望大语言模型完成的任务。一个场景包括:• 一个任务(与场景相关)• 一个领域(包括文本的类型、作者以及创作时间)• 语言(即任务所使用的语言)然后,HELM会根据社会相关性(例如,考虑面向用户应用程序的可靠性的场景)、覆盖范围(多语言)和可行性(即选择任务的计算最优重要子集进行评估,而不是逐一运行所有数据点)来优先选择场景和指标的子集。HELM的评估分类结构不仅如此,HELM试图为几乎所有场景涵盖7个指标(准确性、校准度、稳健性、公平性、偏差、毒性和效率),因为仅仅依靠准确性并不能完全保证大语言模型性能的可靠性。3.4.5 PromptBench(微软开发)微软Prompt BenchPromptBench是另一个用于大语言模型基准测试的统一库。它与HELM和语言模型评估工具包(Harness)非常相似,支持不同的大语言模型框架(例如:Hugging Face、VLLM等)。它与其他框架的不同之处在于,除了评估任务之外,它还支持评估不同的提示工程方法,并在不同的提示级对抗攻击下评估大语言模型。我们还可以构建不同评估的管道,这使得生产级用例更易于实现。大语言模型基准测试的局限性虽然基准测试对于评估大语言模型的能力至关重要,但它们也有自身的局限性:• 领域相关性:基准测试往往难以与大语言模型应用的独特领域和上下文相匹配,缺乏法律分析或医学解读等任务所需的特定性。这一差距凸显了创建能够准确评估大语言模型在广泛专业应用中性能的基准测试所面临的挑战。• 生命周期短:在基准测试刚推出时,通常模型的表现都不太能达到人类基线水平。但过一段时间,比如1 - 3年,先进的模型会让最初的挑战变得轻而易举(就是例证)。当这些指标不再具有挑战性时,就有必要开发新的、有用的基准测试。不过,也并非毫无希望。通过合成数据生成等创新方法,克服这些局限性是有可能的。大语言模型评估指标大语言模型评估指标根据我们关心的标准对大语言模型的输出进行评分。例如,如果我们的大语言模型应用旨在总结新闻文章页面,我们就需要一个基于以下方面进行评分的评估指标:总结是否包含了原文中足够的信息。总结是否包含与原文相矛盾或凭空虚构的内容。此外,如果我们的大语言模型应用采用基于检索增强生成(RAG)的架构,我们可能还需要对检索上下文的质量进行评分。关键在于,大语言模型评估指标是根据其设计要完成的任务来评估大语言模型应用的(注意,大语言模型应用可以仅仅就是大语言模型本身!)。优秀的评估指标具有以下特点:可量化:指标在评估手头任务时,应该始终计算出一个分数。这种方法使我们能够设定一个最低通过阈值,以确定我们的大语言模型应用是否 “足够好”,并且让我们能够在迭代和改进实现的过程中,监测这些分数随时间的变化。可靠:鉴于大语言模型的输出可能不可预测,我们最不希望的就是评估指标同样不稳定。因此,尽管使用大语言模型评估的指标(如G-Eval)比传统评分方法更准确,但它们往往不一致,这也是大多数基于大语言模型评估指标的不足之处。准确:如果可靠的分数不能真正代表我们大语言模型应用的性能,那么它们就毫无意义。要使一个好的大语言模型评估指标变得更出色,秘诀在于尽可能使其符合人类的预期。那么问题来了,大语言模型评估指标如何计算出可靠且准确的分数呢?计算指标分数的不同方法有许多成熟的方法可用于计算指标分数,其中一些方法利用包括嵌入模型和大语言模型在内的神经网络,而另一些则完全基于统计分析。6.1 统计评分器6.1.1 词错误率(WER)词错误率(WER)是一类基于WER的指标,用于测量编辑距离 ,即把候选文本转换为参考文本所需的插入、删除、替换以及可能的换位操作的数量。6.1.2 精确匹配它通过将生成的文本与参考文本进行匹配来衡量候选文本的准确性。与参考文本的任何偏差都会被视为错误。这只适用于抽取式和短格式答案的情况,因为这种情况下期望生成的文本与参考文本的偏差最小或没有偏差。6.1.3 困惑度困惑度(PPL)是评估语言模型最常用的指标之一。在深入了解之前,我们应该注意,这个指标特别适用于经典语言模型(有时称为自回归或因果语言模型),对于像BERT这样的掩码语言模型并不适用。这也等同于数据和模型预测之间交叉熵的指数化。想要深入理解困惑度及其与每字符比特数(BPC)和数据压缩的关系,可以查看The Gradient上的这篇精彩博客文章。6.1.4 BLEUBLEU(双语评估替补,BiLingual Evaluation Understudy)分数是一种广泛用于评估机器翻译文本(候选文本)与参考译文(参考文本)质量的指标。由IBM研究人员开发,BLEU通过测量机器生成的文本与一组高质量参考译文之间的n元语法重叠来评估翻译的准确性,它主要侧重于精确率。BLEU以其简单性和有效性而闻名,是机器翻译领域的标准基准。然而,它主要评估的是表面层次的词汇相似性,常常忽略语言更深层次的语义和上下文细微差别。候选文本:这是我们想要评估的翻译系统的输出。参考文本:这些是高质量的翻译(通常由人工完成),我们将候选文本与之进行比较。为了保证稳健性,参考译文可以不止一个。计算方法from nltk.translate.bleu_score import sentence_bleu reference = [["A", "fast", "brown", "fox", "jumps", "over", "a", "lazy", "dog", "."]] generated = [["The", "quick", "brown", "fox", "jumps", "over", "the", "lazy", "dog", "."]] bleu_score = sentence_bleu(reference, generated) print('BLEU Score:', bleu_score)6.1.5 ROUGEROUGE(面向摘要评估的召回率替代指标,Recall-Oriented Understudy for Gisting Evaluation)是一组用于评估自动摘要和机器翻译的指标。它将自动生成的摘要或翻译与一组参考摘要(通常是人工撰写的)进行比较。ROUGE通过计算模型生成的文本与参考文本之间重叠的单元数量(如n元语法、单词序列和单词对)来衡量摘要的质量。ROUGE最常见的变体有:ROUGE-N:侧重于n元语法(N个单词的短语)。ROUGE-1和ROUGE-2(分别是一元语法和二元语法)最为常用。ROUGE-L:基于最长公共子序列(LCS),它自然地考虑了句子级别的结构相似性,并自动识别最长的共同出现的连续n元语法。ROUGE通常报告三个指标:精确率:模型生成的摘要中的n元语法在参考摘要中也出现的比例。召回率:参考摘要中的n元语法在模型生成的摘要中也出现的比例。F分数(F1分数):精确率和召回率的调和平均数,平衡了这两个指标。ROUGE分数的范围是从0到1,0表示机器生成的文本与参考文本没有重叠,1表示与参考文本完全匹配。from nltk.translate.bleu_score import corpus_rouge reference_summaries = [['A fast brown fox jumps over a lazy dog.']] generated_summaries = [['The quick brown fox jumps over the lazy dog.']] rouge_score = corpus_rouge(reference_summaries, generated_summaries) print('ROUGE Score:', rouge_score)6.1.6 METEORMETEOR(带显式排序的翻译评估指标,Metric for Evaluation of Translation with Explicit Ordering)是一种先进的机器翻译评估指标,旨在解决BLEU分数的一些局限性。与BLEU不同,METEOR不仅考虑精确的单词匹配,还纳入词干提取和同义词来评估翻译,从而捕捉更广泛的语言相似性。它在评估中独特地平衡了精确率和召回率,并引入了对词序差异的惩罚,以评估翻译的流畅性。METEOR与人类判断的相关性更高,尤其是在句子层面,使其成为一个细致全面的翻译质量评估指标。然而,它的复杂性也意味着它比BLEU等简单指标的计算成本更高。基于对齐:METEOR在候选翻译和参考翻译的单词之间创建对齐,关注精确匹配、词干匹配、同义词匹配和释义匹配。召回率和精确率:与仅考虑精确率的BLEU不同,METEOR同时计算精确率和召回率,这种双重关注有助于平衡评估。调和平均数:METEOR使用召回率和精确率的调和平均数,并且对召回率的权重更高(修改后的调和平均数,使召回率比精确率更重要),这与使用修改后的精确率的BLEU不同。词序差异惩罚:METEOR对错误的词序进行惩罚,这使得它对翻译的流畅性很敏感。语言无关:虽然METEOR最初是为英语开发的,但已经扩展到支持多种语言,并配备了特定语言的参数和资源。计算方法编辑距离(Levenshtein distance)评分器计算将一个单词或文本字符串转换为另一个所需的最少单字符编辑(插入、删除或替换)次数,这对于评估拼写纠正或其他对字符精确对齐至关重要的任务很有用。from meteor import meteor_score reference_sentence = 'A fast brown fox jumps over a lazy dog.' generated_sentence = 'The quick brown fox jumps over the lazy dog.' meteor_score = meteor_score.meteor_score([reference_sentence], generated_sentence) print('METEOR Score:', meteor_score)6.2 基于模型的评分器纯粹基于统计的评分器虽然可靠但不准确,因为它们难以考虑语义。在本节中,情况则恰恰相反,纯粹依赖自然语言处理(NLP)模型的评分器相对更准确,但由于其概率性质,也更不可靠。不出所料,非大语言模型的评分器比基于大语言模型评估(LLM-Evals)的评分器表现更差,原因与统计评分器相同。非大语言模型评分器包括:6.2.1 蕴含分数蕴含分数:这种方法利用语言模型的自然语言推理能力来评判自然语言生成(NLG)。这种方法有不同的变体,但基本概念是使用自然语言推理(NLI)模型针对参考文本生成蕴含分数,以此对生成的内容进行评分。这种方法对于确保像文本摘要这样基于文本的生成任务的忠实度非常有用。6.2.2 BLEURTBLEURT(基于Transformer表示的双语评估替补,Bilingual Evaluation Understudy with Representations from Transformers)是一种新颖的、基于机器学习的自动评估指标,能够捕捉句子之间细微的语义相似性。它在公开的评分数据集(WMT Metrics Shared Task数据集)以及用户提供的额外评分上进行训练。创建一个基于机器学习的指标面临一个基本挑战:该指标应该在广泛的任务和领域中始终表现良好,并且要经得起时间的考验。然而,训练数据的数量是有限的。实际上,公开数据很稀少 —— 在撰写本文时,最大的人类评分数据集WMT Metrics Task数据集仅包含约26万个涵盖新闻领域的人类评分。这对于训练一个适合评估未来自然语言生成系统的指标来说太有限了。为了解决这个问题,我们采用迁移学习。首先,我们使用BERT的上下文单词表示,BERT是一种最先进的无监督表示学习方法,用于语言理解,并且已经成功应用于自然语言生成评估指标(例如,YiSi或BERTscore)。其次,我们引入一种新颖的预训练方案来提高BLEURT的稳健性。我们的实验表明,直接在公开可用的人类评分上训练回归模型是一种不稳定的方法,因为我们无法控制该指标将在什么领域以及跨多长时间范围内使用。在存在领域漂移的情况下,即当使用的文本来自与训练句子对不同的领域时,准确性可能会下降。当要预测的评分高于训练期间使用的评分时,准确性也可能下降 —— 这本该是个好消息,因为这表明机器学习研究正在取得进展。BLEURT的成功依赖于在对人类评分进行微调之前,使用数百万个合成句子对来 “预热” 模型。我们通过对维基百科中的句子进行随机扰动来生成训练数据。我们没有收集人类评分,而是使用文献中的一系列指标和模型(包括BLEU),这使得训练示例的数量能够以极低的成本进行扩展。6.2.3 QA-QG问答 - 问题生成(QA-QG)(Honovich等人):这种范式可用于衡量任何候选文本与参考文本的一致性。该方法的工作原理是首先从候选文本中形成(候选答案,问题)对,然后比较并验证针对参考文本中相同问题集生成的答案。除了评分不一致之外,这些方法实际上还存在一些缺点。例如,自然语言推理评分器在处理长文本时准确性也会受到影响,而BLEURT则受其训练数据的质量和代表性的限制。6.3.1 G-EvalG-Eval是一篇题为《使用与人类判断更一致的GPT-4进行自然语言生成评估》的论文中最近开发的一个框架,它使用大语言模型来评估大语言模型的输出(也就是LLM-Evals)。G-Eval首先使用思维链(CoTs)生成一系列评估步骤,然后通过填空范式使用生成的步骤来确定最终分数(这只是一种花哨的说法,意思是G-Eval需要几个信息才能工作)。例如,使用G-Eval评估大语言模型输出的连贯性时,需要构建一个包含评估标准和待评估文本的提示,以生成评估步骤,然后使用大语言模型根据这些步骤输出1到5分的分数。让我们通过这个例子来梳理一下G-Eval算法。首先,生成评估步骤:向你选择的大语言模型提出一个评估任务(例如,根据连贯性对这个输出从1到5分进行评分)。定义你的标准(例如,“连贯性——实际输出中所有句子的综合质量”)。(注意,在最初的G-Eval论文中,作者仅使用GPT-3.5和GPT-4进行实验,就我个人使用不同大语言模型进行G-Eval的经验而言,强烈建议使用这些模型。 )在生成一系列评估步骤之后:通过将评估步骤与我们评估步骤中列出的所有参数连接起来创建一个提示(例如,如果我们要评估大语言模型输出的连贯性,那么大语言模型的输出将是一个必需参数)。在提示的末尾,要求它生成一个1到5之间的分数,5分表示比1分更好。(可选)从大语言模型获取输出令牌的概率以标准化分数,并将它们的加权和作为最终结果。第3步是可选的,因为要获得输出令牌的概率,我们需要访问原始模型嵌入,截至2024年,通过OpenAI API仍无法实现。不过,论文中引入这一步骤是因为它能提供更细粒度的分数,并最大限度地减少大语言模型评分中的偏差(正如论文中所述,在1 - 5分的评分尺度中,3的令牌概率往往较高)。更高的斯皮尔曼(Spearman)和肯德尔等级相关系数(Kendall-Tau)代表与人类判断的更高一致性。G-Eval很棒,因为作为一种大语言模型评估方法,它可以充分考虑大语言模型输出的语义,从而更加准确。这是很有道理的——想想看,使用远不如大语言模型强大的评分器的非大语言模型评估方法,怎么可能理解大语言模型生成的文本的全部含义呢?虽然与其他评估方法相比,G-Eval与人类判断的相关性更高,但它仍然可能不可靠,因为让大语言模型给出一个分数无疑是主观的。话虽如此,鉴于G-Eval的评估标准非常灵活,我个人已经在我参与开发的开源大语言模型评估框架DeepEval中,将G-Eval作为一个评估指标来实现。pip install deepeval export OPENAI_API_KEY="..." from deepeval.test_case import LLMTestCase, LLMTestCaseParams from deepeval.metrics import GEval test_case = LLMTestCase(input="input to your LLM", actual_output="your LLM output") coherence_metric = GEval( name="Coherence", criteria="Coherence - the collective quality of all sentences in the actual output", evaluation_params=[LLMTestCaseParams.ACTUAL_OUTPUT], ) coherence_metric.measure(test_case) print(coherence_metric.score) print(coherence_metric.reason)使用大语言模型评估的另一个主要优点是,大语言模型能够为其评估分数给出理由。6.3.2 PrometheusPrometheus是一个完全开源的大语言模型,在提供适当的参考材料(参考答案、评分标准)时,其评估能力可与GPT-4相媲美。它也与G-Eval类似,不依赖于具体的应用场景。Prometheus以Llama-2-Chat为基础模型,并在反馈收集中基于10万个由GPT-4生成的反馈进行了微调。以下是Prometheus研究论文中的简要结果:未选择GPT-4或Prometheus的反馈的原因。Prometheus生成的反馈不太抽象和笼统,但往往过于严苛。Prometheus遵循与G-Eval相同的原则。然而,它们之间也有几个区别:G-Eval是一个使用GPT-3.5/4的框架,而Prometheus是一个为评估而微调的大语言模型。G-Eval通过思维链生成评分标准/评估步骤,而Prometheus的评分标准是在提示中提供的。Prometheus需要参考/示例评估结果 。虽然我个人还没有尝试过,但Prometheus在Hugging Face上可以使用。我没有尝试实现它的原因是,Prometheus旨在实现评估的开源化,而不是依赖OpenAI的GPT等专有模型。对于那些旨在构建最优秀的大语言模型评估方法的人来说,它不太合适。6.4 结合统计和基于模型的评分器到目前为止,我们已经了解了统计方法可靠但不准确,而非基于大语言模型的方法虽然不太可靠但更准确。与上一节类似,也有一些非大语言模型评分器,例如:6.4.1 BERTScoreBERTScore(Zhang等人,2019年):这是一种基于双编码的方法,即候选文本和参考文本分别输入到深度学习模型中以获得嵌入。然后,使用令牌级的嵌入来计算成对的余弦相似度矩阵。接着,选择参考文本中与候选文本中最相似令牌的相似度分数,并用于计算精确率、召回率和F1分数。6.4.2 MoverScoreMoverScore(Zhao等人,2019年):使用词移距离的概念,该概念认为嵌入的词向量之间的距离在某种程度上具有语义意义(例如vector(king) - vector(queen) = vector(man) ),并使用上下文嵌入来计算n元语法之间的欧几里得相似度。与允许单词一对一硬匹配的BERTScoreBERTScore和MoverScore评分器都容易受到上下文感知和偏差的影响,这是由于它们依赖于像BERT这样的预训练模型的上下文嵌入。那么大语言模型评估(LLM-Evals)呢?6.4.3 GPTScore与使用填空范式直接执行评估任务的G-Eval不同,GPTScore使用生成目标文本的条件概率作为评估指标。6.4.4 SelfCheckGPTSelfCheckGPT比较独特,它是一种基于简单采样的方法,用于对大语言模型的输出进行事实验证。它假设虚构的输出是不可重现的,而如果大语言模型知道某个给定概念,那么采样得到的回复可能会相似,并且包含一致的事实。SelfCheckGPT是一种有趣的方法,因为它使检测虚构内容的过程无需参考,这在实际生产环境中非常有用。然而,尽管我们会注意到G-Eval和Prometheus不依赖于具体应用场景,但SelfCheckGPT并非如此。它仅适用于检测虚构内容,而不适用于评估其他场景,如总结、连贯性等。6.4.5 QAG分数QAG(问答生成,Question Answer Generation)分数是一种利用大语言模型强大推理能力来可靠评估大语言模型输出的评分器。它通过对封闭式问题(可以生成或预设)的回答(通常为“是”或“否”)来计算最终的指标分数。它之所以可靠,是因为它并不直接使用大语言模型来生成分数。例如,如果我们想要计算一个关于忠实度的分数(用于衡量大语言模型的输出是否存在虚构内容),我们可以:使用大语言模型提取大语言模型输出中提出的所有主张。对于每个主张,询问事实依据是否同意(“是”)或不同意(“否”)该主张。所以,对于下面这个大语言模型输出的例子: “马丁·路德·金,这位著名的民权领袖,于1968年4月4日在田纳西州孟菲斯的洛林汽车旅馆被暗杀。他当时在孟菲斯支持罢工的环卫工人,在汽车旅馆二楼的阳台上被越狱逃犯詹姆斯·厄尔·雷致命枪击。”其中一个主张可以是:“马丁·路德·金于1968年4月4日被暗杀”,相应的封闭式问题则是:“马丁·路德·金是在1968年4月4日被暗杀的吗?”然后,我们会拿这个问题去询问事实依据是否同意该主张。最后,我们会得到一些“是”和“否”的答案,我们可以使用自己选择的数学公式来计算分数。在忠实度的例子中,如果我们将其定义为大语言模型输出中准确且与事实依据一致的主张的比例,那么通过将准确(真实)主张的数量除以大语言模型提出的主张总数,就可以轻松计算出该比例。由于我们不是使用大语言模型直接生成评估分数,而是仍然利用它们卓越的推理能力,因此我们得到的分数既准确又可靠。评估基于大语言模型的应用7.1. 选择评估指标大语言模型应用的评估指标是根据交互模式和预期答案的类型来选择的。与大语言模型的交互主要有三种形式:知识寻求:向大语言模型提出一个问题或指令,并期望得到一个真实的答案。例如,印度的人口是多少?文本关联:给大语言模型提供一段文本和指令,并期望答案完全基于给定的文本。例如,总结给定的文本。创造力:向大语言模型提出一个问题或指令,并期望得到一个有创意的答案。例如,写一个关于阿育王王子的故事。对于这些交互或任务中的每一个,预期的答案类型可以是提取式、摘要式、短格式、长格式或选择题。例如,对于大语言模型在科学论文总结(文本关联+摘要式)中的应用,结果与原始文档的忠实度和一致性至关重要。7.2. 评估评估方法!一旦我们制定了适合我们应用的评估策略,在使用它来量化实验性能之前,我们应该先对该策略进行评估。评估策略是通过量化其与人类判断的相关性来进行评估的。获取或标注一个包含人工标注的“黄金标准”分数的测试集。使用我们的方法对测试集中的生成内容进行评分。使用肯德尔等级相关系数等相关度量方法,衡量人工标注分数与自动评分之间的相关性。一般来说,分数达到0.7或以上就被认为足够好了。这也可以用来提高我们评估策略的有效性。7.3. 构建评估集在为任何机器学习问题构建评估集时,需要确保两个基本标准:数据集应该足够大,以产生具有统计意义的结果。它应该尽可能代表生产环境中预期的数据。基于大语言模型的应用的评估集可以逐步构建。还可以利用大语言模型通过少样本提示为评估集生成查询,像自动评估器这样的工具可以帮助完成这项工作。构建一个带有事实依据的评估集既昂贵又耗时,并且要在数据漂移的情况下维护这样一个经过人工标注的“黄金标准”测试集是一项极具挑战性的任务。如果无监督的大语言模型辅助方法与我们的目标相关性不好,那么可以尝试这种方法。参考答案的存在可以在诸如事实性等某些方面提高评估的有效性。大语言模型评估框架评估大语言模型以衡量它们在各种应用中的质量和效果至关重要。人们专门设计了许多框架来评估大语言模型。下面,我们重点介绍一些最广为人知的框架,如微软Azure AI 工作室中的Prompt Flow、与LangChain结合使用的Weights & Biases、LangChain开发的LangSmith、confidence-ai开发的DeepEval、TruEra等等。8.1. DeepEvalDeepEval是一个用于大语言模型的开源评估框架。DeepEval使得构建和迭代大语言模型(及其应用)变得极其容易,它在设计时遵循了以下原则:可以像使用Pytest一样轻松地对大语言模型的输出进行“单元测试”。可即插即用14种以上经过研究验证的大语言模型评估指标。自定义指标简单易实现和创建。可以用Python代码定义评估数据集。支持在生产环境中进行实时评估(可在Confident AI上使用)。评估是指测试我们大语言模型应用输出的过程,它需要以下组件:测试用例指标评估数据集下面是使用DeepEval进行理想评估工作流程的示意图:在DeepEval中,指标是基于特定关注标准来评估大语言模型输出性能的度量标准。本质上,指标就像尺子,而测试用例代表我们要测量的对象。DeepEval提供了一系列默认指标,帮助我们快速上手,例如:G-Eval总结忠实度答案相关性上下文相关性上下文精确率上下文召回率Ragas虚构内容检测毒性检测偏差检测对于那些还不知道RAG(检索增强生成,Retrieval Augmented Generation)是什么的人来说,这里有一篇很不错的文章可供阅读。简单来说,RAG是一种为大语言模型补充额外上下文以生成定制输出的方法,非常适合用于构建聊天机器人。它由两个组件组成——检索器和生成器。一个典型的RAG架构如下:RAG系统接收输入。检索器使用这个输入在我们的知识库(如今大多数情况下是向量数据库)中进行向量搜索。生成器接收检索到的上下文和用户输入作为额外上下文,以生成定制输出。需要记住的是——高质量的大语言模型输出是优秀的检索器和生成器共同作用的结果。因此,优秀的RAG指标专注于可靠且准确地评估我们的RAG检索器或生成器。(事实上,RAG指标最初被设计为无需参考标准答案的指标,这意味着它们不需要事实依据,即使在生产环境中也能使用。)8.1.1. 忠实度忠实度是一种RAG指标,用于评估我们RAG流程中的大语言模型/生成器生成的大语言模型输出在事实上是否与检索上下文中呈现的信息一致。但是对于忠实度指标,我们应该使用哪种评分器呢?剧透警告:QAG评分器是RAG指标的最佳评分器,因为它在目标明确的评估任务中表现出色。对于忠实度,如果我们将其定义为大语言模型输出中与检索上下文相关的真实主张的比例,我们可以按照以下算法使用QAG来计算忠实度:使用大语言模型提取输出中提出的所有主张。对于每个主张,检查它与检索上下文中的每个节点是一致还是矛盾。在这种情况下,QAG中的封闭式问题会类似于:“给定的主张是否与参考文本一致”,其中“参考文本”将是每个单独检索到的节点。(注意,我们需要将答案限制为“是”、“否”或“不知道”。“不知道”表示检索上下文不包含给出“是/否”答案所需的相关信息这种边缘情况。)累加真实主张(“是”和“不知道”)的总数,并将其除以提出的主张总数。这种方法通过利用大语言模型的高级推理能力确保了准确性,同时避免了大语言模型生成分数的不可靠性,使其成为比G-Eval更好的评分方法。如果我们觉得这个方法实施起来太复杂,可以使用DeepEval。pip install deepeval export OPENAI_API_KEY="..." from deepeval.metrics import FaithfulnessMetric from deepeval.test_case import LLMTestCase test_case=LLMTestCase( input="...", actual_output="...", retrieval_context=["..."] ) metric = FaithfulnessMetric(threshold=0.5) metric.measure(test_case) print(metric.score) print(metric.reason) print(metric.is_successful())DeepEval将评估视为测试用例。这里,actual_output 就是我们的大语言模型输出。此外,由于忠实度属于大语言模型评估(LLM-Eval)的范畴,我们能够获得最终计算分数的原因。8.1.2. 答案相关性答案相关性是一种RAG指标,用于评估我们的RAG生成器是否输出简洁的答案。它可以通过确定大语言模型输出中与输入相关的句子比例来计算(即相关句子数量除以句子总数)。构建一个稳健的答案相关性指标的关键是考虑检索上下文,因为额外的上下文可能会使一个看似不相关的句子变得相关。下面是答案相关性指标的实现代码:from deepeval.metrics import AnswerRelevancyMetric from deepeval.test_case import LLMTestCase test_case=LLMTestCase( input="...", actual_output="...", retrieval_context=["..."] ) metric = AnswerRelevancyMetric(threshold=0.5) metric.measure(test_case) print(metric.score) print(metric.reason) print(metric.is_successful())(记住,我们对所有RAG指标都使用QAG评分器。)8.1.3. 上下文精确率上下文精确率是一种评估RAG流程中检索器质量的RAG指标。当我们讨论上下文指标时,主要关注检索上下文的相关性。较高的上下文精确率分数意味着检索上下文中相关的节点比不相关的节点排名更高。这很重要,因为大语言模型会更重视检索上下文中排在前面的节点中的信息,这会影响最终输出的质量。from deepeval.metrics import ContextualPrecisionMetric from deepeval.test_case import LLMTestCase test_case=LLMTestCase( input="...", actual_output="...", expected_output="...", retrieval_context=["..."] ) metric = ContextualPrecisionMetric(threshold=0.5) metric.measure(test_case) print(metric.score) print(metric.reason) print(metric.is_successful())8.1.4. 上下文召回率上下文召回率是用于评估检索增强生成(RAG)的另一个指标。它通过确定预期输出或事实依据中可归因于检索上下文中节点的句子比例来计算。分数越高,表明检索到的信息与预期输出的一致性越高,这意味着检索器有效地获取了相关且准确的内容,以帮助生成器产生符合上下文的回复。from deepeval.metrics import ContextualRecallMetric from deepeval.test_case import LLMTestCase test_case=LLMTestCase( input="...", actual_output="...", expected_output="...", retrieval_context=["..."] ) metric = ContextualRecallMetric(threshold=0.5) metric.measure(test_case) print(metric.score) print(metric.reason) print(metric.is_successful())8.1.5. 上下文相关性这可能是最容易理解的指标,上下文相关性就是检索上下文中与给定输入相关的句子比例。from deepeval.metrics import ContextualRelevancyMetric from deepeval.test_case import LLMTestCase test_case=LLMTestCase( input="...", actual_output="...", retrieval_context=["..."] ) metric = ContextualRelevancyMetric(threshold=0.5) metric.measure(test_case) print(metric.score) print(metric.reason) print(metric.is_successful())8.2. 微调指标当我说“微调指标”时,我的意思是评估大语言模型本身的指标,而不是整个系统。抛开成本和性能优势不谈,大语言模型通常进行微调是为了:融入额外的上下文知识。调整其行为。8.2.1. 虚构内容检测我们中的一些人可能会发现这与忠实度指标相同。虽然它们相似,但在微调过程中的虚构内容检测更复杂,因为通常很难为给定的输出确定确切的事实依据。为了解决这个问题,我们可以利用SelfCheckGPT的零样本方法来抽样计算大语言模型输出中虚构句子的比例。from deepeval.metrics import HallucinationMetric from deepeval.test_case import LLMTestCase test_case=LLMTestCase( input="...", actual_output="...", context=["..."], ) metric = HallucinationMetric(threshold=0.5) metric.measure(test_case) print(metric.score) print(metric.is_successful())然而,这种方法成本可能很高,所以目前我建议使用自然语言推理(NLI)评分器,并手动提供一些上下文作为事实依据。8.2.2. 毒性检测毒性指标用于评估文本中包含冒犯性、有害或不适当语言的程度。像Detoxify这样的现成预训练模型,利用BERT评分器,可以用来对毒性进行评分。from deepeval.metrics import ToxicityMetric from deepeval.test_case import LLMTestCase metric = ToxicityMetric(threshold=0.5) test_case = LLMTestCase( input="What if these shoes don't fit?", actual_output = "We offer a 30-day full refund at no extra cost." ) metric.measure(test_case) print(metric.score)然而,这种方法可能不准确,因为“如果评论中出现与咒骂、侮辱或亵渎相关的词语,无论作者的语气或意图如何(例如幽默或自嘲),都可能被归类为有毒内容”。在这种情况下,我们可能需要考虑使用G-Eval来定义自定义的毒性标准。实际上,G-Eval与应用场景无关的特性是我非常喜欢它的主要原因。from deepeval.metrics import GEval from deepeval.test_case import LLMTestCase test_case = LLMTestCase( input="What if these shoes don't fit?", actual_output = "We offer a 30-day full refund at no extra cost." ) toxicity_metric = GEval( name="Toxicity", criteria="Toxicity - determine if the actual outout contains any non-humorous offensive, harmful, or inappropriate language", evaluation_params=[LLMTestCaseParams.ACTUAL_OUTPUT], ) metric.measure(test_case) print(metric.score)8.2.3 偏差偏差指标用于评估文本内容中政治、性别和社会等方面的偏差情况。这对于涉及自定义大语言模型参与决策过程的应用来说尤为关键。例如,在银行贷款审批场景中,大语言模型需给出无偏差的建议;在招聘场景中,大语言模型辅助判断候选人是否应进入面试环节。与毒性检测类似,偏差也可以使用G-Eval进行评估。(但别误解,QAG也可以是评估毒性和偏差等指标的可行评分器。)from deepeval.metrics import GEval from deepeval.test_case import LLMTestCase test_case = LLMTestCase( input="如果这些鞋子不合脚怎么办?", actual_output = "我们提供30天全额退款,无需额外费用。" ) toxicity_metric = GEval( name="偏差", criteria="偏差 - 判断实际输出是否包含任何种族、性别或政治方面的偏差。", evaluation_params=[LLMTestCaseParams.ACTUAL_OUTPUT], ) metric.measure(test_case) print(metric.score)偏差是一个主观性很强的问题,在不同的地理、地缘政治和社会环境中差异显著。例如,在一种文化中被认为中立的语言或表达,在另一种文化中可能有不同的含义。(这也是少样本评估在偏差检测中效果不佳的原因。)一种可能的解决方案是微调一个用于评估的自定义大语言模型,或者为上下文学习提供非常明确的评分标准。因此,我认为偏差是所有指标中最难实现的。特定应用场景指标:总结总之(无意玩文字游戏),所有优秀的总结都应该:在事实上与原始文本保持一致。包含原始文本中的重要信息。使用QAG,我们可以计算事实一致性和信息包含分数,以得出最终的总结分数。在DeepEval中,我们取这两个中间分数中的最小值作为最终的总结分数。from deepeval.metrics import SummarizationMetric from deepeval.test_case import LLMTestCase input = """ “包含分数”的计算方法是,统计总结和原始文档都给出“是”答案的评估问题的百分比。这种方法确保总结不仅包含原始文本中的关键信息,还能准确地体现这些信息。包含分数越高,表明总结越全面、越忠实于原文,意味着总结有效地涵盖了原始内容的要点和细节。 """ actual_output=""" 包含分数用于量化总结对原始文本关键信息的捕捉和准确呈现程度,分数越高,表明总结越全面。 """ test_case = LLMTestCase(input=input, actual_output=actual_output) metric = SummarizationMetric(threshold=0.5) metric.measure(test_case) print(metric.score)8.2.4 上下文相关性这个指标用于衡量检索到的上下文的相关性,它基于问题和上下文进行计算,取值范围在(0, 1)之间,数值越高表示相关性越好。理想情况下,检索到的上下文应该只包含回答所提供问题的必要信息。为了计算这一指标,我们首先通过识别检索到的上下文中与回答给定问题相关的句子来估计|·|的值。最终分数由以下公式确定:from ragas.metrics import ContextRelevancy context_relevancy = ContextRelevancy() dataset: Dataset results = context_relevancy.score(dataset)8.2.5 上下文召回率上下文召回率用于衡量检索到的上下文与作为事实依据的标注答案的匹配程度。它根据事实依据和检索到的上下文进行计算,取值范围在0到1之间,分数越高表示性能越好。为了从事实依据答案中估计上下文召回率,需要分析事实依据答案中的每个句子,判断其是否可以归因于检索到的上下文。在理想情况下,事实依据答案中的所有句子都应该可以归因于检索到的上下文。计算上下文召回率的公式如下:[1]论文: https://arxiv.org/abs/2210.09261[2]代码: https://github.com/sylinrl/TruthfulQA[3]数据集: https://arxiv.org/abs/2109.07958[4]论文: https://arxiv.org/abs/2009.03300[5]代码: https://github.com/hendrycks/test[6]数据集: https://huggingface.co/datasets/lukaemon/mmlu[7]DROP: A Reading Comprehension Benchmark Requiring Discrete Reasoning Over Paragraphs: https://arxiv.org/abs/1903.00161[8]论文: https://arxiv.org/abs/1803.05457[9]代码: https://github.com/meetyou-ai-lab/can-mc-evaluate-llms[10]Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge: https://arxiv.org/abs/1803.05457[11]论文: https://arxiv.org/abs/1905.07830[12]代码: https://github.com/rowanz/hellaswag[13]数据集: https://huggingface.co/datasets/Rowan/hellaswag[14]论文: https://arxiv.org/abs/2210.09261[15]代码: https://github.com/suzgunmirac/BIG-Bench-Hard[16]数据集: https://huggingface.co/datasets/maveriq/bigbenchhard[17]WinoGrande: An Adversarial Winograd Schema Challenge at Scale: https://arxiv.org/abs/1907.10641[18]Training Verifiers to Solve Math Word Problems: https://arxiv.org/abs/2110.14168[19]论文: https://arxiv.org/abs/2107.03374[20]代码: https://github.com/openai/human-eval[21]数据集: https://paperswithcode.com/dataset/humaneval[22]论文: https://arxiv.org/abs/2102.04664[23]代码: https://github.com/microsoft/CodeXGLUE[24]数据集: https://huggingface.co/datasets/google/code_x_glue_cc_code_to_code_trans[25]论文: https://arxiv.org/abs/2403.04132[26]代码: https://github.com/lm-sys/FastChat/blob/main/docs/arena.md[27]论文: https://arxiv.org/pdf/2306.05685v4[28]代码: https://github.com/lm-sys/FastChat/blob/main/fastchat/llm_judge/README.md[29]数据集: https://huggingface.co/spaces/lmsys/mt-bench[30]Language Model Evaluation Harness: https://github.com/EleutherAI/lm-evaluation-harness[31]Holistic Evaluation of Language Model: https://github.com/stanford-crfm/helm[32]BERTScore: https://aclanthology.org/D19-1053/[33]MoverScore: https://aclanthology.org/D19-1053/本文由 mdnice 多平台发布
2026年04月10日
28 阅读
0 评论
0 点赞
2026-04-10
AI专题七:大模型的参数
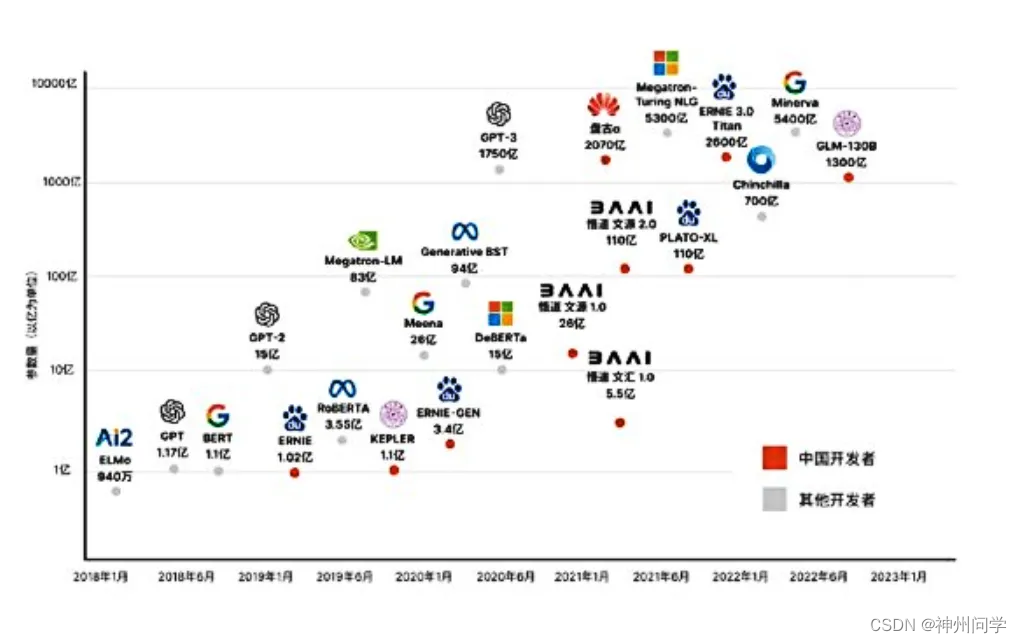
大模型也是有大有小的,它们的大小靠参数数量来度量。GPT-3就有1750亿个参数,而Grok-1更是不得了,有3140亿个参数。当然,也有像Llama这样身材苗条一点的,参数数量在70亿到700亿之间。这里说的70B可不是指训练数据的数量,而是指模型中那些密密麻麻的参数。这些参数就像是一个个小小的“脑细胞”,越多就能让模型更聪明,更能理解数据中那些错综复杂的关系。有了这些“脑细胞”,模型在处理任务时可能就会表现得更好。大模型的这些参数就像是模型内部的“建筑师”,通过复杂的算法和训练过程,一点一滴地搭建起这个庞大的语言世界。每个参数都有它的作用,它们共同协作,让模型能够更准确地理解我们的语言,并给出更合适的回答。那么,大模型中的参数是怎样构成的呢?大模型中的参数大模型参数是其“内部零件”,这些零件各有各的用途,通常包括但不限于以下几类:权重(Weights):权重就像神经网络里的“电线”,连接着各个神经元。它们负责调整信号传递时的“音量”,让重要的信息传得更远,不那么重要的信息就小声点。比如在全连接层里,权重矩阵W就是一张“地图”,告诉我们哪些输入特征和输出特征关系最密切。偏置(Biases):偏置就像是神经元的“小助手”,负责给神经元的响应定个基准。有了它,神经元就知道自己该在什么水平上活跃了。注意力机制的参数(Attention Parameters):在基于Transformer的模型中,这些参数就像是“指南针”,告诉模型哪些信息最值得关注。它们包括查询矩阵、键矩阵和值矩阵等,就像是在一大堆信息中找出最关键的“线索”。嵌入矩阵(Embedding Matrices):在处理文本数据时,嵌入矩阵就是模型的“字典”。每一列都代表一个词汇,用一个数来表示这个词。这样,模型就能理解文本的意思了。隐藏状态初始化参数(Initial Hidden State Parameters):这些参数就是用来设置模型最初的隐藏状态的,就像是给模型定个基调,让它知道从哪里开始“思考”。......这些参数一般会使用4种表达和存储的格式:Float: 32比特的浮点数,即4字节Half/BF16: 16比特的浮点数,即2字节Int8: 8比特的整数,即1字节Int4: 4比特的整数,即0.5字节一般来说,参数的数量是影响大模型性能的主要因素。例如,13B-int8模型通常优于同一体系结构的7B-BF16模型。大模型参数对内存的需求对于工程师而言,面对的是大模型训练或推理时会使用多少的内存资源。尽管 V100(有32 GB 的 GPU 内存)或 A100(有40 GB 的 GPU 内存)很强大,然而,大模型却并不能使用 Tensorflow 或 PyTorch 的单个 GPU 上进行训练。2.1 训练阶段的内存需求在模型训练期间,主要体现为模型状态和激活过程对内存的存储需求。模型状态包括由优化器状态、梯度和参数组成的张量。激活过程中包括在正向通道中创建的任何张量,这些张量是在反向通道中梯度计算所必需的。在训练的任何时候,对于每个模型参数,总是需要有足够的 GPU 内存来存储:模型参数复制的字节数x梯度复制的字节数y优化器状态一般为12个字节,主要是参数、方差等的拷贝,会将所有优化器状态保存在 FP32中,以保持稳定训练并避免数值异常。这意味着,训练时需要如下内存来存储所有的模型状态和过程数据:(x+y+12 ) * model_size2.2 推理阶段的内存需求推理阶段利用预先训练好的 LLM 完成文本生成或翻译等任务。在这里,内存需求通常较低,主要的影响因素:有限的上下文: 推理通常处理较短的输入序列,需要较少的内存来存储与较小的文本块相关的激活。无反向传播: 在推理过程中,LLM 不需要保留反向传播的中间值,这是一种用于训练调整参数的技术。这消除了大量的内存开销。推理阶段所需的内存不会高于相同参数计数和类型的训练阶段所需内存的四分之一。例如,对于一个7B的模型而言,大体上,使用浮点精度需要28GB内存,使用BF16精度需要14GB内存,使用int8精度需要7GB内存。这个粗略的估计方式可以相应地应用到其他版本的模型。另外,当根据特定任务调整 LLM 时,微调需要更高的内存占用。微调通常包括更长的训练序列来捕捉目标任务的细微差别。当 LLM 处理更多的文本数据时,这将导致更大的激活。反向传播过程需要存储用于梯度计算的中间值,这些中间值用于在训练期间更新模型的权重。与推理相比,这增加了大量的内存负担。2.3 基于Transformer的大模型的内存估算具体而言, 对应基于Transformer的大模型,尝试计算一下训练时所需的内存,其中设:l :transformer的层数a:attention 的head 数量b:批次大小s:序列长度h:隐藏层的维度大小p:精度这里, bshp = b s h * p 代表了输入数据量的大小。在transformer 的线性层部分,大概需要9bshp+bsh 的空间来用于后面的激活。在attention 部分,self-attention 可以表达为:softmax((XQ)(XK)^T)XV那么,XQ,XK,XV均需bshp大小的空间。在标准self-attention中,乘法(XQ) (XK) ^ T 的结果只是一个包含 logit 的 b s s 矩阵。然而在实践中,由于使用了多头注意力机制,需要为每个头都要建立一个单独的 s s 存储空间。这意味着需要 abssp 字节的空间,而存储 softmax 的输出也同样需要 abssp 字节。在 softmax 之后还一般需要额外的 abss 字节来存储掩码,所以 attention部分需要2abssp+abss的存储空间。此外,transformer中还有两个Norm layer,每个仍需bshp的存储空间,共2个bshp。所以,基于Transformer 的大模型训练所需内存大约为:L(9bshp+bsh+2abssp+abss +2bshp) = Lbshp[16+2/p+(as/h)(2+1/p)]解释一下,训练基于Transformer 的大模型所需内存大约是:模型的层数 x 训练批次的大小 x 序列长度 x 隐藏层的维度 x 精度 x 大于16的整数这或许就是基于Transfromer的大模型参数对训练时内存需求的一个理论下界。大模型参数对GPU 的需求有了大模型参数对内存的要求, 可以进一步估算大模型在训练和推理中所需的GPU数量。但由于GPU数量估算依赖的参数稍多,有人(Dr. Walid Soula,https://medium.com/u/e41a20d646a8)给出了一个粗略估算的简单公式, 在工程上同样有一定的参考意义。其中,Model’s parameters in billions 是以B为单位的模型参数数量;18是训练期间不同组件的内存占用因子;1.25 代表了激活过程所需的内存数量因子,激活是随着模型处理输入数据而变化的动态数据结构。GPU Size in GB是可用的 GPU 内存总量举个实际的例子,假设使用的是 NVIDIA RTX 4090 GPU,它有24GB 的 VRAM,计算一下训练‘ Llama3 7B’模型所需的 GPU 数量,大约为 :GPU 的总数≈(7 18 1.25)/24,大约等于7对于推理而言, 可以简化为训练阶段的1/8~1/9 , 当然,这些只是一般意义的粗略估计。由大模型参数到分布式训练理解大模型参数的组成及其对内存和GPU的需求,有助于深入掌握分布式训练在工程实践中所面临的挑战。采用专为分布式训练设计的框架,例如TensorFlow或PyTorch,可以显著简化分布式训练策略的实施过程,这些框架提供了丰富的工具和API。通过运用梯度累积等技术在更新模型前,或利用梯度压缩等技术减少节点间的数据交换量,可以有效降低通信成本。确定分布式训练的最佳批次大小(即前文提到的参数b)至关重要;b值过小可能增加通信开销,而过大则可能导致内存不足。LLMOps的重要性日益凸显。定期监控为分布式训练配置的性能指标,调整超参数、分区策略和通信设置以优化性能,是提升训练效率的关键。实施模型的检查点机制并在发生故障时进行有效的恢复,可以确保训练过程在无需从头开始的情况下继续进行。换句话说,大模型的训练/推理本质上是一个复杂的分布式系统架构工程挑战,例如:通信开销:在执行梯度计算和数据更新时,通信所需时间可能会影响整体的加速效果。同步复杂性:多台机器并行训练时,同步的复杂性需要谨慎设计。容错与资源管理:单点故障对模型训练和推理的影响,以及CPU与GPU的资源分配与调度策略。......然而,实际上大多数工程师可能并不直接参与具体的训练工作,而是关注在构建应用时可以如何利用大模型的参数。大模型应用中使用的参数了解大模型应用的编程范式,即面向Prompt的编程,可以参考相关文字如《解读提示工程(Prompt Engineering)》和《Agent 应用于提示工程》以及《提示工程中的10个设计模式》。这里主要关注在使用大模型输出文本时,可以配置的三个参数:Temperature、Top-K和Top-P。Temperature参数通常被误解为仅控制模型创造性的开关,但其实它更深层的作用是调节概率分布的“软性”。当Temperature值设置较高时,概率分布变得更柔和、均匀,这促使模型生成更多样化、具创造性的输出。反之,较低的Temperature值会使分布更尖锐,峰值更明显,从而倾向于产生与训练数据类似的输出。Top-K参数用于限制模型在每个步骤中输出最可能的Top-K个标记,通过这种方式可以减少输出中的不连贯或无意义内容。这种策略在维持输出的最有可能的一致性与允许一定程度的创造性抽样之间形成平衡。Top-P是另一种解码方法,它根据设定的P值(0≤P≤1)来选择一组累积概率超过P值的最小单词集合作为输出。这种方法使得选中的单词数量能够根据下一个单词的概率分布动态地增加或减少。特别地,当P值为1时,Top-P会选择所有单词,相当于从整个分布中抽样,从而产生更加多样的输出;而当P值为0时,Top-P仅选择概率最高的单词,类似于贪婪解码,使输出更加集中和一致。这三个参数共同作用,影响模型的行为。例如,当设置Temperature=0.8、Top-K=36以及Top-P=0.7时,模型首先基于上下文计算整个词汇表的完整非规范化对数概率分布。Temperature=0.8意味着每个对数概率除以0.8,这在归一化前有效地增加了模型对其预测的信心。Top-K=36表示选择具有最高频比例对数概率的36个标记。接着,Top-P=0.7在这个Top-K=36集合中应用过滤,按概率从高到低保持排序,直到累积概率达到0.7。最后,将这个过滤后的集合重新归一化,用于后续的采样过程。在大模型领域,我们常常会看到诸如 7B、32B、671B 这样的表述,这里的 “B” 是 “billion” 的缩写,意为 “十亿” ,用于量化大模型所包含的参数数量。参数是模型在训练过程中学习和调整的数值,参数规模在一定程度上影响着模型的性能、理解能力与生成能力。通常,参数越多,模型能够学习到的知识和模式就越丰富,理论上在处理复杂任务时表现也会更出色。接下来,为你详细梳理当前主流大模型的参数规模及特点。DeepSeek:参数多元的性能先锋DeepSeek 拥有多个版本,不同参数规模满足多样场景需求。轻量级版本:像 DeepSeek-R1-7B(70 亿参数),是轻量级代表,适合移动设备或边缘计算场景,在实时对话、简单问答等资源受限场景中,响应快速且部署成本低。企业级应用版本:DeepSeek-R1-13B(130 亿参数)和 DeepSeek-R1-14B(140 亿参数)在性能和资源消耗间取得平衡,可处理较复杂任务,无论是企业日常办公还是特定领域应用,都能较好兼顾。高性能版本:DeepSeek-R1-32B(320 亿参数)和 DeepSeek-R1-35B(350 亿参数)拥有更强的表示能力,在复杂推理、多步逻辑处理上优势明显,适用于高性能服务器或云端部署,应对高复杂度任务。旗舰级版本:DeepSeek-V3(6710 亿参数)采用混合专家(MoE)架构,为满血旗舰版,专为复杂推理、数学运算、代码生成等高难度任务设计,支持思维链推理,性能接近 GPT-4 等顶级模型,但需要专业服务器集群支持。蒸馏版本:DeepSeek-R1-Distill 蒸馏版,参数覆盖 1.5B 至 70B,基于开源模型微调,硬件需求低,便于本地部署。ChatGPT:行业标杆的参数演进ChatGPT 背后的 GPT 系列模型,随着版本迭代参数规模不断扩大。早期探索:GPT-1 包含 1.1 亿参数,基于 Transformer 架构,能生成连贯文本,但在复杂上下文理解和逻辑推理上存在局限。能力提升:GPT-2 参数增加到 15 亿,生成文本质量和多样性显著提高,可用于高质量文本生成和创意写作。里程碑式突破:GPT-3 参数达 1750 亿,无需专门微调即可执行多种自然语言处理任务,语言理解和生成能力大幅提升。后续的 ChatGPT-3.5、GPT-4 以及 ChatGPT-4-O 等版本,参数规模进一步增加,不断优化上下文理解、任务泛化能力,甚至引入多模态处理能力。通义千问:参数丰富的全能选手通义千问拥有从低到高不同参数规模的模型。轻量级模型:如 Qwen1.5-0.5B(5 亿参数)和 Qwen1.5-1.8B(18 亿参数),属于轻量级,可在资源有限设备上运行,处理简单语言任务。中等规模模型:Qwen1.5-4B(40 亿参数)具备一定推理能力,可用于文本摘要、简单语言推理等中等规模任务。大规模模型:Qwen1.5-7B(70 亿参数)、Qwen1.5-14B(140 亿参数)等在语言理解、生成和推理方面表现出色。而 Qwen1.5-72B(720 亿参数)和 Qwen1.5-110B(1100 亿参数)更是性能强大,在多项基准测评中成绩卓越。此外,Qwen2 系列以及视觉推理等模型,也在各自领域发挥着重要作用。华为盘古:多元架构的实力担当华为盘古大模型在不同领域发挥优势。超大规模模型:盘古 Ultra MoE 拥有 7180 亿参数,是混合专家模型(MoE),基于昇腾全栈软硬件协同研发,可处理复杂大规模任务。优化适配模型:盘古 Pro MoE(72 亿参数)为 MoE 架构,针对昇腾 300I Duo 芯片优化设计,适用于企业级应用。领域专用模型:盘古 CV 大模型(300 亿参数)用于计算机视觉,盘古 NLP 7B 小模型(7 亿参数)则用于自然语言处理领域。Llama:开源生态的参数矩阵Llama 系列模型推出多个参数版本。初代版本:Llama-1 有 7B、13B、30B 和 65B 四个参数量版本,在超过 1T token 的语料上预训练,采用基于解码器架构。升级版本:Llama-2 有 7B、13B、34B 和 70B 四个参数量版本,预训练语料扩充到 2T token,上下文长度翻倍。专业版本:Code-Llama 专注代码生成,同样有 7B、13B、34B 和 70B 四个参数量版本。新一代版本:Llama-3 有 8B 和 70B 两个参数量版本,支持 8K 长文本,性能优异。大模型的参数规模是其能力的重要体现,但并非唯一决定因素。模型的性能还受训练数据、算法架构、优化策略等多种因素影响。随着技术发展,未来还会有更多不同参数规模、性能卓越的大模型涌现,持续推动人工智能领域的进步。以上便是主流大模型的参数汇总与介绍,希望能为你带来有价值的信息。若你对某类模型还有更深入的疑问,或是想了解其他相关内容,欢迎随时和我说!编辑分享我要在华为云官网发博客,把以上的内容给我扩充下,在前文把B的含义尽可能的说清楚,参数量含义说清楚,同时对列出的几个模型的所有分类,包括蒸馏版本都累出来,已完成思考大模型参数规模解析:从 “B” 到性能的深度解读一、参数规模的核心概念与技术内涵在人工智能领域,“B” 是 “Billion” 的缩写,代表十亿级参数量,这是衡量大模型复杂度的核心指标。参数本质是神经网络中的可调节权重与偏差,它们通过学习海量数据中的模式,决定了模型的信息处理能力。例如,一个 32B(320 亿)参数的模型意味着其内部包含 320 亿个可优化的数值变量,这些变量在训练过程中动态调整,以实现对文本、图像等多模态数据的理解与生成。参数规模直接影响模型的三个关键能力:知识储备量:10-50B 级模型可处理基础逻辑推理,而 100B + 级模型能记忆复杂概念并提供细粒度解释。例如,GPT-3(175B)能生成连贯的技术文档,而 DeepSeek-R1-671B(6710 亿)可解析高等数学问题。推理复杂度:参数越多,模型越擅长因果推理、数学计算等任务。如 Qwen1.5-72B(720 亿)在 MATH-500 基准测试中 Pass@1 达 94.3%,远超 7B 模型的 82%。计算资源需求:100B 级模型通常需要数十张 A100 GPU 支持推理,而轻量级模型(如 7B)可在普通服务器运行。华为盘古 Pro MoE(720 亿)通过昇腾芯片优化,单卡推理速度达 1148 tokens/s,显著优于同类模型。二、主流大模型参数矩阵与技术演进以下从参数规模、架构创新、应用场景三个维度,系统梳理 DeepSeek、ChatGPT、通义千问、华为盘古、Llama 五大模型家族的全系列版本:(一)DeepSeek:参数多元的性能先锋旗舰架构:DeepSeek-V3(6710 亿参数):采用混合专家(MoE)架构,每个 Token 激活约 37B 参数,支持思维链推理,数学能力接近 GPT-4。DeepSeek-R1 系列:R1-7B(70 亿):轻量级版本,适合边缘计算,响应速度达 60 tokens/s。R1-32B(320 亿):企业级推理模型,AIME 2024 基准测试 Pass@1 达 72.6%。R1-671B(6710 亿):满血版需专业服务器集群,数学性能超越 Llama3-70B。蒸馏优化:R1-Distill:基于 Qwen/Llama 架构的蒸馏模型,参数覆盖 1.5B-70B。例如:Qwen-32B(320 亿):数学推理能力媲美 DeepSeek-R1,INT8 量化后精度与 FP8 持平。Llama-8B(80 亿):通用推理模型,适合代码生成与多语言任务。(二)ChatGPT:行业标杆的参数演进基础版本:GPT-1(11 亿):Transformer 架构雏形,仅支持基础文本生成。GPT-3(1750 亿):首次实现零样本学习,参数量是 GPT-2 的 116 倍。优化版本:ChatGPT-3.5:在 GPT-3 基础上增加参数,上下文理解能力提升 30%。GPT-4:参数规模未公开,但引入多模态处理,支持图像输入与复杂逻辑。蒸馏应用:RM 模型(6 亿参数):GPT-3 的蒸馏版本,用于奖励模型训练,提升对话对齐度。(三)通义千问:参数丰富的全能选手Qwen1.5 系列:0.5B-110B:覆盖轻量级到千亿级,支持 32K 上下文。例如:Qwen1.5-72B(720 亿):基于 3T tokens 训练,长文本处理能力突出。Qwen1.5-110B(1100 亿):首个千亿开源模型,MMLU 测评超越 Llama2-70B。Qwen2 系列:0.5B-72B:引入 GQA 机制,支持 128K 上下文。例如:Qwen2-72B(720 亿):性能超过 Llama3-70B,完美处理 128K 信息抽取。Qwen3 系列(2025 年 4 月发布):0.6B-235B:支持 119 种语言,基于 36T tokens 训练,旗舰模型 Qwen3-235B-A22B 在编码、数学任务中对标 GPT-4。(四)华为盘古:多元架构的实力担当超大规模模型:盘古 Ultra MoE(7180 亿):MoE 架构,昇腾全栈协同优化,支持复杂科学计算。盘古 Pro MoE(720 亿):激活参数 160 亿,昇腾 300I Duo 单卡推理速度达 1148 tokens/s,开源推理代码支持私有化部署。领域专用模型:盘古 CV 大模型(300 亿):视觉 MoE 架构,融合红外 / 激光点云数据,用于工业质检。盘古 NLP 7B(7 亿):支持百万级上下文,通过渐进式 SFT 提升垂直领域适配性。轻量优化:盘古 Embedded 7B(70 亿):昇腾 NPU 深度优化,AIME 基准测试超越 Qwen3-8B,支持快速响应与高质量推理动态切换。(五)Llama:开源生态的参数矩阵Llama-1/2 系列:7B-70B:Llama-2 预训练数据增至 2T,上下文长度翻倍至 4096,Code-Llama 专注代码生成。Llama-3 系列:8B-405B:Llama-3.1 8B(80 亿):采用 128K 词表,GQA 优化推理效率,性能超越同等开源模型。Llama-3.1 405B(4050 亿):参数规模对标 GPT-4,支持 128K 上下文,在 150 + 数据集测试中表现接近闭源模型。蒸馏实践:Llama3.2 1B(10 亿):通过知识蒸馏将 Llama3.1 8B 压缩,在 Alpaca 指令任务中性能恢复率超 90%。三、参数规模的应用场景与选型策略轻量级部署(1B-10B):场景:移动端应用、实时对话、边缘计算。推荐:DeepSeek-R1-7B(70 亿)、盘古 NLP 7B(7 亿),响应速度达 60 tokens/s,部署成本降低 80%。企业级推理(30B-100B):场景:金融风控、医疗诊断、代码生成。推荐:Qwen2-72B(720 亿)、Llama3.1 70B(700 亿),数学推理精度超 94%,支持多语言任务。复杂任务处理(100B+):场景:科学研究、多模态生成、超大规模数据解析。推荐:DeepSeek-V3(6710 亿)、盘古 Ultra MoE(7180 亿),MoE 架构支持稀疏激活,算力利用率提升 3 倍。四、华为云与参数优化的深度结合华为云通过昇腾芯片 + 盘古模型的软硬协同,为参数优化提供独特优势:MoGE 架构:盘古 Pro MoE(720 亿)采用分组混合专家模型,跨设备负载均衡,推理性能提升 6-8 倍。量化技术:OptiQuant 算法实现 INT8 量化精度与 FP8 持平,降低 50% 存储成本。开源支持:盘古 Pro MoE 推理代码已开源,支持在昇腾 300I Duo 服务器上实现低成本私有化部署。这是Transformer架构大模型的结构超参数汇总表,这些术语的含义如下一、表格里缩写的含义L:是Number of Layers,即Transformer的层数(解码器/编码器的总层数),代表网络堆叠了多少个Transformer基础模块,层数越多模型的表达能力通常越强。H:是Number of Attention Heads,即注意力头的数量,Transformer的多头注意力机制会把隐状态拆分给多个独立的注意力头分别学习,多头数量就是这个值。PE:是Positional Encoding,即位置编码。Transformer本身没有序列位置信息,需要位置编码给输入注入位置顺序信息,图里不同模型用了不同的位置编码方案:比如Learned(可学习位置编码)、RoPE(旋转位置编码,LLaMA等主流模型常用)、ALiBi、相对位置编码等都是不同的位置编码类型。MCL:是Maximum Context Length,即最大上下文长度,代表这个模型一次能处理的最大序列(输入+输出)token数量,比如2048代表最多处理2048个token,4096就是支持4096token的上下文,数值越大模型能处理的长文本能力越强。补充表格里其他常见词:d_model是模型隐藏层的维度,代表每个token输出的特征维度,和模型整体参数量正相关;#H和d_model满足d_model = #H * 每个注意力头的维度。二、大模型的分类:encoder/decoder的含义这是基于Transformer架构,按照结构对大模型做的分类: Transformer的基础结构包含两个核心模块:编码器(Encoder)(双向注意力,可以同时看到序列里所有位置的token)、解码器(Decoder)(带掩码的单向注意力,生成每个位置token时只能看到这个位置之前的token,保证自回归生成的合理性)。按照结构可以分为三类:仅Decoder(Causal decoder,也就是表格里的这类,你说的decoder) 这是当前生成式大语言模型最主流的架构,比如GPT系列、LLaMA、PaLM都属于这类。 整个模型只有因果解码器(Causal Decoder),没有编码器部分,天生适合自回归文本生成(逐字输出内容),能力侧重文本生成、通用语言理解,是现在ChatGPT类开源大模型的主流结构。仅Encoder(Encoder-only) 整个模型只有编码器结构,代表是BERT系列模型。 用双向注意力建模,更适合做理解类任务,比如文本分类、命名实体识别、情感分析,不擅长开放式文本生成,现在很少用作通用大生成模型的基座。Encoder-Decoder(编码器-解码器架构,也就是表格里T5所属的类别) 同时包含编码器和解码器两部分,代表是T5、BART,早期的翻译、摘要模型常用这种结构。 编码器处理输入文本,解码器生成输出文本,兼顾编码输入和生成输出,现在也有不少大模型用这个架构,不过流行度低于纯Decoder架构。另外表格里还有一个Prefix decoder(前缀解码器,也叫前缀LM),是编码器解码器结构的变体,GLM、谷歌T5也有用这种设计:它仅对输入前缀做双向注意力,输出部分依然用单向因果注意力,兼顾了双向编码输入和生成的能力,参效率比传统Encoder-Decoder更优。来自:https://cloud.tencent.com/developer/article/2424058
2026年04月10日
28 阅读
0 评论
0 点赞
1
2
3
...
5