搜索到
26
篇与
的结果
-
 AI专题二十一:AI专业术语汇总(1) 今天这篇文章,我用最人话的类比,零门槛讲透AI圈最核心的8个概念:LLM、Prompt、Context、RAG、Skills、MCP、Harness、Agent。不仅让你懂「是什么」,更让你懂「怎么用」「怎么组合」「怎么落地」,看完这篇,你对AI的理解,会超过90%的碎片化学习者。一、底层核心:所有AI应用的根,都是LLMLLM(Large Language Model,大语言模型),是整个AI世界的大脑核心。你可以把它理解成一个读了万亿页人类文本、精通语言逻辑、推理、创作的超级学霸。它天生就能听懂人话、写文案、写代码、做逻辑推导,是所有AI功能的基础底座——我们后面讲的所有概念,都是围绕这个大脑做的增强、扩展和管控。但必须先讲透它的天生短板,这也是后面所有概念存在的意义:知识有截止日期,不知道训练完成之后的新信息;容易出现「幻觉」,一本正经地编造不存在的内容;没有专属知识,不懂你公司的内部制度、你的产品详情、你的个人数据;没法直接操作外部工具,不能帮你查数据库、拉取后台数据、操作电脑文件;短期记忆有限,聊多了就会忘记前面的内容,答非所问。新手避坑:别把LLM等同于AI的全部。它只是核心零件,不是完整的解决方案。就像汽车发动机再强,没有方向盘、轮胎、刹车,也没法上路。二、和AI对话的基本功:Prompt & Context,90%的人都用错了这两个是和LLM大脑交互的基础,也是AI学习者的第一门必修课,更是最容易被轻视、用错的环节。Prompt(提示词):和AI对话的「精准指令语言」你可以把它理解成:给超级学霸的提问方式。同样一个需求,你问「帮我写个文案」,和「帮我写一篇面向30岁职场女性的抗老护肤品种草文案,小红书风格,800字以内,要有痛点、成分解析、真实使用感受,结尾加互动话题」,得到的结果天差地别。Prompt的核心,不是网上传的「玄学咒语」,也不是越长越好,而是把你的需求,拆成LLM能精准理解、严格执行的指令,核心四要素:明确需求、限定边界、给出范式、对齐预期。新手避坑:别沉迷于收藏各种Prompt模板,模板只能解决单一问题。真正的核心能力,是学会拆解需求,用精准的语言对齐AI的输出,这是所有AI操作的基本功。Context(上下文):LLM的「短期记忆」你可以把它理解成:学霸和你对话时,能同时记住的内容上限。你跟AI说「我是做ToB软件销售的」,后面问「怎么给客户做产品演示」,AI会结合你销售的身份给出答案,这就是Context在起作用。但如果你们连续聊了几百句,超出了它的记忆上限,它就会忘记你最开始说的身份,给出泛泛的回答。Context的核心价值,是决定了AI能不能连贯对话、基于长文本完成任务——比如你给它100页的合同让它审核,给它几十万字的小说让它写续写,前提都是它的Context窗口能装下这些内容。新手避坑:不是Context窗口越大越好。窗口太大,会导致AI推理变慢、注意力分散,甚至抓不住核心信息。真正的高阶能力,是学会管理Context,只给AI传递最关键的信息,过滤无效内容,这也是解决AI答非所问的核心方法。三、给AI装外挂:RAG,解决LLM的天生短板RAG(Retrieval Augmented Generation,检索增强生成),是给LLM大脑装的专属知识库+外挂硬盘,也是新手最容易落地的进阶技能。前面我们说过,LLM的核心痛点是知识过时、容易幻觉、没有专属数据。而RAG,就是专门解决这个问题的。你可以这么理解:学霸虽然读书多,但不知道你公司的内部制度、你家店铺的产品详情、你最新的项目文档、你个人的笔记资料。这时候你给它装一个RAG,就相当于给它配了一个专属私人图书馆。你提问的时候,它会先去这个图书馆里,检索和你问题相关的精准资料,再结合自己的语言能力和推理能力回答问题,从根源上避免幻觉,同时能用上你的专属数据。它的核心逻辑非常简单,只有四步:把你的文档、资料、笔记,拆成AI能处理的小片段;把这些片段转换成向量,存储到向量数据库里;你提问时,AI先去数据库里,检索和问题最相关的内容;把检索到的内容和你的问题一起,交给LLM生成精准答案。新手避坑:RAG不是简单的「把文档复制粘贴给AI」。直接丢长文档给AI,会超出Context上限,也会让AI抓不住重点。RAG的核心是「精准检索」,只给AI传递和问题相关的内容,这也是它和直接喂文档的本质区别。不管是做个人专属AI笔记助手、企业内部知识库,还是行业客服AI,RAG都是必备的核心技术,也是新手从「用AI」到「做AI工具」的第一步。四、让AI变专业:Skills,把重复工作变成一键搞定的技能包Skills(技能),是给LLM提前练好的专项本领包,是把AI从「聊天工具」变成「效率工具」的关键。你可以这么理解:学霸虽然全能,但你每次都让它从零开始写SQL、算Excel函数、审核合同、写固定格式的周报,不仅效率低,还容易每次输出的标准不统一。而Skills,就是你提前给学霸封装好的、可复用的、带完整流程的专项技能。比如「SQL生成与查询技能」,你把「用户需求→生成SQL→语法校验→执行查询→结果整理」整个流程,提前封装成一个固定的技能包,以后用户只要说一句话,AI就能自动走完整个流程,不用你每次都重新教。Skills和Prompt的核心区别:• Prompt是单次指令,解决一个具体问题;• Skills是封装好的、带逻辑、带流程、可复用的专项能力,解决一类重复问题。比如你是电商运营,你可以把「竞品标题分析」「直播话术生成」「订单数据对账」这些每天都要做的重复工作,分别封装成不同的Skills,以后只要一键调用,AI就能按固定标准、固定流程完成,效率直接拉满。五、给AI接手脚:MCP,让AI操控整个数字世界的通用桥梁MCP(Model Context Protocol,模型上下文协议),是2024年爆火的AI基础设施,也是让AI从「只能聊天」变成「能做事」的核心桥梁。先讲一个痛点:LLM本身是个纯语言模型,它没法直接操作你的电脑文件、查你的本地数据库、调用企业微信API、拉取直播后台数据、控制你的办公软件。之前要实现这些功能,你必须给每个工具、每个软件,单独写定制化的对接代码,10个工具就要写10套对接逻辑,非常麻烦,新手根本搞不定。而MCP,就是一套通用的翻译协议。你可以把它理解成:给所有软件、工具、系统、API,都装了一个统一的翻译器。只要支持MCP协议,LLM不用单独写代码对接,就能直接调用这些工具,就像人长了手脚,能直接操控整个数字世界。举个例子:之前你要让AI帮你查数据库里的销售数据,还要发到企业微信群里,你需要分别写数据库对接代码、企业微信API对接代码,还要写逻辑让AI调用。现在只要数据库和企业微信都支持MCP,AI一句话就能自动完成,不用写一行代码。新手避坑:不用深究MCP的底层协议细节,你只要知道,它是一套通用的工具对接标准,能让你零代码给AI加上各种工具能力,是AI Agent落地的核心基础设施。现在主流的AI框架都已经支持MCP,新手直接用就好。六、给AI装刹车:Harness,让AI敢用在生产环境的安全中枢Harness(大模型管控框架),是给AI装的安全刹车+管理中枢,是AI能从「玩具」变成「企业级生产工具」的核心前提。你可以这么理解:你让一个学霸帮你管公司的业务、处理客户敏感数据、操作财务系统、执行数据库指令,你肯定要给它定死规矩:什么能做、什么绝对不能做、数据不能泄露、操作不能越权、出了问题要能追溯、有风险的操作要提前拦截。Harness,就是专门干这个的。它是一套完整的管控框架,核心负责这几件事:权限管控:谁能调用AI、能调用什么功能、能访问什么数据,都由它说了算;安全审计:所有AI的操作、对话、调用记录,全程留痕,可追溯、可审计;合规校验:自动拦截违规提问、敏感内容输出,符合数据安全、行业合规要求;风险兜底:对高风险操作(比如删除数据库数据、批量发送消息)进行二次校验,不符合规则直接拦截;流量管控:控制AI的调用频率、成本上限,避免超量调用产生高额费用。新手避坑:很多人做AI应用,只关注功能好不好用,完全忽略了管控和安全。尤其是企业级应用,没有Harness的AI,就像一辆没有刹车的汽车,跑得越快,风险越大。哪怕是个人用的AI工具,也要有基础的管控逻辑,避免误操作导致数据丢失、泄露。七、最终形态:Agent,把所有零件拼成一个真正的智能机器人Agent(智能体),不是一个单一的技术,而是把上面所有概念,整合起来的完整AI机器人,也是当前AI应用的最终形态。我们来做一个完整的类比,你瞬间就能懂:• LLM是大脑,负责思考、推理、决策;• Prompt是沟通语言,负责精准传递指令;• Context是短期记忆,负责记住当前的任务和对话;• RAG是长期记忆/专属知识库,负责存储专属数据和资料;• Skills是专项本领,负责高效完成固定类型的任务;• MCP是手脚,负责调用外部工具、操作系统、软件;• Harness是安全中枢,负责全程管控、规避风险。把这些所有的零件,完整地组装起来,就是一个Agent。它能听懂你的最终目标,自主拆解任务,自主规划执行步骤,自己调用知识库找资料,自己用技能完成子任务,自己调用工具操作外部系统,全程自己纠错、自己优化,直到完成你的目标。举个最直观的例子,你跟电商运营Agent说:「帮我整理一下上周的直播带货数据,生成复盘报告,同步给运营团队」,它会自动完成这一整套流程:理解你的目标,拆解成「拉取数据→数据分析→生成报告→同步团队」4个子任务;通过MCP协议,调用直播后台的API,拉取上周的全量直播数据;调用「直播数据分析」Skill,对数据进行清洗、计算、分析,找出亮点和问题;从RAG知识库中,调取公司的复盘报告模板和过往优秀案例;基于Context里的你的需求,生成符合公司标准的复盘报告;再通过MCP调用企业微信API,把报告发到运营团队群里;全程由Harness管控,校验数据权限、操作合规性,避免敏感数据泄露,确保不会出现误操作。整个过程,完全不用你插手,这就是Agent的真正魅力——它不是一个只会聊天的机器人,而是一个能帮你自主完成完整任务的「数字员工」。八、新手必看:从入门到落地的正确路径,别再瞎学了看到这里,你已经搞懂了8个核心概念的逻辑和关系,最后给所有AI学习者,一个绝对不会踩坑的入门路径,小步快跑,快速落地:第一步:打牢基本功,别上来就搞Agent先把LLM的基础逻辑搞懂,花1-2周时间,练熟Prompt编写和Context管理。这是所有AI操作的基本功,基本功不牢,后面全是白搭。第二步:小步快跑,从RAG入手快速落地先做一个自己的专属知识库AI,比如个人笔记助手、行业资料知识库、电子书问答助手。这是最容易落地、最容易出成果的进阶项目,能快速建立你的信心,也能真正解决你自己的痛点。第三步:逐步进阶,封装自己的Skills把你日常工作中,重复度最高的工作,比如写周报、查数据、审核文档、写固定格式的文案,封装成可复用的AI Skills,实现工作自动化,真正用AI提升自己的效率。第四步:整合落地,做一个属于自己的Agent学习MCP和基础的管控逻辑,把前面的RAG、Skills、工具调用整合起来,做一个属于自己的Agent,比如个人办公助理、私域运营助手、客服机器人,真正从「用AI」,变成「造AI工具」。
-
AI专题二十:大模型本地部署工具 1. ollamaOllama 是一款开源的大模型本地部署工具,GitHub Star 数超过 80K。它提供了简单的命令行界面来下载、运行和管理大模型,同时支持通过 API 调用模型。Ollama 的核心特点:简单易用:一行命令即可运行模型模型库丰富:支持 Llama 2、Mistral、DeepSeek、Gemma 等跨平台:支持 macOS、Windows、LinuxAPI 支持:提供 RESTful API 集成GPU 加速:自动利用 GPU 加速推理轻量高效:资源占用优化Ollama 模型库涵盖多种类型的模型:硬件架构amd64:适用于 Intel/AMD x86_64 架构的 CPU(普通台式机、服务器)。arm64:适用于 ARM 架构的 CPU(如树莓派、苹果 M 系列芯片、高通骁龙)。显卡加速支持无后缀(如 ollama-linux-amd64.tgz):仅支持 CPU 推理,无 GPU 加速。-rocm后缀(如 ollama-linux-amd64-rocm.tgz):支持 AMD 显卡加速(需兼容 ROCm 驱动)。-jetpack后缀(如 ollama-linux-arm64-jetpack6.tgz):专为 NVIDIA Jetson 嵌入式设备优化(如 Jetson Nano/Orin)。操作系统.tgz:Linux/macOS 系统压缩包(需手动解压安装)。.zip:Windows 系统压缩包(需解压后运行)2. LM studioLM Studio 是一款支持在本地运行 AI 大模型的工具,支持 Mac、Linux 和 Windows 全平台。和 Ollama 不同,LM Studio 自带一个漂亮的图形界面,入门门槛极低——下载、搜索模型、点击运行,三步搞定。目前支持的主流模型相当多:gpt-oss、Qwen3、Gemma 3、DeepSeek 等等,基本上 Hugging Face 上热门的 GGUF 和 MLX 模型都能跑。1). 本地模型管理一键下载:内置 Hugging Face 模型库浏览器,可直接搜索并下载数千种开源模型(如 Llama、Mistral、Qwen、DeepSeek 等)多格式支持:兼容 GGUF、Safetensors 等主流格式版本管理:轻松切换不同模型版本和量化精度(Q4、Q5、Q8 等)2). 聊天与推理界面可视化聊天:提供类似 ChatGPT 的对话界面,支持多轮对话参数调节:实时调整 Temperature、Top-p、上下文长度等推理参数系统提示词:可自定义 System 来设定 AI 角色和行为3). 开发者工具本地 API 服务器:提供 OpenAI 兼容的 REST API(http://localhost:1234/v1),方便集成到第三方应用模型信息查看:详细展示模型架构、词汇表大小、上下文窗口等元数据4). 硬件优化自动硬件检测:智能识别 NVIDIA/AMD/Intel 显卡,自动启用 GPU 加速CPU 回退:无独显时自动使用 CPU 推理,支持 AVX2 等指令集优化LM studio有哪些技术优势?LM Studio 底层基于 llama.cpp 高性能运行时,并针对 NVIDIA RTX GPU 做了深度优化。通过 CUDA 12.8 集成,支持 CUDA Graph 和 Flash Attention,可在 RTX GPU 上实现最高 35% 的吞吐量提升。软件自动检测并启用 GPU 加速(CUDA/Metal),用户也可手动调整 GPU 卸载比例和 CPU 线程数以平衡性能。3.AnythingLLMAnythingLLM 是开源免费且支持多模态交互的全栈 AI 客户端。AnythingLLM支持文本、图像和音频等多种输入方式,将任何文档或内容转化为上下文,供各种语言模型(LLM)在对话中使用。AnythingLLM支持本地运行和远程部署,提供多用户管理、工作区隔离、丰富的文档格式支持以及强大的 API 集成。所有数据默认存储在本地,确保隐私安全。AnythingLLM支持多种流行的 LLM 和向量数据库,适合个人用户、开发者和企业使用。AnythingLLMAnythingLLM的主要功能多模态交互:支持文本、图像和音频等多种输入方式,提供更丰富的交互体验。文档处理与上下文管理:将文档划分为独立的“工作区”,支持多种格式(如PDF、TXT、DOCX等),保持上下文隔离,确保对话的清晰性。多用户支持与权限管理:Docker版本支持多用户实例,管理员能控制用户权限,适合团队协作。AI代理与工具集成:支持在工作区内运行AI代理,执行网页浏览、代码运行等任务,扩展应用的功能。本地部署与隐私保护:默认情况下,所有数据(包括模型、文档和聊天记录)存储在本地,确保隐私和数据安全。强大的API支持:提供完整的开发者API,方便用户进行自定义开发和集成。云部署就绪:支持多种云平台(如AWS、GCP等),方便用户根据需求进行远程部署。AnythingLLM的项目地址项目官网:https://anythingllm.com/GitHub仓库:https://github.com/Mintplex-Labs/anything-llmAI工具集获取AnythingLLM安装包,扫码关注回复:AnythingLLMAnythingLLM的技术原理前端:用ViteJS和React构建,提供简洁易用的用户界面,支持拖拽上传文档等功能。后端:基于NodeJS和Express,负责处理用户交互、文档解析、向量数据库管理及与LLM的通信。文档处理:基于NodeJS服务器解析和处理上传的文档,将其转化为向量嵌入,存储在向量数据库中。向量数据库:用LanceDB等向量数据库,将文档内容转化为向量嵌入,便于在对话中快速检索相关上下文。LLM集成:支持多种开源和商业LLM(如OpenAI、Hugging Face等),用户根据需求选择合适的模型。AI代理:在工作区内运行AI代理,代理能执行各种任务(如网页浏览、代码执行等),扩展应用的功能。AnythingLLM支持的模型和数据库大型语言模型(LLMs):支持多种开源和闭源模型,如 OpenAI、Google Gemini Pro、Hugging Face 等。嵌入模型:支持 AnythingLLM 原生嵌入器、OpenAI 等。语音转文字和文字转语音:支持多种语音模型,包括 OpenAI 和 ElevenLabs。向量数据库:支持 LanceDB、Pinecone、Chroma 等。AnythingLLM的使用和部署桌面版:系统要求:操作系统:支持 Windows、MacOS 和 Linux。硬件要求:建议至少 8GB 内存,推荐 16GB 或更高。下载和安装:访问 AnythingLLM 官方网站。根据操作系统选择对应的安装包。安装程序:Windows:双击安装程序并按照提示完成安装。MacOS:双击 DMG 文件,将应用程序拖入“应用程序”文件夹。Linux:基于包管理器安装 DEB 或 RPM 文件。启动应用:安装完成后,打开 AnythingLLM 应用。初始化设置:选择模型:首次启动时,选择一个语言模型(LLM)。配置向量数据库:选择默认的向量数据库(如 LanceDB)或配置其他支持的数据库。创建工作区:点击“新建工作区”,为项目或文档创建一个独立的工作区。上传文档(如 PDF、TXT、DOCX 等),应用自动解析并生成向量嵌入,存储在向量数据库中。开始对话:在工作区内输入问题或指令,应用根据上传的文档内容生成智能回答。支持多模态交互,上传图片或音频文件,应用根据内容进行处理。Docker 版:系统要求:操作系统:支持 Linux、Windows(WSL2)和 MacOS。硬件要求:建议至少 8GB 内存,推荐 16GB 或更高。Docker 环境:需要安装 Docker 和 Docker Compose。部署步骤:访问 GitHub 仓库:前往 AnythingLLM GitHub 仓库。4 DifyDify 是一个 开源 LLM 应用开发平台(Low-code/No-code),目标是让开发者和团队更快地构建和运营基于大语言模型(LLM)的应用。它的名字来自 “Do It For You”。特点:🛠️ 低代码/可视化:支持在 Web 界面拖拽配置工作流。🧩 即插即用:支持各种大模型(OpenAI、Claude、DeepSeek、Llama、Ollama 等)。🖥️ 开发者友好:支持 Python/JS SDK,API 接口调用。📊 监控 & 调优:提供日志、评测、向量库管理、数据观测等功能。Dify 可以做什么?AI 助手:客服机器人、个人助理。知识库问答:上传 PDF、文档,接入企业知识库。多模型编排:结合不同大模型完成复杂任务。Agent 工作流:让 AI 具备工具调用、Web 搜索、数据库查询能力。RAG 应用:Retrieval-Augmented Generation,结合向量库问答。对NVIDIA GPU的支持AnythingLLM对NVIDIA GPU的支持最为成熟和全面。这主要得益于其底层依赖的Ollama框架和CUDA生态系统的完善支持。NVIDIA GPU可以通过CUDA Toolkit实现硬件加速,并且AnythingLLM的开发者针对NVIDIA的Tensor Core进行了专门优化,能够显著提升本地大语言模型和RAG工作流的响应速度。在实际部署中,用户只需确保已安装正确的NVIDIA驱动和CUDA工具包,AnythingLLM便可自动利用GPU进行加速。1[10]对AMD GPU的支持AnythingLLM理论上支持AMD GPU,但其支持程度和易用性通常不如NVIDIA。实现支持的关键在于AMD GPU需要安装ROCm(Radeon Open Compute)平台,这是一个对标CUDA的开源计算平台。用户必须确保其AMD显卡型号在ROCm的支持列表内,并正确安装相应的驱动程序。与NVIDIA的“开箱即用”体验相比,使用AMD GPU可能需要更多的手动配置和环境调优,且在不同操作系统下的支持状态可能存在差异Dify 的核心功能Dify 核心组件概览Dify 的架构主要由 Web Frontend、API Backend、Worker 以及多个核心子系统构成,这些组件通过数据库、缓存和消息队列进行连接与协作。Web Frontend作用: 提供用户与 Dify 平台交互的图形化界面。开发者在这里创建、管理、调试和部署他们的 AI 应用(如聊天机器人、自动化工作流等)。所有操作,包括编排 Workflow、上传文件构建知识库、查看对话历史等,都通过它完成。技术: 通常基于现代框架如 Next.js 和 React 构建。API Backend作用: 这是 Dify 的核心大脑和交通枢纽。它承担了以下关键职责:请求处理: 接收来自 Web Frontend 或第三方集成的所有 RESTful API 请求。业务逻辑: 执行应用程序的核心逻辑,例如管理对话、协调工作流执行、处理检索增强生成(RAG)请求等。系统协调: 它本身不处理所有任务,而是作为协调者,调用其他子系统(如 Model Provider System, RAG System)并与其他基础设施(数据库、缓存)交互来完成请求。身份验证与授权: 验证用户身份和权限。技术: 通常使用 Python 框架(如 Flask 或 Django)构建。Celery Worker作用: 专门处理异步和耗时任务的后台进程。它的存在是为了避免长时间运行的任务阻塞 API Backend 的即时响应。典型任务: 为上传的文档构建索引。这个过程涉及读取文件、文本分块、生成向量嵌入(Embeddings)并写入向量数据库,非常消耗资源和时间,必须异步处理。关系: 通过消息队列(如 Redis)从 API Backend 接收任务。处理完成后,会更新数据库中的任务状态。核心子系统 (Core Subsystems)这些子系统是 API Backend 内部的逻辑模块,是实现不同功能的核心。Conversation System作用: 管理用户与 AI 应用之间的所有对话交互。负责创建对话会话(Session)、保存和检索对话历史消息、维护对话的上下文状态。这是实现连贯多轮对话的基础。Workflow System作用: 提供一个可视化工具(基于 ReactFlow 等库),允许用户通过拖放节点(Node)的方式,编排复杂、多步骤的 AI 任务流水线。节点类型包括 LLM 调用、工具调用、条件判断、知识检索等。关系: 在执行时,它会调用 Model Provider System 来获取 LLM 响应,也可以调用 RAG Knowledge System 来检索信息,或执行代码、调用外部 API 工具。RAG Knowledge System (或 Dataset System)作用: 实现检索增强生成(RAG)全流程的系统。处理知识库: 管理数据集的创建、文档上传、解析、分块。生成与存储索引: 协调文本的向量化过程,并将向量嵌入(Embeddings)存储到向量数据库(VectorDB)中。检索: 在查询时,根据用户问题从向量数据库中快速检索出最相关的文本片段,作为上下文提供给 LLM。关系: 严重依赖 VectorDB 和 Celery Worker(用于异步索引文档)。Model Provider System作用: 作为 LLM 的抽象层和统一网关。它集成了众多模型提供商(如 OpenAI, Anthropic, Azure OpenAI, 本地部署模型等),并对上层应用提供一致的调用接口。开发者在这里配置和管理不同模型的 API 密钥和参数。关系: 被 API Backend(处理直接聊天请求时)和 Workflow System(执行 LLM 节点时)调用,是平台与外部 AI 模型连接的桥梁。数据存储与基础设施 (Data Storage & Infrastructure)PostgreSQL:作用: 主数据库。存储所有结构化数据,包括但不限于:用户账户和权限设置AI 应用的配置信息对话记录(Conversation history)Workflow 的编排定义数据集(Dataset)元数据信息VectorDB (e.g., Qdrant, Weaviate, Milvus):作用: 向量数据库。专门用于存储和高效查询由文本生成的向量嵌入(Embeddings)。是 RAG 知识系统的核心存储,通过相似性搜索实现语义检索。Redis:作用: 多功能用途。缓存(Cache): 缓存频繁访问的数据(如会话状态、应用配置),减轻数据库压力,提升响应速度。消息代理(Message Broker): 作为 Celery 的任务队列,在 API Backend 和 Worker 之间传递异步任务消息。File Storage (e.g., S3, MinIO, Local Storage):作用: 存储用户上传的原始文件(如 PDF、Word 文档、图片等)。组件间如何协作Dify 的各个组件并非孤立工作,而是紧密协作的:用户通过 Web 前端 发起请求,例如创建一个新的聊天应用或启动一个工作流。请求到达 API 后端 (Flask),后端根据请求类型协调相应的核心子系统。子系统处理:如果是聊天请求,会话系统 会管理对话状态,并可能调用 模型供应系统 来获取LLM的响应,必要时通过 RAG 知识系统 从知识库检索信息增强上下文。如果是工作流执行,工作流系统 会解析流程定义,按顺序执行各个节点。节点可能调用 模型供应系统 中的LLM、通过 工具集成 访问外部服务,或使用 RAG 知识系统 进行检索。数据存储与访问:在整个过程中,PostgreSQL 用于存储结构化数据(如用户信息、应用配置),向量数据库 为 RAG 提供支撑,Redis 用于缓存和任务队列,文件存储 系统保存用户上传的文档。异步任务处理:对于耗时操作(如文档索引),API 后端会将任务发送到 消息队列 (Redis),由 Celery 工作节点 在后台异步处理。最终响应 通过 API 后端返回给 Web 前端,呈现给用户。安装 Dify 系统设备最低要求:CPU >= 2 CoreRAM >= 4 GiB安装 Dify 前,要先确保你的电脑上已经安装了 Docker 和 Docker Compose,使用 Docker Compose 启动 Dify 服务器是最简便的方式。git clone https://github.com/langgenius/dify.gitcd difycd dockercp .env.example .envdocker compose up -d5 GPT4AllGPT4All是一个强大的生态系统,它允许用户在本地计算机上运行自定义的大型语言模型(LLMs)。本文将详细介绍GPT4All的安装、使用方法以及案例应用,帮助用户全面理解和有效利用这一工具。GPT4All概述什么是GPT4AllGPT4All是一个开源项目,旨在提供一种在通用硬件上运行大型语言模型的方式。该项目由Nomic AI支持和维护,确保软件的质量和安全。GPT4All能在CPU和GPU上运行,支持多种操作系统,包括Windows、MacOS和Linux。GPT4All官网GPT4All的新功能GPT4All持续更新,引入了多项新功能,如GGUF格式的支持、Nomic Vulkan、LocalDocs功能和基于Docker的API服务器。这些功能进一步增强了GPT4All的灵活性和可用性。GPT4All的安装从官网下载GPT4All用户可以直接从GPT4All官网下载软件。下载后,用户需要更改安装目录以适配自己的计算机环境。更改安装目录创建模型文件夹安装GPT4All后,用户需要在软件目录中创建一个名为models的文件夹,用于存放下载的模型文件。创建模型文件夹启动GPT4All启动GPT4All后,用户需要在软件中修改目录,指向之前创建的models文件夹。修改目录GPT4All的使用方法加载模型用户可以通过GPT4All下载或从浏览器直接下载所需的模型文件,并将其移动到models目录下。GPT4All目前仅支持.gguf格式的文件。下载模型开始测试选择模型后,用户可以开始测试GPT4All的功能,如对话生成等。开始测试GPT4All的案例应用个人对话助手GPT4All可以作为个人对话助手,帮助解答日常问题。团队内知识库在团队中,GPT4All可以作为知识库,用于文档索引和搜索。网站客服智能对话GPT4All还可以作为网站客服,提供在线问题支持。教育培训辅助系统在教育培训领域,GPT4All可以作为辅助系统,提供学习问答帮助。LLMs之LLaMA3:基于GPT4All框架的模型部署通过GPT4All框架,用户可以实现LLaMA-3模型的部署和推理。用户可以加载训练后的LLaMA-3的.gguf模型文件,并在GUI界面中实现对话聊天。GPT4All Python SDK安装要开始使用,请在你的 python 环境中通过 pip 安装 gpt4all 包。pip install gpt4all我们建议使用 venv 或 conda 将 gpt4all 安装到其自己的虚拟环境中。加载 LLM模型通过 GPT4All 类按名称加载。如果这是你第一次加载模型,它将被下载到你的设备并保存,以便下次创建同名 GPT4All 模型时可以快速重新加载。GPT4All 经过优化,可在消费级硬件上运行参数范围为 30 亿至 130 亿的大型语言模型(LLMs)。LLMs 会被下载到您的设备上,因此您可以在本地私密地运行它们。借助我们的后端,任何人都可以在自己的硬件上高效安全地与 LLMs 进行交互。下载模型GPT4All 最便捷的部署方式是下载其官方桌面客户端(支持windows、linux(ubuntu)、macos)。这是一个可以直接安装和运行的应用程序,用户无需配置复杂的编程环境。安装后,用户可以在客户端内直接下载所需的模型文件(如 gguf 格式的模型),随后即可开始在本地与模型进行对话。这种方式极大地简化了部署流程,适合非技术背景或希望快速体验的用户,真正实现了“开箱即用”。2通过 Python 库进行部署对于开发者或希望进行深度集成的用户,GPT4All 支持通过 Python 环境进行部署。用户需要在本地安装 Python,并通过安装依赖包来运行模型。主要的步骤通常包括:配置 Python 环境并安装必要的依赖包。在代码中下载或指定模型文件路径。调用 GPT4All 的接口加载模型并进行推理对话。这种方式提供了更高的灵活性和控制权,例如可以集成到自定义的应用流程中。需要注意,在网络配置不当时(如开启了某些代理设置),可能会在下载或加载模型时遇到连接错误,通常的解决方法是调整本地网络环境。6 LocalAIocalAI的终极目标是成为OpenAI API的1:1本地替代品。如果你现有的应用是针对OpenAI开发的(比如用了LangChain或AutoGPT),你只需把API地址指向LocalAI服务器,就能在不修改代码的情况下,将云端AI替换为本地运行的模型。核心优势全模态支持,远超文本生成LocalAI不仅能跑文本大模型,还能直接运行:音频转录(Whisper、WhisperX支持说话人分离)语音合成(Pocket-TTS、VoxCPM,支持流式输出)图像生成(Stable Diffusion,v3.10.0新增视频生成)实时语音对话(v3.11.0引入Realtime Audio功能)音乐生成(Ace-Step MusicGen界面)原生支持Agent和MCP协议这是LocalAI相较于前两者的最大差异化优势。LocalAI原生支持模型上下文协议(MCP),可以让AI模型连接外部工具和API,实现实时数据访问、文件检索、命令执行等能力。2026年3月发布的v4.0.0更将LocalAI升级为一个完整的AI编排平台,带来了:全新React UI:完整的前端重写,交互体验大幅提升Agenthub社区中心:可以分享和导入预制的智能体配置Canvas代码预览模式:在聊天界面中并排显示代码块MCP客户端全面支持:工具流式传输、多服务器配置MLX分布式实验性支持:利用Apple MLX框架运行分布式工作负载极低的硬件要求LocalAI的模块化架构采用”按需下载后端”的设计,可自动检测硬件并支持CPU、GPU、Metal、Jetson甚至分布式加速。即使没有GPU,也能在普通CPU上流畅运行大模型。适合谁深入研究Agent协同架构、MCP协议的技术探索者需要在单一项目中同时处理语音、图像、文本多模态任务的人希望完全本地替代云端API,具备后端工程能力的DevOps工程师硬件配置建议:入门级:8GB内存 + 4核CPU体验级:16GB内存 + 8核CPU专业级:32GB内存 + GPU加速🚀 三种部署方案任你选方案A:Docker一键部署(最适合新手)基础CPU版本(推荐首次尝试):docker run -d --name my-localai \ -p 8080:8080 \ -v ./models:/models \ localai/localai:latest-aio-cpubashGPU加速版本(性能追求者):docker run -d --name localai-gpu \ -p 8080:8080 \ --gpus all \ -v ./models:/models \ localai/localai:latest-aio-gpu-nvidiabash方案B:源码编译安装(定制化需求)适合需要深度定制或开发环境搭建的用户:git clone https://gitcode.com/gh_mirrors/loc/LocalAIcd LocalAImake buildbash方案C:二进制包直装(极速体验)追求最简单快捷的用户选择:下载并运行wget https://github.com/go-skynet/LocalAI/releases/latest/download/local-ai-linux-x86_64chmod +x local-ai-linux-x86_64./local-ai-linux-x86_647 XinferenceXinference 是由 Xorbits 团队开发的一套 本地大模型推理和服务框架,目标是让你像用数据库一样简单地使用 LLM (大语言模型) 和 Embedding 模型,支持 Chat / Completion / Embedding / TTS / STT 等多种任务。官网:http://xinference.io[1]GitHub:http://github.com/xorbitsai/i…[2]模型任务类型说明二、核心特性支持多模型和多任务Chat :Qwen, ChatGLM, LLaMA, Baichuan, MistralEmbedding :BGE, Nomic, E5, InstructorCompletion :GPT-J, Pythia, RWKVTTS/STT :Whisper, Bark, Coqui一行命令启动xinference-local2025-07-21 10 28 11.png提供 REST API + OpenAI 符合接口REST 接口可直接调用兼容 OpenAI SDKWeb UI简洁易用,支持模型添加、操作、清除支持自由添加 HuggingFace 模型2025-07-21 10 26 12.png分布式和 CPU/GPU 选择支持单机 CPU ,多 GPU ,简易分布式启动三、安装指南依赖Python >= 3.9pip / conda 环境pip 安装pip install "xinference[all]"如果只需基础 REST 接口:pip install xinference四、启动 Xinferencexinference-local --log-level=info启动后访问:http://127.0.0.1:9997如看到 Web UI 界面,表明启动成功。五、注册模型注册 Chat 模型curl -X POST http://127.0.0.1:9997/v1/models \ -H "Content-Type: application/json" \ -d '{ "model_name": "qwen:0.5b", "model_format": "xinference", "quantization": "q4", "task": "chat" }'注册 Embedding 模型(本地免费推荐)注册 Embedding 模型前要安装 sentence_transformers 引擎,否则会启动失败。pip install -U sentence-transformerscurl -X POST http://127.0.0.1:9997/v1/models \ -H "Content-Type: application/json" \ -d '{"model_name": "bge-base-zh", "model_format": "xinference", "model_type": "embedding", "model_engine": "sentence_transformers" }' 8 llamafile你还在为部署大语言模型(LLM)时的复杂流程烦恼吗? llama.cpp框架虽强大但配置繁琐,Docker容器又占用过多资源,云服务更是存在数据隐私风险。现在,llamafile彻底解决了这些问题——一个文件即可分发和运行LLM,无需安装依赖,本地执行保障数据安全。本文将带你通过3个简单步骤,从零基础到成功运行自己的AI助手,同时揭秘跨平台兼容的核心技术原理。准备工作:认识llamafilellamafile是一种革命性的LLM分发格式,它将模型权重、运行时和Web服务打包成单个可执行文件。这种技术基于Mozilla的APE(Application Portable Executable)格式,实现了"一次构建,到处运行"的跨平台能力。项目核心优势包括:零依赖部署:无需预装Python、CUDA或特定系统库跨平台兼容:支持Windows、macOS、Linux等主流操作系统数据本地处理:所有计算在本地完成,避免隐私泄露体积优化:采用GGUF格式压缩模型,平衡性能与存储需求官方文档提供了完整技术细节:技术规格说明步骤一:获取llamafile文件llamafile提供两种使用方式:内置模型权重的完整包或仅含运行时的轻量版。对于新手,推荐从官方示例开始:下载预打包模型访问HuggingFace获取LLaVA多模态模型(4.29GB):llava-v1.5-7b-q4.llamafile该模型支持图像理解,可直接上传图片提问。验证文件完整性下载完成后检查文件大小是否为4.29GB,避免因网络中断导致的文件损坏。⚠️ 注意:Windows系统存在4GB可执行文件限制,若使用超过此容量的模型(如13B参数版本),需采用外置权重模式:外置权重使用指南步骤二:系统配置与权限设置不同操作系统需要进行简单的权限配置,以确保llamafile能够正常执行:Windows系统将下载的文件重命名为llava-v1.5-7b-q4.llamafile.exe右键文件 → 属性 → 安全 → 编辑,确保当前用户拥有"读取和执行"权限macOS系统打开终端,导航至下载目录:cd ~/Downloads添加可执行权限:chmod +x llava-v1.5-7b-q4.llamafile解决开发者验证问题:系统设置 → 隐私与安全性 → 底部允许"llava-v1.5-7b-q4.llamafile"运行Linux系统终端执行权限命令:chmod +x llava-v1.5-7b-q4.llamafile对于部分发行版(如Ubuntu),可能需要安装APE格式支持:sudo wget -O /usr/bin/ape https://cosmo.zip/pub/cosmos/bin/ape-$(uname -m).elfsudo chmod +x /usr/bin/apesudo sh -c "echo ':APE:M::MZqFpD::/usr/bin/ape:' >/proc/sys/fs/binfmt_misc/register"bash详细的系统兼容性问题解决方案:故障排除指南步骤三:启动与使用AI助手完成上述准备后,只需一个命令即可启动完整的AI服务:基础启动方式在终端中执行:./llava-v1.5-7b-q4.llamafilebash首次运行会显示初始化进度,成功后将自动打开浏览器,展示Web界面。若浏览器未自动启动,手动访问:http://localhost:80809 llama.cpp什么是 llama.cpp?llama.cpp 是一个用 C/C++ 编写的大语言模型推理框架,目标是在消费级硬件上高效运行 LLM。它支持 macOS、Linux、Windows 以及各种 GPU 加速后端,是目前最流行的本地 AI 推理工具之一。安装指南方式一:包管理器(推荐新手)macOS (Homebrew)brew install llama.cppWindows (winget)winget install llama.cppNix/NixOSnix-env -iA nixpkgs.llama-cpp方式二:下载预编译二进制访问 Releases 页面 下载对应系统的预编译版本,解压即可使用。方式三:使用 Dockerdocker run -it --gpus all ghcr.io/ggml-org/llama.cpp:latest方式四:从源码编译克隆仓库git clone https://github.com/ggml-org/llama.cppcd llama.cppmacOS / LinuxmakeWindows (使用 CMake)cmake -B buildcmake --build build --config Release启用 GPU 加速(可选)NVIDIA CUDAmake LLAMA_CUDA=1Apple Metalmake LLAMA_METAL=1Vulkanmake LLAMA_VULKAN=1获取模型llama.cpp 使用 GGUF 格式的模型文件。获取模型有几种方式:方式一:直接从 Hugging Face 下载使用 llama-cli 直接下载并运行llama-cli -hf ggml-org/gemma-3-1b-it-GGUF方式二:手动下载访问 Hugging Face 搜索 GGUF 格式的模型,例如:https://huggingface.co/ggml-orghttps://huggingface.co/TheBloke (大量量化模型)下载 .gguf 文件到本地。方式三:自己转换如果有原始模型(如 Hugging Face 上的 PyTorch 模型),可以使用 convert-hf-to-gguf.py 脚本转换:python convert-hf-to-gguf.py path/to/model --outfile model.gguf基本使用命令行交互使用本地模型文件llama-cli -m path/to/model.gguf指定更多参数llama-cli -m model.gguf \ -p "你好,请介绍一下自己" \ -n 512 \ --temp 0.7常用参数:-m:模型文件路径-p:提示词(prompt)-n:生成最大 token 数--temp:温度(创造性,0-1)--ctx-size:上下文窗口大小启动 API 服务器llama.cpp 可以启动一个 OpenAI 兼容的 API 服务器:llama-server -m model.gguf --host 0.0.0.0 --port 8080启动后,可以用任何 OpenAI 客户端连接:from openai import OpenAIclient = OpenAI(base_url="http://localhost:8080/v1", api_key="not-needed")response = client.chat.completions.create(model="local-model", messages=[ {"role": "system", "content": "你是一个有帮助的助手"}, {"role": "user", "content": "你好!"} ])print(response.choices[0].message.content)多模态使用(图像 + 文本)llama-cli -m llava-model.gguf \ --mmproj mmproj-model.gguf \ -i image.jpg \ -p "描述这张图片"高级配置GPU 加速NVIDIA CUDAllama-cli -m model.gguf -ngl 99-ngl 指定卸载到 GPU 的层数,99 表示全部卸载。Apple Metalllama-cli -m model.gguf -ngl 99Vulkanllama-cli -m model.gguf -ngl 99 -vgpu 0量化模型选择量化可以在几乎不影响质量的情况下大幅降低显存占用:上下文窗口调整llama-cli -m model.gguf --ctx-size 8192更大的上下文窗口可以处理更长的文档,但会增加内存占用。常见问题显存不足怎么办?使用量化程度更高的模型(如 Q4 instead of Q8)减少 -ngl 参数,让部分层在 CPU 上运行选择更小的模型(7B instead of 70B)推理速度太慢?确保启用了 GPU 加速(-ngl 99)使用量化模型减少 --ctx-size关闭不必要的后台程序如何保存对话历史?使用 --conversation 参数或自行管理对话历史:llama-cli -m model.gguf \ --conversation \ --conversation-file chat.json生态系统工具桌面应用LM Studio:图形界面,适合新手Jan:开源的本地 AI 平台Ollama:简化的模型管理工具编辑器插件VS Code: llama.vscodeVim/Neovim: llama.vim编程语言绑定Python: pip install llama-cpp-pythonNode.js: npm install node-llama-cppRust: cargo add llama-cpp-rs推荐的入门模型新手推荐(显存 8GB 以下)Gemma 3 1B/4BPhi-3 Mini (3.8B)Qwen2.5 3B/7B (量化版)中端配置(显存 12-16GB)LLaMA 3 8BMistral 7BGemma 2 9B高端配置(显存 24GB+)LLaMA 3 70B (量化版)Mixtral 8x7BQwen2.5 72B (量化版)总结llama.cpp 让本地运行大模型变得简单。无论你是想保护隐私、节省成本,还是单纯想学习 AI 技术,它都是一个优秀的起点。快速开始三步:安装 llama.cpp下载一个 GGUF 模型运行 llama-cli -m model.gguf开始你的本地 AI 之旅吧!9 JanJan 的主要功能之一是支持本地运行 AI 模型,如 Llama 或 Mistral,这样可以提高隐私性,不需要互联网连接。如果你需要讨论敏感内容,本地运行模型更为安全。例如,在需要保密的项目中,Jan 的本地模型功能可以确保对话的私密性和安全性。如果你不需要本地模型,Jan 也可以连接到远程模型,如 OpenAI、Gro 或 Mistral API,这样你就不需要高级硬件来访问这些模型的功能。这种灵活性特别有用,当你需要在线模型的能力但仍希望在必要时切换到本地模型。所有对话内容都存储在本地。此外,Jan 跨平台支持 Mac、Linux 和 Windows,极大地提升了可访问性。Jan 还提供了 API 端点,方便你在自定义应用程序或其他 AI 应用中使用,这些 API 端点与 OpenAI 兼容,所以你可以与任何支持 OpenAI 模型的应用程序一起使用。你还可以通过扩展选项设置其他功能,例如添加自定义插件以增强 Jan 的功能或将其与其他工具和服务集成。它支持处理 PDF、文档等任何可以解析的文本文件。Jan 有两个内置引擎用于推理:Llama CPP 和 Tensor RT LM,默认使用 Llama CPP。双引擎的设计为模型推理提供了更多的灵活性和选择。你还可以将 Jan 连接到 LM Studio 或 AMA 的端点。现在让我们安装并试用一下。首先,访问 Jan 的网站并点击下载按钮,选择你的操作系统并下载安装文件。10 本地大模型运行原理:以ollama 为例子简单来说,Ollama的工作流程确实是:将模型权重从硬盘加载至内存(或GPU显存),然后通过优化的推理后端进行计算。 但其中包含几个关键细节:模型存储与格式:GGUFOllama使用 GGUF (GPT-Generated Unified Format) 格式的模型文件。这种格式的特点是:已量化:您从Ollama库下载的模型,如 deepseek-r1:7b,已经是经过量化(例如Q4_K_M)的版本,文件大小比原始FP16模型小得多(如7B模型约3.8GB)。分层加载友好:GGUF格式允许系统只将当前计算需要的部分模型层加载到最快的内存(如GPU显存),其余部分可以留在系统内存或硬盘,这在资源有限的设备上至关重要。加载过程:动态且分层当您运行 ollama run deepseek-r1:7b 时,发生以下步骤:检查与准备:Ollama检查本地是否已有该模型文件。如果没有,则从服务器下载到硬盘(默认位置如 ~/.ollama/models)。分配计算设备:Ollama自动检测您的硬件环境。如果检测到性能足够的NVIDIA/AMD GPU,它会优先将模型权重加载到GPU显存中以获得最快速度。如果GPU显存不足或无GPU,它会自动回退到使用CPU和系统内存进行推理。智能加载:它不会一次性将整个模型文件“笨拙”地全部塞进显存。对于非常大的模型或显存不足的情况,Ollama的后端(通常是llama.cpp)可以执行分层卸载,只将最关键的层(如前20层)放在GPU显存,其余层留在内存甚至需要时从硬盘动态读取,以平衡速度与资源限制。推理计算:不直接调用CUDA后端引擎:Ollama本身不直接编写CUDA内核。它依赖一个名为 llama.cpp 的高效推理库作为其核心计算引擎。llama.cpp 是用C++编写的,它针对CPU和GPU(通过CUDA for NVIDIA,Metal for Apple Silicon)进行了深度优化。跨平台支持:在Mac上,llama.cpp 会调用 Metal Performance Shaders;在Windows/Linux的NVIDIA显卡上,它会调用 CUDA;在AMD显卡或纯CPU环境下,它使用高度优化的AVX指令集进行计算。简化操作:Ollama的价值在于,它为您封装了所有这些底层细节。您无需手动安装CUDA驱动、配置PyTorch或编译llama.cpp,一个简单的 ollama run 命令就完成了从下载、加载到运行的全部过程。总结流程整个流程可以概括为:硬盘(GGUF模型文件)↓ (按需、分层加载)系统内存 / GPU显存 (根据硬件自动选择)↓ (通过封装好的 llama.cpp 引擎)计算推理(在CPU/GPU上进行)↓ 生成回答 Ollama的魔力在于它通过GGUF格式、智能资源管理和封装的llama.cpp后端,让这个过程变得极其简单、自动化和高效,使得在消费级硬件上运行大模型成为可能
-
AI专题十九: AI 应用从低级到高级分类 山姆·奥特曼提出的官方框架:AI发展的“五个级别”奥特曼在多次访谈中(如2024年的一次闭门分享)清晰地提出了AI能力演进的五个级别,其核心是AI的自主性和解决问题的能力,而非单纯的应用形态。这五个级别是:级别1:对话式AI(Chatbot):能够进行开放域对话,但仅限于对话本身。代表:ChatGPT的对话模式。级别2:推理者(Reasoner):能够解决与人类博士水平相当的复杂问题。代表:OpenAI的o1模型。级别3:执行者/智能体(Agent):能够代表用户主动执行多步骤任务,例如“帮我预定下周的整个行程”。级别4:创新者(Innovator):能够自主进行研究和创造,提出新的想法和解决方案。级别5:组织者(Organizer):能够管理一个组织或大型项目,承担类似CEO的职能。结论:奥特曼的框架是 “能力等级”。从AI 应用场景从低级到高级:业界对这类 AI 应用没有一个完全统一的官方标准命名,但目前比较常见的分法,通常会按“能力层级 / 行为方式 / 所在环境”来命名。你提到的四类,可以大致对应成下面这样:1) 对话式 AI常见命名:Conversational AIChatbots / AI ChatbotsLLM assistantsCopilots(偏“辅助型”产品语境)特点:主要在文本/语音对话中完成问答、生成、总结、检索等任务不直接执行复杂动作,更多是“说”和“写”2) 智能体工作流 AI常见命名:AI AgentsAgentic WorkflowsWorkflow AgentsTask AgentsTool-using Agents / Tool-augmented Agents特点:不只是聊天,而是能调用工具、拆解任务、按步骤执行常见于:自动写邮件、查资料、生成报告、调用 API、触发业务流程“Workflow”一词强调人设计流程,AI 执行流程“Agentic”一词强调AI 自主性更强3) 操作电脑的 AI常见命名:Computer-Using Agents (CUA)Computer Use AIDesktop AgentsGUI AgentsBrowser Agents / Web AgentsRPA + AI(在企业场景里常和 RPA 融合提法)特点:AI 直接操作鼠标、键盘、浏览器、桌面软件不依赖 API 接口,而是像人一样看屏幕、点按钮、输入内容典型场景:自动填写表单、跨系统搬运信息、网页操作、后台流程执行这个方向近两年业界很常见的关键词就是 Computer Use 或 Computer-Using Agent。4) 进入物理世界的 AI 机器常见命名:Embodied AIRobotics / AI RoboticsPhysical AIRobot AgentsAutonomous RobotsGeneralist Robots(更偏前沿叙事)特点:AI 不再只在数字世界行动,而是驱动机器人、机械臂、无人设备等需要感知、规划、控制、与真实环境交互典型场景:仓储机器人、工业机械臂、家庭机器人、自动驾驶、无人机等其中:Embodied AI 更强调“具身智能”Physical AI 是近年 NVIDIA 等厂商带火的说法,强调 AI 进入现实物理环境Robotics 则是最通用、最传统的总称一个更常见的业界分层说法如果按“从低到高”或“从虚拟到物理”来概括,常会这样写:Conversational AIAI Agents / Agentic WorkflowsComputer-Using Agents / GUI AgentsEmbodied AI / Physical AI / RoboticsAI 智能等级L0~L5 定义根据搜索结果,目前全球范围内尚未形成像自动驾驶SAE标准那样唯一、权威且被强制遵循的AI智能程度分级标准。但借鉴自动驾驶分级思想,业界已涌现出多个从不同维度对AI智能化程度进行划分的分类框架,这些框架旨在为AI技术的发展路径提供评估坐标。自动驾驶分级标准作为参考基准自动驾驶的分级为AI智能化分级提供了直接的灵感来源。根据国际自动机工程师学会(SAE)的定义,驾驶自动化分为L0至L5六个等级,核心在于明确系统与驾驶员在动态驾驶任务中的角色分配。L0-L2级为辅助驾驶,驾驶员需持续监控;从L3级开始进入自动驾驶范畴,系统可在特定条件下执行全部驾驶任务;L5级为在任何环境下都能实现的完全自动驾驶。这一分级清晰地量化了机器替代人类驾驶的程度1121516。AI智能分级同样希望量化机器在认知、决策和行动任务上替代或辅助人类的程度。AI智能体与Agent能力分级的主要提案业界借鉴自动驾驶分级逻辑,提出了多个AI智能分级方案,其核心在于评估AI的自主决策和执行能力。360创始人周鸿祎提出了五级分类法:L1是仅有对话能力的聊天助手;L2是需人类设置流程的低代码工作流智能体;L3是能自主规划完成任务的推理型智能体(领域专家);L4是多智能体蜂群协作系统;L5则是具备完全自主意识的超级AI系统26。学术研究领域,有论文将AI智能体分为五个能力级别:从L0的无AI工具,到基于规则的L1,再到应用模仿/强化学习的L2,进而发展到基于大语言模型并具备记忆反思的L3,以及能自主学习和泛化的L4,最高级的L5则引入个性情感与多智能体协作35。OpenAI也建立了内部五级标准,从当前的ChatGPT(接近L2)到能够代表用户行动的L3、能创造新事物的L4,直至能执行组织工作的L5。这些分级框架都将关注点从单一的对话能力,扩展到了AI的任务规划、工具调用、自主执行及多智能体协作能力48。其他领域的智能等级评估标准智能化分级的思想已扩展到更广泛的终端领域。在AI手机领域,中国信息通信研究院联合厂商发布的《终端智能化分级研究报告》定义了L1至L5五个等级,从仅响应指令的L1,到能识别简单意图的L2,再到能处理复杂意图并自主规划的L3,最终发展到能预测意图并基于全场景自主规划的L59。在人形机器人领域,业界也发布了全球首个《人形机器人智能化分级》团体标准,围绕感知认知、决策学习、执行表现和协作交互四大维度,将智能化划分为L1至L5级10。这些标准表明,针对特定应用场景的智能化水平评估正在走向标准化。总结:概念框架而非统一标准综上所述,尽管汽车自动驾驶的L1-L5分级已被国际标准化,但AI智能程度目前尚未形成与之对应的全球统一官方标准。现有的多种分级方案均为企业、学术界或行业组织提出的概念性框架或团体标准,其目的在于为技术演进、产品定位和产业讨论提供参考坐标8。这些分级共同揭示了AI从被动工具到自主智能体的发展路径,有助于公众和业界理解AI技术的发展阶段与未来方向
-
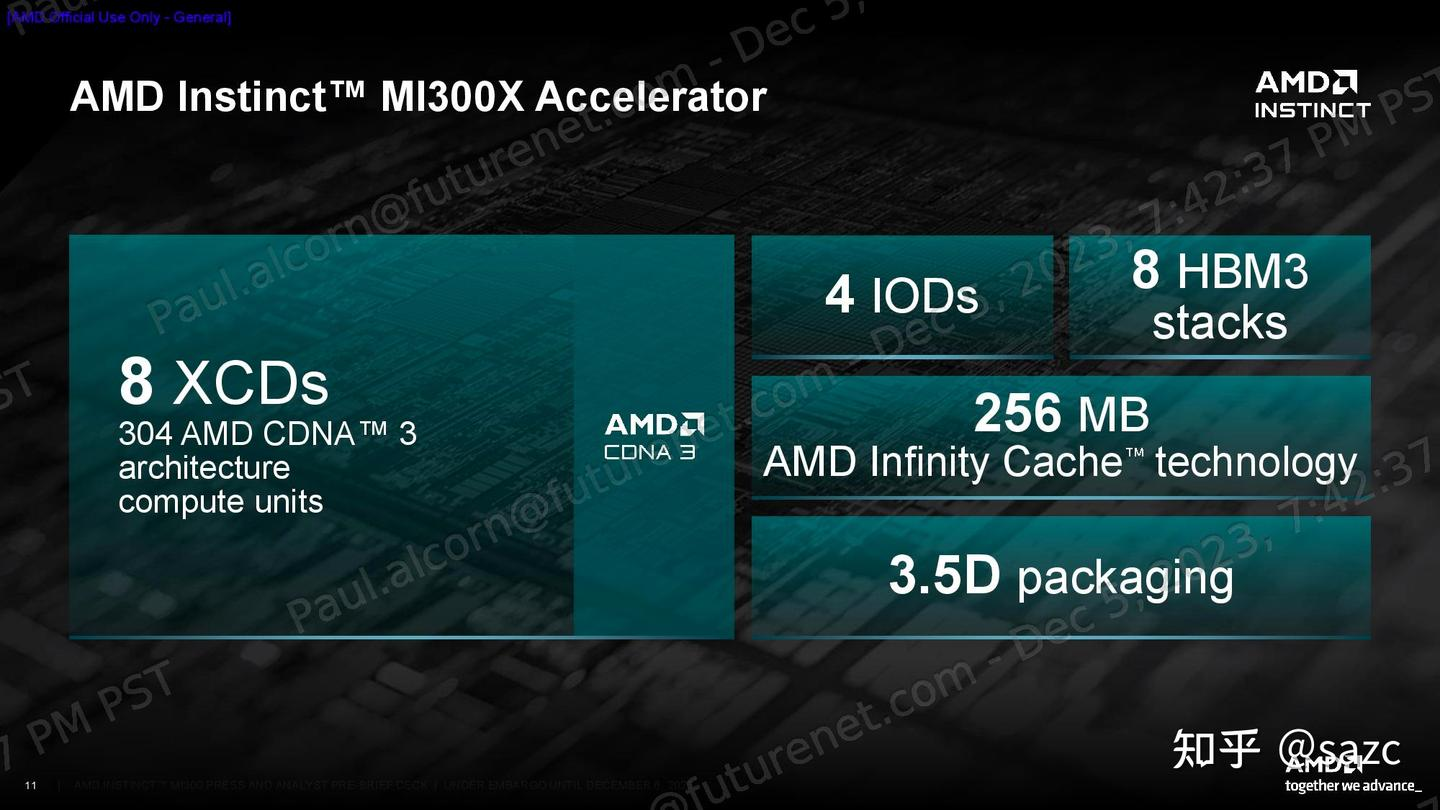
AI专题十七:一个AI算力板块上多颗chiplet之间的chip-to-chip连接 1 H100 板卡NVIDIA H100 实际上采用的是单一大芯片(Monolithic)设计,而非 Chiplet/MCM 多芯片设计。项目规格GPU 型号GH100(Hopper 架构)制造工艺台积电 4N 定制工艺晶体管数量800 亿Die 尺寸814 mm²架构类型单一大芯片(Monolithic),非 Chiplet所以NVIDIA H100 GPU板卡没有多颗算力芯片的chiplet 的 chip-to-chip连接2 一个AI算力版本上集成多颗算力chiplet 的方案AMD MI300X 架构详解板卡上的 Chiplet 组成组件数量工艺节点功能XCD (Accelerator Complex Die)8 颗台积电 5nmGPU 计算芯粒,每颗含 38 个 CUIOD (I/O Die)4 颗台积电 6nmI/O 芯粒,含内存控制器、Infinity Fabric 网络HBM3 堆栈8 颗-每颗 24GB,共 192GBNVIDIA Blackwell (B100/B200) 架构详解板卡上的 Chiplet 组成组件数量工艺节点功能GPU Compute Die2 颗台积电 4NP计算芯粒,每颗约 1040 亿晶体管HBM3e 堆栈8 颗-每颗 24GB,共 192GB双 Die 互连结构Blackwell 采用 NV-HBI(NV-High Bandwidth Interface) 连接两颗计算芯粒┌─────────────────┐ NV-HBI (10 TB/s) ┌─────────────────┐ │ GPU Die 0 │ ←────────────────────→ │ GPU Die 1 │ │ (104B 晶体管) │ 芯片间高带宽接口 │ (104B 晶体管) │ │ │ │ │ │ 80 SM (第5代) │ │ 80 SM (第5代) │ │ 5 颗 HBM3e │ │ 3 颗 HBM3e │ └─────────────────┘ └─────────────────┘ ↓ ↓ ┌─────────────────────────────────────────────────────┐ │ TSMC CoWoS-L 硅中介层 │ │ (Local Silicon Interconnect 技术) │ └─────────────────────────────────────────────────────┘两颗 reticle-limited dies(约 800mm² 每颗)通过 NV-HBI 以 10 TB/s 速率连接 szwecent.com• 采用 TSMC CoWoS-L 封装技术(带 LSI 芯片的 RDL 中介层)EnosTech.com• 对外呈现为 单一统一 GPU(逻辑上不是双 GPU)上面两个GPU 板块对比特性AMD MI300XNVIDIA B100/B200Chiplet 数量12 颗(8 XCD + 4 IOD)2 颗 GPU Die每个 Chiplet 内部 Die 数XCD: 1 颗 DieIOD: 1 颗 Die每颗 GPU Die: 1 颗大 Die堆叠方式3.5D(3D SoIC + 2.5D CoWoS)2.5D CoWoS-L(双 Die 平铺)内部互连技术Infinity Fabric APNV-HBI (10 TB/s)外部互连技术Infinity Fabric (896 GB/s)NVLink 5.0 (1.8 TB/s)计算单元304 CU (8×38)160 SM (2×80)内存容量192 GB HBM3192 GB HBM3e总晶体管数~1530 亿2080 亿3 一个AI算力板块上多颗chiplet之间的chip-to-chip连接互联技术带宽(双向,典型配置)延迟(链路延迟,典型场景)能效(每字节传输能耗/相对值)一致性支持PHY面积(相对PCIe Gen5,同工艺)关键备注NVLink C2C(4.0)单链路900GB/s;多链路可聚合(如Grace Hopper平台)亚纳秒级(<1ns,封装内芯片间)1.3皮焦/字节;相对PCIe Gen5提升25倍支持全缓存一致性,兼容AMBA CHI协议10%(面积效率提升90%)专为芯片级短距互联设计,依赖先进封装(MCM/硅中介层)PCIe Gen5x16链路:128GB/s(单通道32GT/s,NRZ调制)15-30ns(板级设备间)相对NVLink C2C低25倍;典型每字节能耗~32.5皮焦不支持原生缓存一致性,需上层协议扩展100%(基准值)通用I/O互联,生态成熟,适用于板级外设连接PCIe Gen6x16链路:256GB/s(单通道64GT/s,PAM4调制)<10ns(板级设备间,FLIT模式)相对PCIe Gen5提升50%;每字节能耗~21.7皮焦不支持原生缓存一致性110%-120%(引入FEC和PAM4,面积略有增加)兼容前代PCIe设备,支持动态FLIT/TLP模式切换CCIX 1.1x16链路:100GB/s(单通道25Gbps,NRZ);扩展模式可达更高10-20ns(板级CPU-加速器间)相对PCIe Gen5提升2-3倍;每字节能耗~10-16皮焦支持全缓存一致性,基于AMBA CHI协议演进95%-105%(基于PCIe物理层,面积相近)专为异构计算设计,优化CPU与加速器互联CXL 3.0x16链路:256GB/s(单通道64GT/s,PAM4,兼容PCIe 6.0)3-8ns(板级设备间,优化后)相对PCIe Gen5提升3-4倍;功耗密度2.8W/cm²支持全缓存一致性(CXL.cache/CXL.mem模式)80%-90%(复用PCIe PHY,协议层优化压缩面积)开放生态,兼容PCIe基础设施,适用于内存扩展与加速器互联Nvlink-C2CNVLink-C2C技术也可用于连接同一块PCB主板或同一台服务器内、不同封装的两个独立芯片。技术实现:通过芯片边缘的NVLink SerDes物理层接口,经由主板上的高速走线或连接器进行连接。1特点:这种连接距离比封装内远,但仍远优于传统PCIe,用于构建多芯片、多节点的紧密耦合系统。例如,可以将多个集成了NVLink-C2C IP的定制加速器芯片在板级互联。NVLink C2C的核心价值是打破单芯片性能瓶颈,实现多芯片(如CPU+GPU、CPU+CPU)在同一封装内的“超级芯片”级整合:AMD IF这是在同一块物理加速卡内部,连接多个GPU计算芯片(GCD)的桥梁。作用:让一块物理GPU卡内的多个计算芯片(例如MI250X包含2个GCD)能够像单个逻辑GPU一样协同工作,共享内存一致性域。示例:AMD Instinct MI250X:一块双芯GPU卡,其内部的两个图形计算芯片(GCD)就是通过极高带宽的Infinity Fabric链路(四向链路,双向带宽约200GB/s) 直接互联的。这是它实现高计算密度和内存一致性的基础。特点:带宽远高于传统的PCIe,是实现单卡内多芯片高效协同的关键。PCIE (包括PCIE GEN5 、PCIE GEN6)PCIe可以用于同一封装内Chiplet之间的通信,但这并非其最优或主要设计场景。其应用受到物理特性和协议开销的限制,主要出现在特定过渡或兼容场景中。主要特点与限制并非原生设计:PCIe协议设计初衷是板级或设备间通信,其物理层和协议栈包含了应对较长距离、信号完整性问题以及系统枚举的额外开销。高延迟与较大功耗:由于上述协议开销,在极短距离的Chip-to-Chip互连中,PCIe的延迟和功耗显著高于UCIe、AIB、BoW等专为Chiplet设计的互连标准。封装技术要求高:为了实现Chiplet间通信,需要将PCIe的SerDes(串行器/解串器)电路集成到每个Chiplet中,并在封装内布线,这对封装设计和信号完整性提出了挑战。主要应用场景尽管非最优,PCIe在Chiplet场景中仍有其应用价值,主要集中在以下方面:早期集成与原型验证在专用Chiplet互连标准(如UCIe)成熟和普及之前,或在对峰值带宽和极致延迟要求不高的场景中,开发团队可能选择使用成熟的PCIe IP进行Chiplet间的初步集成和功能验证,以缩短开发周期。2异构扩展与桥接当需要将一个基于PCIe设计的功能模块(例如,一个已验证的IP核、第三方IP或遗留设计)以Chiplet形式集成到先进封装中时,使用PCIe接口可以最大程度地避免对该模块内部架构的重新设计,实现“即插即用”。这常见于某些I/O、控制器或加速器Chiplet。2作为上层协议载体更常见且重要的应用方式是,物理层采用更高效的Chiplet互连标准(如UCIe),而在协议层运行PCIe。UCIe标准原生支持PCIe作为其上层协议之一。在这种架构下,Chiplet间享受了高带宽、低延迟的物理连接,同时在软件层面呈现为标准的PCIe设备,继承了PCIe完善的生态、驱动和操作系统支持。168系统级互联的补充在包含多个Chiplet的复杂封装中,可能同时存在多种互连。例如,计算核心与缓存之间采用超低延迟的专用总线,而与通用I/O Chiplet或外部内存控制器之间则可能采用PCIe,以满足不同的带宽、延迟和功能隔离需求。PCIE CCIXCCIX(缓存一致性互联协议)是一个旨在为CPU与加速器之间提供高性能、缓存一致互连的协议标准。它的核心目标是通过引入缓存一致性机制,简化异构系统的数据共享,降低时延,提升带宽。1CCIX的分层架构组成CCIX采用了分层架构设计,可以分为协议规范和传输规范两部分。CCIX协议规范:包含协议层和链路层,负责定义缓存一致性协议、消息格式、流量控制等。CCIX传输规范:包含事务层(CCIX和PCIe事务层)、数据链路层(PCIe数据链路层)和物理层(CCIX物理层),负责具体的数据包传输、错误校验和物理连接。23CCIX物理层的两种实现方式CCIX并非独立的物理接口,而是在物理层上兼容或扩展现有的高速互连标准。兼容PCIe PHY:CCIX规范要求设备必须支持两种物理层之一。一种是PCIe PHY,即完全使用PCIe标准的物理层和电气接口。这使得CCIX可以无缝运行在标准的PCIe插槽和链路上。扩展EDR PHY:另一种是CCIX EDR PHY。这是一种扩展模式,在原PCIe物理层基础上提升数据速率,支持20GT/s和25GT/s,以提供更高的原始带宽。CCIX与PCIe的关系和优势CCIX在设计上深度依赖于PCIe的成熟基础设施,并对其进行了功能扩展。协议层面复用与扩展:CCIX构建在PCIe的数据链路层之上,定义了自身的协议层和事务层,以支持缓存一致性。它既可以传输标准的PCIe数据包,也可以传输为一致性操作优化的、开销更小的CCIX包。35物理层面兼容与提速:CCIX可以在标准的PCIe物理层上运行,从而利用现有庞大的PCIe生态。同时,它又通过EDR模式提供了高于PCIe 4.0原生16GT/s的速率选项CCIX协议未被正式纳入PCIe Gen5或Gen6的核心规范,它作为一个独立的互联协议,通过复用PCIe物理层来实现高速互连。CIX没有“成为”PCIe规范的一部分,而是作为一种能够运行在PCIe物理通道上的、附加的协议层存在。它需要系统中的芯片(如CPU、加速器)专门集成CCIX控制器(即CCIX协议栈)才能启用。PCIE CXLCXL是一种独立的逻辑协议CXL(Compute Express Link)是一种开放标准的行业协议(即逻辑规范和数据通信规则),而非物理接口的硬件定义。它定义了主机处理器与加速器、内存扩展设备等之间进行高带宽、低延迟通信时所需的链路层、传输层及事务层协议,特别是强调了缓存一致性内存访问的语义。27CXL复用PCIe的物理层接口CXL协议在物理层完全复用并依赖于PCIe(特别是Gen 5及以上版本)的物理电气接口。这意味着CXL设备使用与PCIe设备相同的连接器、线缆和电气信号标准进行物理连接和数据传输。CXL利用PCIe的这种成熟物理基础来实现高速互连,从而简化了硬件设计和产业推广。125CXL并非PCIe协议的一部分CXL是一个与PCIe并行发展、相互协作但独立的协议。它没有成为PCIe协议的一部分。具体表现为:协议栈独立:CXL拥有自己独特的链路层和传输层协议(如CXL.cache, CXL.mem),这些协议在通过PCIe物理层传输前,会与CXL.io协议动态复用。35组织独立:CXL由独立的CXL联盟制定和维护,而PCIe则由PCI-SIG组织管理。两者是不同的行业标准机构。2兼容与共存:CXL设备可通过PCIe的Flex Bus接口兼容连接。如果主机或设备不支持CXL,链接将降级为标准的PCIe操作模式,这表明两者是共存而非融合的关系Unified BUSUnified BUS 也可用于C2C灵衢定义为面向超节点(SuperPoD) 的统一互联协议,旨在将 I/O、内存访问、异构计算单元(CPU/NPU/GPU等)之间的通信融合到同一技术体系中,实现高性能、高协同、高弹性的计算基础设施。UCIEUCIE 也可以用于C2CUCIe规范采用分层架构方法,在保持高性能的同时最大化灵活性和互操作性。在基础层面,物理层在电气层面处理芯间I/O,实现链路训练、通道修复/反转、扰码、模拟前端功能、时钟、侧带通信和配置寄存器。该层还定义通道要求并确保符合电气规范。物理层设计为适应不同的封装技术,同时保持一致的性能特性。中间层,称为芯间适配器,作为可靠性层负责确保可靠的数据传输。当使用多个协议时,实现仲裁和多路复用,处理CRC/重试机制进行错误检测和纠正,管理链路状态转换,并支持连接设备之间的参数协商。适配器维护可访问高级功能的配置寄存器,在原始模式下可完全绕过,用于需要直接访问物理层的专用应用。这种灵活性允许标准化和定制实现在UCIe框架内共存。在堆栈顶部,协议层支持多种接口类型,以适应多样化的使用模型。主要支持的协议是CXL/PCIe,适用于需要标准化"即插即用"功能的大量应用,如I/O附件、内存接口和加速器。这些协议利用现有软件生态系统,实现与当前系统架构的无缝集成。对于更专业的应用,UCIe还支持流式接口,可容纳AXI、CHI、SFI和CPI等专有协议。这种流式方法对于从较小芯片构建更大计算单元的扩展场景特别有价值,例如由多个较小元素组成的CPU、GPU和网络交换机。完整规范涵盖从物理凸点/键合焊盘层到形状因素定义的互连,为跨不同封装技术和应用领域的Chiplet集成创建了全面框架。
-
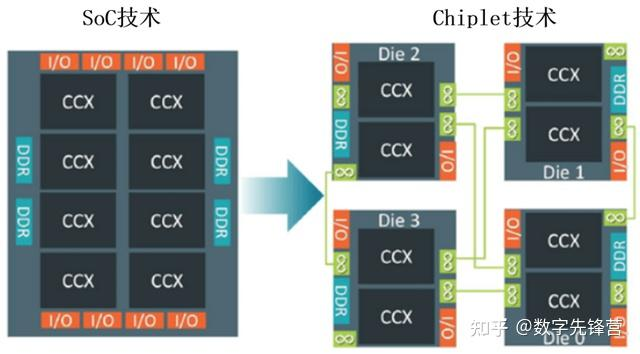
AI专题十六:AI算力chiplet的die-to-die连接 1 从SOC 到chipletChiplet又称“小芯片”或“芯粒”,它是一种功能电路块。Chiplet技术就是将一个功能丰富且面积较大的芯片裸片(die)拆分成多个芯粒(chiplet),并将这些具有特定功能的芯粒通过先进封装的形式组合在一起,最终形成一个系统芯片。而目前市场主流的SoC(英文全称是System-on-a-Chip)技术则与之相反,它是将多个负责不同功能的电路块通过光刻的形式制作到同一块芯片裸片(die)上,如手机SoC芯片,基本都集成了CPU、GPU、DSP、ISP、NPU、Modem等不同功能的计算单元和诸多的接口IP。SoC技术和Chiplet技术的关系示意图,如下所示:SoC技术对先进的纳米工艺有着高度的依赖。像手机芯片制造工艺就越来越高,从28nm一路升级到10nm、7nm、5nm,目前正进一步走向3nm甚至更低。不过,纳米工艺已经接近物理极限,业内普遍认为半导体行业正在进入后摩尔时代,需要寻找新的技术路线。于是,Chiplet技术被寄予厚望,很可能在未来几年成为一种主要的芯片设计形式。那么,Chiplet技术具体有哪些优点呢?Chiplet有哪些优势?首先,Chiplet技术把大芯片分成面积更小的芯片,有助于改善良品率,从而减少制造成本。通常,在晶圆加工过程中,离晶圆中心越远就越容易出现坏点。因此从硅晶圆中心向外扩展,坏点数呈上升趋势,所以企业无法随心所欲地增大晶圆尺寸,否则不良率会大幅上升。其次,SoC芯片的逻辑计算单元依赖先进制程来提高性能,其他部分通常可使用成本更低的成熟制程,SoC芯片Chiplet化之后,不同芯粒可以根据需要来选择合适的工艺制程分开制造,再通过先进封装技术进行组装,从而有效降低制造成本。2 chiplet die-to-die 连接方式die-to-die 连接示意图目前主流的chiplet die-to-die 主流连接接口根据下面信息,主要优先掌握ucie 、openHBI接口,了解Nvlink、Unified BUS连接。 几乎每家有实力做AI 算力芯片的公司都会搞自己私有的die-2o-die 接口。ucie统一Chiplet标准UCIe在众多Chiplet互联标准中,由Intel提出的通用Chiplet互联标准(UCIe)在很短时间内就引起了业界广泛关注,目前来看最有希望成为业界统一的互联标准。UCIe是唯一具有完整裸片间接口堆栈的标准,其他标准都没有为协议栈提供完整裸片间接口的全面规范,大多仅关注在特定层。此外,UCIe不但支持有机衬底或层压板等传统封装,也可以支持2.5D和桥接等先进封装,如硅衬底、硅桥或再分配层(RDL)扇出等形式,预计未来还会支持3D封装。UCIe协议栈本身有三层:最上端的协议层通过基于流量控制单元(FLIT)的协议实现,确保最大效率和最低延迟,并支持多个主流协议,包括PCIe、Compute Express Link(CXL),以及用户定义的流协议。中间的D2D适配层用于对协议进行仲裁与协商,以及通过裸片间适配器进行连接管理。基于循环冗余检查(CRC)和重试机制,该层还包括可选的错误纠正功能。最下面的物理层(PHY)规定了与封装介质的电气接口,是电气/模拟前端(AFE)、发射器/接收器以及边带通道(Sideband)在两个裸片之间进行参数交换与协商的层级。逻辑PHY可实现连接初始化、训练和校准算法,以及测试和修复功能。UCIe协议具有如下优点:UCIe的Sideband、DDR、Forward Clock设计使得UCIe单个应用场景下的模块设计复杂度相对更低,模块验证也更加容易;UCIe传输时延和功耗更低、速率更高、BER更低,在功耗和性能的平衡方面做得比其他协议好;由于和PCIe/CXL的无缝对接,可以利用PCIe现有的强大生态,轻松地将板级互联扩展到封装内部;UCIe不但支持PCIe向CXL的扩展,还支持用户自定义的Raw mode,一个D2D Adaptor 可持架接多个协议栈。目前已经有不少国内厂商加入UCIe联盟,其中包括:阿里云、日月光、长电、华为、芯原、灿芯、芯耀辉、超摩科技、合见工软、芯和半导体、长鑫、牛芯、芯云凌、芯来科技和奎芯等。此外,由中国计算机互连技术联盟(CCITA)发起的Chiplet标准《小芯片接口总线技术要求》在中科院计算所、工信部电子四院和国内多个芯片厂商合作推动下,也已经发布。小芯片接口总线技术的体系架构见下图,主要包括数据链路层(Data Link Layer,DLL)、物理适配层(Physical Adaptation Layer,PAL),以及物理层(Physical Layer,PHY)等。此标准列出了并行总线等三种接口,提出了多种速率要求,总连接带宽可以达到1.6Tbps,以灵活应对不同的应用场景以及不同能力的技术供应商。通过对链路层、适配层、物理层的详细定义,实现在小芯片之间的互连互通,并兼顾了 PCIe 等现有协议的支持,列出了对封装方式的要求。小芯片设计不但可以使用国际先进封装方式,也可以充分利用国内通用封装技术。BoWODSA正在定义一个名为Bunch of Wires (BoW)的芯片到芯片接口。BoW接口专注于解决基于有机基板的并行互连问题,BoW有BoW Base,BoW-Fast和BoW-Turbo三种类型,支持不同的传输距离和传输效率。此外,BoW支持向后兼容,并且对芯片工艺和封装技术的限制较少,不依赖于先进的基于硅的互连封装技术,具有广泛的应用范围Bunch of Wires(BoW)是一种适合Chiplet和芯片级封装(CSP)互联的简单物理接口架构,起初是针对数据中心计算、通信和网络需求的短距离互联解决方案,后来被OCP下属的开放特定域架构(ODSA)工作组采纳为用于连接同一封装内近距离裸片互联的接口协议。跟服务器板卡之间的互联不同,芯片封装内多个裸片的互联环境相对稳定,因为距离短,信号衰减小,因此互联设计可以比较简单。其实,BoW接口设计的初衷就是要实现低实施成本、兼容不同IC工艺节点,并可灵活支持各种封装技术凸凹间距,从而满足复杂芯片的低功耗、低延迟和高吞吐量要求。据OCP/ODSA介绍,BoW应用于Chiplet互联时具有如下优势:比现有并行标准更高的数据速率;适用于传统的低成本压层衬底封装及更高密度的硅interposer封装;比采用传统的SerDes链路设计更容易实现(较低的数据传输率可以使用单端信号及更密集的线束);兼容混合凸凹间距的封装情况。2018年,OCP与JEDEC联合起草了CDXML (Chip Data Exchange Markup Language)规范,定义了Chiplet互联的电气、机械和散热标准。这一针对2.5D或3D堆叠Chiplet设计的规范语言采用XML格式,并借鉴了多个现有JEDEC标准,包括JEP181散热标准和JEP30-P101电气/机械和I/O标准,以及IEEE 1687测试 和IEEE 2416电源模型标准。BoW 的开放式物理层和链路层规范旨在支持高性能 D2D 接口。关键性能指标包括每条线路高达 32Gb/s 的数据传输速率、低于 0.5pJ/bit 的能效和低于 8ns 的延迟。BoW 与各种封装和集成电路工艺的兼容性使其成为不同成本和性能设计点的通用解决方案。发展到 BoW 2.1为了促进开放式芯片经济的发展,BoW 正在不断改进,以满足新应用的需求,特别是在人工智能、边缘和物联网领域。即将发布的 BoW 2.1 版本将在三个关键领域引入规范扩展: 光学、内存和物联网。BoW简化了传统SerDes的复杂性,适合短距离互联:传统SerDes架构: BoW架构:┌────────────┐ ┌────────────┐│Serializer │ │ ││ PLL │ │ Simple ││ CDR │ │ Driver ││ Equalizer │ │ │└────────────┘ └────────────┘复杂度:高 复杂度:低功耗:>5 pJ/bit 功耗:<1 pJ/bit关键简化:无需时钟数据恢复(CDR)无需均衡器简单的单端驱动器源同步时钟物理层实现细节IO单元设计: ┌─────────────────────┐ TX───│ Driver │ │ - Impedance: 50Ω │───> Bump │ - Slew Rate Control│ └─────────────────────┘ ┌─────────────────────┐ RX<──│ Receiver │<─── Bump │ - Comparator │ │ - Hysteresis: 20mV │ └─────────────────────┘时钟分发网络:H-tree结构最小化偏斜每16个数据位配1个时钟相位插值器用于去偏斜最大偏斜:<50ps时钟架构深度分析转发时钟 vs 嵌入式时钟:转发时钟(AIB/BoW选择):优点:简单、低功耗、确定性延迟缺点:需要额外的时钟引脚适用:Chiplet等确定性连接嵌入式时钟:优点:无需时钟引脚、灵活缺点:需要CDR、功耗高适用:板级互联、光通信多时钟域处理:Die A (1GHz) Die B (1.5GHz) │ │ ├──> Async FIFO <──────┤ │ │ └──> Clock Domain ─────┘ Crossing (CDC)AIB/MDIOAdvanced Interface Bus (AIB)最初由Intel开发,用于FPGA的die-to-die互联。AIB 1.0特性(2017年):单端信令数据速率:2 Gbps/pin凸点间距:55μm功耗:0.85 pJ/bit应用:Intel Stratix 10 FPGAAIB 2.0改进(2019年):数据速率:4 Gbps/pin功耗优化:0.5 pJ/bit增强时钟架构DFT(Design for Test)增强作为AIB的升级版本,MIDO提供了更高的传输效率,并且响应速度和带宽密度是AIB的两倍以上。AIB和MDIO技术主要适用于通信距离短,损耗低的2.5D和3D封装技术,例如EMIB、Foveros。LIPINCONLIPINCON:LIPINCON是台积电多年前就开始研发的裸片之间数据互联接口技术,通过使用先进的基于硅的互连封装技术(例如InFO、CoWoS)和时序补偿技术,为Chiplet提出的高性能互连接口。LIPINCON可以在没有PLL/DLL的情况下降低功耗和占用面积。LIPINCON接口包含两种类型的PHY:PHYC和PHYM,分别用于SoC芯片和存储器/收发器芯片。OpenHBIOpenHBI 利用 JEDEC 的 HBM3 电气特性和 IO 类型来降低风险。它使用低电压和未端接的单端 DDR 信号来传输晶粒之间的数据。OpenHBI 标准具有许多关键特征:整合多个 OpenHBI 兼容 的 die-to-die 接口,实现互操作性利用 JEDEC HBM3 IO 类型和电气特性可与支持 HBM 存储器和 OpenHBI 标准的双模 HBM 主机控制器互操作支持硅中介层和晶圆级集成扇出或同等技术实现对称 die-to-die 接口实现目标速度:每引脚 8Gbps,正迈向 12-16 Gbps在最高数据传输速率时提供长达 3mm 的互连距离实现小于等于 0.5pJ/bit 的功耗目标提供大于 1.5T 位/毫米(包括发射器和接收器)的线性(边缘)带宽密度定义 PHY 和逻辑 PHY 抽象层,轻松适配上层支持正常的和旋转的晶粒方向可以调整带宽和边缘(DW 数量)以匹配各种用例支持小芯片 (Chiplet) 配置和测试 (CCT) 接口支持通道修复,提高制造良率OpenHBI 标准主要针对图 2 所示的下层(PHY 和逻辑 PHY 层)。然后将适配器层用于与上层(协议层)进行连接。因此,系统实现不依赖于各个应用所用的协议。Infinity FabricInfinity Fabric 是AMD为其Ryzen、EPYC等产品设计的内部互连架构。它由传输数据的Infinity Scalable Data Fabric和负责控制的Infinity Scalable Control Fabric组成,连接CPU核心、GPU、内存控制器以及多die之间和多个CPU插槽之间。它本质上是AMD的专有技术,不对外开放规格,主要用于其自家产品内部的die-to-die和多socket互连.NvlinkVIDIA的NVLink技术可以用于chiplet内部的die-to-die连接,其具体实现形式被称为NVLink-C2C。这项技术是NVIDIA应对chiplet和异构集成趋势的核心方案。以下是其关键特性与应用场景的详细说明:技术形态:NVLink-C2C这是一种专门为芯片内部或封装内die-to-die互连而设计的物理层和互连协议技术。它脱胎于高带宽的GPU间NVLink技术,但针对短距离、超高密度的片上互连进行了优化9。性能特点超高带宽与低延迟:在先进封装(如硅中介层)下,能提供高达900 GB/s的带宽,延迟极低,并支持缓存一致性9。高能效与面积效率:其能效比是PCIe 5.0的25倍,面积效率更是高达90倍,使其非常适合对功耗和空间极其敏感的chiplet设计9。主要应用场景NVLink-C2C主要用于连接NVIDIA自家的不同计算芯粒,构建超级芯片:CPU-CPU连接:例如在Grace Superchip中,用于连接两个Grace CPU die,形成一个统一的144核处理器9。CPU-GPU连接:例如在Grace Hopper Superchip中,用于连接Grace CPU die和Hopper GPU die,实现CPU与GPU间的高速协同9。为定制芯片提供接口:NVIDIA也将此技术以 “NVLink Fusion” 的形式开放授权。其他厂商(如定制AI加速器公司)可以将其Chiplet集成到自己的设计中,从而接入NVLink生态系统,与NVIDIA的GPU实现高速互连5813。与标准互连方案的对比与传统(板级)NVLink的区别:传统的NVLink用于连接独立的GPU卡或板级组件,通过PCB走线或电缆传输。而NVLink-C2C是通过封装内的硅中介层或硅桥进行连接,属于片上网络级别,带宽和能效更高9。与开放标准(如UCIe)的关系:在chiplet互连的开放标准领域,UCIe 是主流。NVIDIA的NVLink-C2C是一种专有高性能方案,主要服务于其自身的产品生态。虽然性能卓越,但开放性不及UCIe4。总结NVLink-C2C是NVIDIA用于chiplet内部die-to-die连接的专用高性能互连技术。它已成功应用于其Grace CPU和Hopper GPU的超级芯片设计中,并通过NVLink Fusion计划向合作伙伴开放,旨在构建一个以NVLink为核心的高速异构计算生态系统这是一个非常精准的技术命名问题。NVIDIA将其chiplet/芯片间互连技术命名为 NVLink-C2C(Chip-to-Chip),而非Die-to-Die(D2D),这一选择背后反映了其技术定位、封装层级和市场策略的深层考量。一、 技术层级与封装范畴的区分“Die-to-Die”通常指代的是在单个封装(Package)内部,不同硅片(裸片)之间的互连。 例如,AMD的Chiplet架构中,CCD与IOD之间的连接,或英特尔EMIB技术连接的裸片,都属于这个范畴。其特点是距离极短、功耗极低,通常依赖于硅中介层或先进封装技术实现超高密度布线。而“Chip-to-Chip”则定义了一个更宽泛、封装层级更高的互连范畴。 它明确包含了两种场景:单封装内裸片互连:即传统意义上的D2D。板级芯片互连:将两个独立的、已封装好的芯片(如一个Grace CPU封装和一个Hopper GPU封装)通过基板上的超高密度布线连接在一起,形成一个更大的“超级芯片”。NVLink-C2C的核心设计目标正是为了无缝覆盖以上两种场景。 例如在Grace Hopper超级芯片中,它既可用于连接同一封装内的计算单元,更重要的是用于连接独立的Grace CPU芯片和独立的Hopper GPU芯片,将它们整合为一个统一的内存系统。3510二、 强调技术扩展性与通用性使用 “Chip” 而非 “Die”,在语义和营销上更具扩展性:“Chip”是商品化的单元:在产业链和用户认知中,CPU、GPU、DPU都是可以独立采购、封装和测试的“芯片”。命名为C2C,清晰地传达了这项技术可用于连接这些已经成型的产品级芯片,而不仅仅是制造过程中的半成品裸片。体现技术通用性:它暗示该技术不仅可以用于NVIDIA自家芯片的互连,未来也可能开放给合作伙伴,用于连接其他符合标准的第三方芯片,构建更广泛的生态系统。这与D2D通常局限于同一家公司、同一封装内部的私有互连协议形成了概念上的区别。3三、 与UCIe等D2D标准进行战略区分在NVIDIA推出NVLink-C2C的同期,行业正在力推开放的UCIe标准,其核心正是Die-to-Die互连。NVIDIA选择“Chip-to-Chip”的命名,在技术话语体系上巧妙地与UCIe进行了区隔:UCIe:定位为封装内裸片互连的开放标准,旨在实现不同厂商裸片在先进封装内的“即插即用”。1NVLink-C2C:定位为NVIDIA私有的、更高层级的互连技术,不仅涵盖封装内,更强调封装间(板级)的超高性能一致性互联,服务于其构建“超级芯片”和庞大计算节点的整体战略。56这种命名避免了让市场直接将其与UCIe在D2D层面进行对标,而是突出了其在性能(带宽、延迟)和系统集成度上的更高追求。6四、 品牌与技术路线的延续“NVLink” 本身已是NVIDIA高性能互连的金字招牌,最初用于GPU间互联,后扩展到GPU与CPU。“C2C”是其自然演进,明确了互连的物理主体从“板卡”进一步下探到了“芯片”级别。NVLink(卡间) -> NVLink-C2C(芯片间) -> (未来可能的)更紧密集成。这种命名保持了品牌的一致性和技术演进的清晰脉络,让开发者与合作伙伴易于理解:这是NVLink技术向更底层、更紧密集成方向的延伸。总结NVIDIA选择 NVLink-C2C 而非 NVLink-D2D,绝非随意之举:技术定义更广:C2C涵盖了从封装内裸片到板级封装芯片的互连,而D2D通常特指前者。市场定位更高:强调其用于连接完整产品级芯片,构建超级芯片系统的能力,与单纯的裸片集成区分开来。战略区隔明显:与行业开放的UCIe(D2D)标准形成差异化竞争,突出其私有高性能技术路线。品牌延续性强:作为NVLink家族的新成员,清晰表明了技术方向的演进。因此,“Chip-to-Chip”是对这项技术野心和应用范围更准确、更具战略视野的命名。Unified BUS华为统一开放的可以用于芯片内部,die-2-top, chip-to-chip,server-to-server 的总线。技术核心特点:总线级互联:提供类似计算机内部总线的紧密连接能力,使得超节点内多个计算单元能够高效协同工作。协议归一化:通过统一互联协议,解决不同计算设备间的兼容性问题,降低系统复杂度。平等协同:超节点内各个计算单元处于平等地位,能够动态分配任务和负载。全量池化:将计算、存储和网络资源完全池化,实现资源的灵活调度和高效利用。大规模组网:支持极大规模计算集群组建,华为基于灵衢技术推出的超节点集群可支持50万卡至百万卡级别的算力规模。高可用性:具备故障自动检测、隔离和恢复能力,确保大规模计算系统的高可靠性。华为自2019年开始研究灵衢技术,目前已发布灵衢2.0技术规范并对外开放,包括《灵衢基础规范2.0》、《灵衢固件规范2.0》和《灵衢使能操作系统参考设计2.0》等核心文档3 chiplet 的封装技术支持Chiplet的底层封装技术维度代表技术厂商核心特点2DMCM (Multi-Chip Module)通用多芯片平铺在有机基板上,通过基板布线互连,成本低但密度有限2.5DCoWoS (Chip-on-Wafer-on-Substrate)台积电通过硅中介层或 RDL 中介层实现高密度互连,分为 CoWoS-S(硅中介层)、CoWoS-R(RDL 中介层)、CoWoS-L(LSI+RDL) EMIB (Embedded Multi-die Interconnect Bridge)Intel嵌入式硅桥技术,无需完整硅中介层,成本更低、灵活性更高 I-Cube三星分为 I-Cube S(硅中介层,类似 CoWoS)和 I-Cube E(Si Bridge + RDL,类似 EMIB) InFO\_oS / FOCoS-B台积电 / 日月光扇出型封装,使用 RDL 重布线层作为中介层3DSoIC (System-on-Integrated-Chips)台积电晶圆对晶圆键合,无凸点直接键合,真正的垂直 3D 堆叠 FoverosIntel有源中介层 3D 堆叠,使用 TSV 实现上下层芯片通信 X-Cube三星3D 封装技术,支持 HBM 与逻辑芯片垂直集成 Hybrid Bonding (混合键合)多家铜-铜直接键合,实现更高密度的 3D 互连封装技术目前主要由TSMC、ASE、Intel等公司来主导,包含从2D MCM到2.5D CoWoS、EMIB和3D Hybrid Bonding。本文主要介绍目前工业界主流的2D和2.5D封装技术和其优缺点。1. MCM(Multi-Chip Module)Multi-chip ModuleMCM一般是指通过Substrate(封装基板)走线将多个芯片互联的技术。通常来说走线的距离和范围可以在10mm~25mm,线距线宽大约10mm量级,单条走线带宽大约10Gbit/s量级。由于MCM可以通过基板直接连接各个芯片,通常封装的成本会相对较低,但是由于走线的线距线宽比较大,封装密度相对较低,接口速率相对较低,延时相对较大。MCM 是 2D 封装:所有芯片平铺在基板上,通过基板走线连接,技术成熟、成本最低,但布线密度受限(线宽通常 >12μm)2. CoWoS(Chip-on-Wafer-on-Substrate)CoWoS是TSMC主导的,基于interposer(中间介质层)实现的2.5D封装技术,其中interposer采用成熟制程的芯片制造工艺,可以提供相比MCM更高密度和更大速率的接口。目前TSMC主流的CoWoS技术包括:CoWoS-S:基础CoWoS技术,可以支持超高集成密度,提供不超过两倍掩膜版尺寸的interposer层,通常用于集成HBM等高速高带宽内存芯片。CoWoRCoWoS-R:基于前述CoWoS-S技术,引入InFO技术中的RDL(Redistribution Layer),RDL 中介层由聚合物和铜迹线组成,具有相对机械柔韧性,而这种灵活性增强了封装连接的可靠性,并允许新封装可以扩大其尺寸以满足更复杂的功能需求,从而有效支持多个Chiplets之间进行高速可靠互联。CoWoS-RCoWoS-L:在上述CoWoS-S和InFO技术的基础上,引入LSI(Local Silicon Interconnect)技术,LSI 芯片在每个产品中可以具有多种连接架构(例如 SoC 到 SoC、SoC 到小芯片、SoC 到 HBM 等),也可以重复用于多个产品,提供更灵活和可复用的多芯片互联架构。CoWoS-L相比于MCM,CoWoS技术可以提供更高的互联带宽和更低的互联延时,从而获得更高的性能。同时,受限于interposer的尺寸(通常为2倍掩膜版最大尺寸),可以提供的封装密度上限相对比较有限,并且由于interposer的引入,需要付出额外的制造成本和更高的技术复杂度,以及随之而来的整体良率的降低。3. EMIB(Embedded Multi-die Interconnect Bridge)EMIBEMIB是Intel主导的2.5D封装技术,使用多个嵌入式包含多个路由层的桥接芯片,同时内嵌至封装基板,达到高效和高密度的封装。由于不再使用interposer作为中间介质,可以去掉原有连接至interposer所需要的TSVs,以及由于interposer尺寸所带来的封装尺寸的限制,可以获得更好的灵活性和更高的集成度。总体而言,相比于前述介绍的MCM、CoWoS和InFO/LSI技术,EMIB技术要更为优雅和经济高效,获得更高的集成度和制造良率。但是EMIB需要封装工艺配合桥接芯片,技术门槛和复杂度较高。CoWoS、EMIB、I-Cube 都属于 2.5D 封装:它们都通过中介层/硅桥实现比 MCM 更高密度的互连CoWoS 使用完整硅中介层,密度最高但成本也高EMIB 使用局部硅桥,性价比更好I-Cube E 是三星的"类 EMIB"方案SoIC、Foveros、X-Cube属于 3D 封装:实现芯片垂直堆叠,是真正的立体集成用于 HBM 堆叠、3D Cache 等场景"3.5D 封装"是混合概念:实际工程中常混合使用 2.5D 和 3D,例如逻辑芯片用 2.5D 放在中介层上,HBM 内存用 3D 堆叠,但这并非正式分类4 Chiplet架构挑战和洞察基于Chiplet的架构设计,首先要考虑不同Chiplets之间如何进行功能划分和架构定义,目前主流的设计思路大致可以分为两类:第一类基于功能划分到多个Chiplets,单个Chiplet不包含完整功能集合,通过不同Chiplets组合封装实现不同类型的产品,典型代表为Huawei Lego架构(Kunpeng & Ascend)、AMD Zen2/3架构。Huawei Lego架构:采用compute die(compute + memory interface)和I/O die组合的形式进行不同Chiplets功能拆解。在compute die(CPU/AI)设计时采用先进的工艺,获得顶级的算力和能效,在I/O die设计时采用成熟工艺,在面积与先进工艺差别不大的情况下获得成本收益。并且不同的Chiplets的数量和组合形式都可以灵活搭配,从而组合出多种不同规格的云端高性能处理器产品。AMD Zen3架构:采用CCD(compute)和CIOD(memory interface + I/O)组合的形式进行不同Chiplets功能拆解。在CCD设计时采用最先进的工艺,获得顶级的算力和能效,在CIOD设计时采用成熟工艺,在面积与先进工艺差别不大的情况下获得成本收益。并且CCD本身按照两个4C8T cluster组合的形式设计,可以适应AMD从Desktop到Server的架构需求,根据场景选择CCD数量和设计对应的CIOD即可,灵活度非常高。第二类单个Chiplet包含较为独立完整的功能集合,通过多个Chiplets级联获得性能的线性增长,典型代表为Apple M1 Ultra、Intel Sapphire rapids系列。Apple M1 Ultra:通过Apple自研的封装技术UltraFusion来堆叠两颗M1 Max芯片,使得两颗芯片之间拥有超过2.5TB/s带宽且极低延时的互联能力。基于这个互联的延时带宽能力,可以使得M1 Ultra直接获得两倍M1 Max的算力,同时在软件层面依然可以将M1 Ultra当做一个完整芯片对待,而不会增加额外的软件修改和调试的负担。Intel Sapphire Rapids:通过两组镜像对称的相同架构的building blocks,组合4个Chiplets,获得4倍的性能和互联带宽。每个基本模块包含计算部分(CHA & LLC & Cores mesh, Accelerators)、memory interface部分(controller, Ch0/1)、I/O部分(UPI,PCIe)。通过将上述高性能组件组成基本的building block,再通过EMIB技术进行Chiplet互联,可以获得线性性能提升和成本收益。基于Chiplet的架构设计,同时要考虑多个Chiplets如何进行有效互联和扩展,实现高效灵活可扩展的架构,避免多Chiplets之间出现信号死锁、流量拥塞等功能和性能问题。由于芯片内部互联通常为可靠连接假设下的并行数据传输,而芯片之间的互联通常为不可靠连接假设下的串行数据传输,根据芯片片上和片间互联架构的组合和流量收敛情况,目前主流的设计思路和应用场景大致分为两大类:第一类片上片间相同架构,流量全打平或基本打平。典型代表如Cerebras,采用从tile到single die到wafer scale engine完全相同的互联架构。另一个典型代表是Tesla DoJo,采用InFO-SoW的封装和芯片四边全部放置I/O接口的方式实现片内每个方向10TBps带宽,跨片每边4TBps,SoW集成后单边带宽9TBps。CS-1 Wafer Scale Engine第二类片上片间架构相似,片间流量按照一定比例收敛。典型代表一个是前述的Huawei Bufferless Multi-Ring架构,片上流量会收敛到分布式的各个跨片接口;另一个典型代表是前述的Apple M1 Ultra,片上流量收敛到UltraFusion集中交换部分。Bufferless Multi-Ring从计算负载的角度,当单个计算任务计算密度较高,超出单芯片算力范围的时候,需要多个芯片协同来完成,此时跨片数据交互也需要提供和片上数量级相当的带宽和延时,才能更有效利用算力,提高计算效率。典型的任务类型是AI的训练任务,前述Cerebras和DoJo的互联架构对这类场景有较强优势。当计算任务数量庞大,单个任务负载较小,跨片流量通常是要远小于片上流量的,此时采用流量收敛策略更为合适。