搜索到
387
篇与
的结果
-
 内核RAS通知机制的实现 一、简介1、RAS简介RAS(Reliabilty,Availability,Serviceability)是对一台服务器可以被可靠使用的要求,即可靠性、可用性、可维护性,其实现需要软硬件结合息息相关。R表示服务器提供正确输出的能力,要保证1+1=2;A表示能提供输出的能力,要计算出1+1的结果;S表示发现这个设备不能提供服务了(A出了问题),能把坏掉的部分换掉或者修好的能力。2、RAS分类2.1 功能分类目前从硬件层面RAS分为:① CPU RAS,主要L1/L2/L3 cache控制器所报告的错误② PCIE RAS,负责PCI设备所报告的错误③ Momery RAS,主要负责内存控制器所报告的错误在内核与之对应的处理框架叫EDAC(Error Detection And Correction)。由一个核心(edac_core.ko)和多个内存控制器驱动模块组成。2.2 错误分类Intel将Hardware Error 分为以下几类:Corrected Error(CE):指硬件自行恢复的故障,通常也会通知软件,软件读取Status寄存器记录故障信息;Fata Error(FE):指严重的硬件错误,比如Processor 电源故障,Memory Control严重故障等;Uncorrected Error(UCE):指硬件无法自行恢复的故障,在Intel MCA架构下,此类错误是MCi_STATUS寄存器PCC bit为1,表示Processor可能已经被故障损坏,同时重启Processor也不可靠,软件会根据此信息主动Panic;Uncorrected Recoverable Error (UCR):指硬件无法自行恢复,但软件可以采取某些行为修复的错误,这需要对各种错误进行精细化处理(不会出现错误污染、扩散);Uncorrected no action required (UCNA):UCNA通过CMCI上报。UCNA Error表示系统中的某些数据已损坏,但数据尚未被消费(即没被read),并且处理器的状态可用,程序可以继续在处理器上执行。Software recoverable action optional (SRAO):SRAO通过MCE或CMCI上报。SRAO Error表示系统中某些数据损坏,但是未被消费。软件恢复措施是可选的,可以根据MCACOD采取恢复策略。Software recoverable action required (SRAR):SRAR通过MCE上报。SRAR Error表示系统中某些数据损坏且正在被消费,软件必须在此CPU任务调度前采取recovery action(通常是kill当前cpu上进程,但不限于此)。如果无法恢复,比如无法获取Addr或Task信息,则应该Panic。当然上述分类并不是绝对的,只能算是最全面的分类。比如Intel将PCIe Device的RAS故障只分为UCE和CE,这是因为Pcie连接外设一般是非核心硬件,比如USB、磁盘、网卡等。这些组件发生UCE后,都会通知到OS尝试修复。二、RAS通知机制实现内核主要是对BIOS/firmware传递的错误类型进行再处理,因此本小结首先讲述BIOS/firmware是如何通知内核的,然后在介绍内核侧通用(不包含intel和amd)通知机制的注册和处理流程。1、硬件通知机制工作在 x86 平台上的硬件使用多样的方式向上层软件报告硬件错误,有的通过 PCI-E 总线传递错误消息,有的需要读写特定的寄存器组来得到错误信息,还有的通过产生特定的中断或者异常来报告错误状态。在这些各式各样方法的背后,是硬件设计人员和软件开发人员耗费大量的时间用来定义接口以及接口实现。1.1 APEI简介APEI(Advanced Platform Error Interfaces)规范统一了软硬件之间的接口,降低了软硬件开发人员的开发复杂度。不但如此,新的 APEI 接口更加灵活,便于扩展。APEI 的结构组成并不复杂,简单而言,就是 4 张ACPI表:(1)BERT(BOOT Error Record Table)BERT 主要用来记录在启动过程中出现的错误。如果在 OS 未接管平台的控制权限之前, firmware(如 BIOS 或者 UEFI)检测到错误,导致系统无法继续启动,可以通过 BIOS/FIRMWARE 将这种类型的错误写入到特定的存储位置。这样一来,在下一次的正常启动过程中,OS 可以通过特定的方法将之前保存的错误读取出来分析并处理,这就是 BERT 的主要用途。不过,也有可能是在系统运行过程中 firmware 检测到了致命错误,以至于 firmware 决定不通知 OS 而是直接启动,在重启前 firmware 可以记录下相关的错误信息以便之后分析出错原因。在目前阶段,BERT 的用途还没有完全定下来,并且只有 BIOS/FIRMWARE 才有能力对 BERT 执行写入操作;对于 OS 而言,BERT 仅仅是一个只读的表。到目前为止,还没有一款 BIOS 提供对 BERT 的正式支持,因此,相关的代码也没有在 Linux 中实现。这也是到目前为止 APEI 体系中唯一还没有在 Linux 中实现的一个模块。(2)ERST(Error Record Serialization Table )ERST 本质上是一个用来永久存储错误的抽象接口。软件可以通过 ERST 将各种错误信息保存到 ERST 中,再由 ERST 写入到可用于永久存储的物理介质中。ERST 并没有一个严格的定义来界定什么是“错误”,换言之,软件可以保存任何信息到 ERST 中,只要软件认为是有意义,有价值的信息就可以。ERST 的主要作用就是用来存储各种硬件或者平台相关的错误,只要是软件可以记录的错误,都可以将其保存到 ERST 当中。加上BERT 表,这样一来,无论系统运行在哪个阶段,当出现硬件或平台相关的错误时,通过 APEI 接口,都有办法将错误保存下来。这样一来就可以在之后通过适当的方法将错误读取出来进行分析,从而加快定位产生错误的原因并加以解决。(pstore已经实现这个接口)(3)EINJ(Error Injection Table)在 APEI 定义的所有表中,EINJ 是最为特别的一个。因为 EINJ 不是一个用来记录或者保存错误的表,相反,EINJ 的主要作用是用来注入错误并触发错误,或者说,EINJ 是一个用来测试的表。EINJ 可以注入各种类型的硬件错误,这些注入的错误不是模拟的,而是通过 EINJ 和底层 firmware 以及硬件配合真实产生的,主要用来开发者验证。(4)HEST(Hardware Error Source Table)在 HEST 中定义了很多硬件相关的错误源和错误类型,如 MCE, NMI, PCI-E,GHES 等等,类似一个协议。定义这些硬件错误源的目的在于标准化软硬件错误接口的实现。有了 HEST,当发生特定类型的硬件错误,如 PCI-E 设备产生了一个 UC 类型的错误时,BIOS/FIRMWARE 有统一的方法更新特定的寄存器和内部状态,软件有统一的方法去处理和解析错误。最为特殊也是最为重要的硬件错误源类型就是 GHES(Generic Hardware Error Source)。从字面上理解,GHES 是一个通用硬件错误源,基本任何类型的硬件错误都可以使用 GHES 来定义,而无需使用之前提到的特定硬件错误源,如 MCE 等。1.2 通用通知模式(1)在理解RAS通知机制之前,首先要了解几种中断:MCE -- Machine Check Exception (vector 18),检测到错误中断;NMI -- NonMaskable Interrupt (vector 2),不可屏蔽中断;SMI -- System Management Interruption,系统管理中断,是由硬件触发,由BIOS处理的中断。硬件有相应的指令可以触发,触发后CPU将进入SMM模式(System Management Mode系统管理模式),此时OS相关执行流程将被挂起,执行BIOS中注册的ISR。SCI:System Control Interruption,系统控制中断,是由BIOS触发,然后由OS处理的中断,通常会在BIOS处理完相关的SMI中断后触发,从而退出SMM模式,退回保护模式,然后由OS内核中注册的ISR进行处理。用于BIOS和OS之间的通信。(2)通知机制的实现主要有两种方式:Firmware First Model 固件优先模式,这种模式也是大部分内核默认的,即先通过SMI中断进入BIOS/firmware,再由BIOS/firmware决定OS中断的类型,并决定是否触发。所有 CE 类型的错误通过 SCI 中断报告给 OS,然后 OS 在 HEST/GHES 中查表,检测并处理可能的硬件错误;所有 Fatal 类型的错误通过 NMI 中断报告给 OS,然后 OS 在 NMI 的 handler 中查表,检测并处理可能的硬件错误。这些规定并不是硬性要求的,平台设计者完全可以根据需要使用不同中断来处理。OS Native Model,OS原生模式,即发生错误时:CPU/memory/chipset的无法恢复的故障通常触发MCE中断;I/O故障可能触发PCIe AER中断,前提是软硬件都支持;其它硬件故障统统触发NMI中断。三、小结发生硬件错误时,目前配置CPU会首先通过SMI中断通知BIOS,bios会根据配置来决定是否通知内核或者直接panic。目前通用的出入方式如下:(1)当发生CE错误时,bios会中sci中断通知内核,内核进行记录,如果发生频繁内核将会进行迁移和隔离(LRU和大页);(2)当发生非致命UC错误时,通知机制和CE一致,内核会记录错误,并将错误进行隔离,最后可能会导致进程被kill;(3)当发生Fatal UC时,内核会panic。本篇文章转载自天翼云官方网站开发者社区,了解更多云计算知识可登录天翼云官方网站开发者社区,点击专栏查看更多技术干货,与技术大咖促膝论道!
-
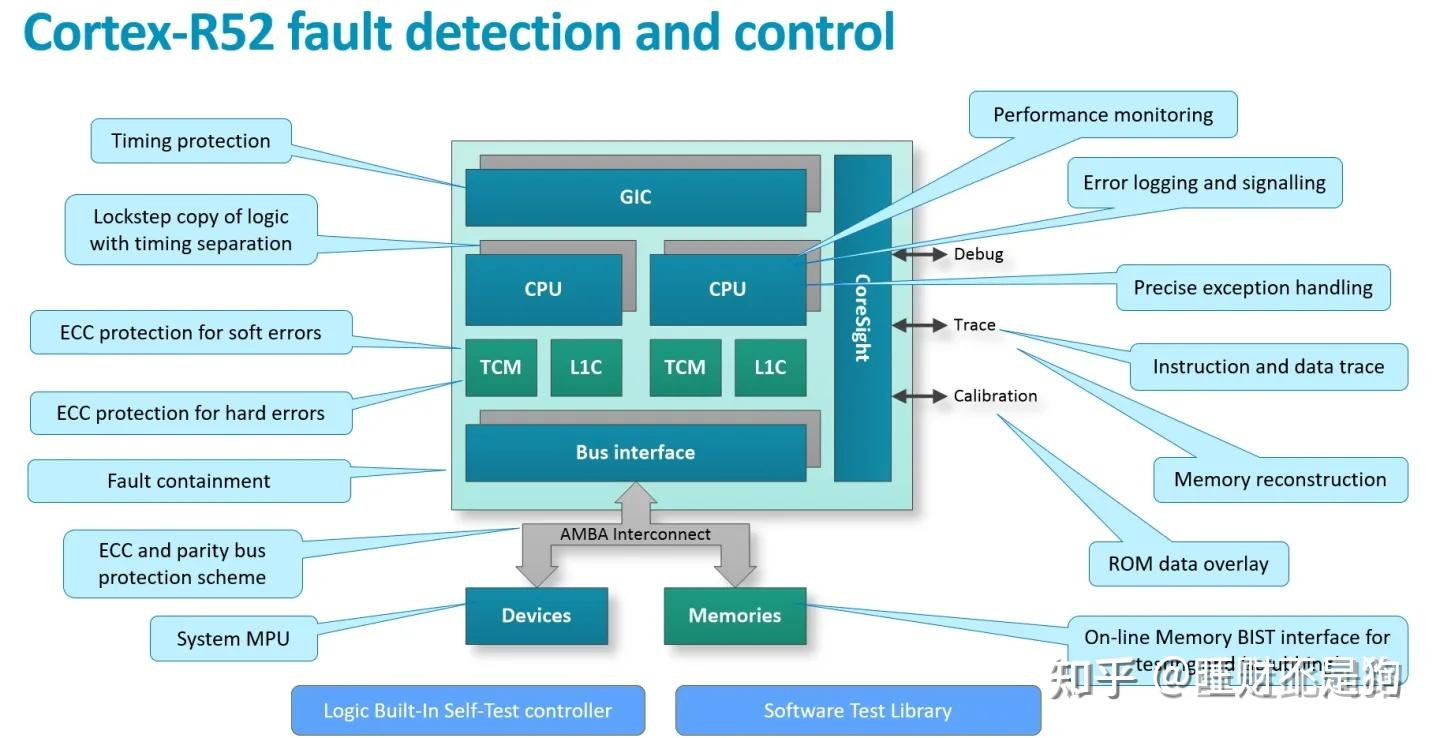
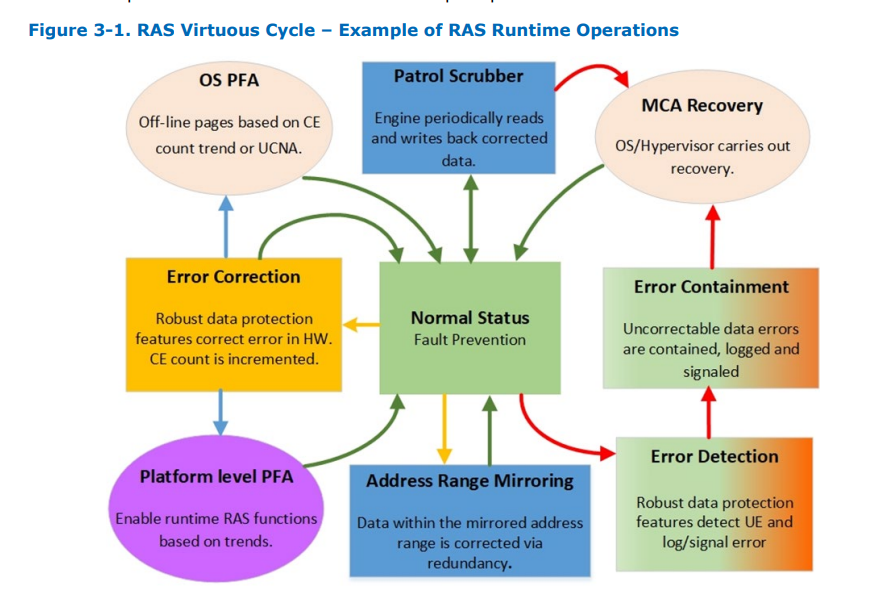
芯片领域中 RAS 的概念及实际技术举例 Reliability, Availability, and Serviceability可靠性(Reliability)系统持续产生正确结果并确保数据完整性的能力,核心是错误检测与纠正。关键技术与原理ECC(Error-Correcting Code)通过冗余数据位检测和纠正内存中的单/多位错误。例如,ECC 内存可修复单比特错误,避免系统崩溃。奇偶校验(Parity)与 CRC(Cyclic Redundancy Check)奇偶校验:通过奇偶位检测单比特错误,但无法纠正。CRC:通过多项式计算生成校验码,检测数据传输中的错误(如网络通信)。错误隔离与标记对不可纠正的错误(如多比特内存故障),系统隔离错误数据并标记,防止错误扩散(例如内核内存错误可触发系统崩溃保护)。SDDC(Single Device Data Correction)内存控制器通过 ECC 技术,即使单个内存芯片完全故障,仍能纠正数据错误(如 Intel 的 x4 SDDC)。内存镜像(Memory Mirroring)全镜像:复制所有内存数据到备用模块,故障时切换(牺牲 50% 容量)。地址范围镜像:仅镜像关键区域(如内核内存),降低成本并保护虚拟化环境中的核心状态。可用性(Availability)系统在故障时保持运行的能力,核心是容错与降级运行。关键技术与原理CPU 自检(BIST, Built-In Self-Test)系统上电时自动检测硬件状态,确保基础组件(如缓存、寄存器)正常,否则阻止启动。UPI 动态链路宽度缩减当高速互连链路(如 Intel UPI)发生 CRC 错误时,自动减半链路宽度(如 16 位 → 8 位),以维持通信功能。内存禁用与映射(DDR5)检测到故障内存单元后,系统在初始化阶段将其标记为禁用(map-out),允许剩余内存正常引导至操作系统。CXL/PCIe 热插拔支持在不关机情况下更换故障设备(如硬盘、GPU),通过冗余链路维持系统运行。PCIe 链路重新训练当链路信号质量下降时,重新协商通信参数(如速率、电压),恢复稳定连接。预测性故障分析结合算法(如机器学习)分析硬件健康状态(如温度、电压),提前触发维护操作(如迁移数据、降频)。无缝固件更新通过双固件分区设计,在运行时更新微码(如 CPU 微码),无需重启系统。可维护性(Serviceability)快速诊断和修复故障的能力,核心是错误日志与访问机制。关键技术与原理错误报告与日志硬件记录错误详细信息(如错误类型、位置),供管理员通过操作系统或管理接口(如 IPMI)查看。超时定时器检测组件响应超时(如 CPU 未收到内存响应),触发错误中断并记录日志,防止系统挂起。带外(OOB)错误收集(如 JTAG)通过独立于操作系统的接口(如 JTAG 调试端口)访问硬件日志,即使系统崩溃也能获取故障信息。带内错误收集(状态寄存器)通过操作系统直接读取硬件寄存器中的错误状态(如 PCIe 设备的配置空间),简化诊断流程。总结可靠性:通过 ECC、镜像等技术确保数据正确性。可用性:通过热插拔、链路恢复等技术最小化停机时间。可维护性:通过日志、OOB 访问等技术加速故障定位。可以观察到,高可靠性和高可维护性会导致高可用性,因为一个不发生故障的系统具有很高的可用性。如果它遇到故障,高可维护性确保系统能够更快地恢复运行,从而提高整体可用性。
-
-
-