
Reliability, Availability, and Serviceability
- 可靠性(Reliability)
系统持续产生正确结果并确保数据完整性的能力,核心是错误检测与纠正。
关键技术与原理
ECC(Error-Correcting Code)
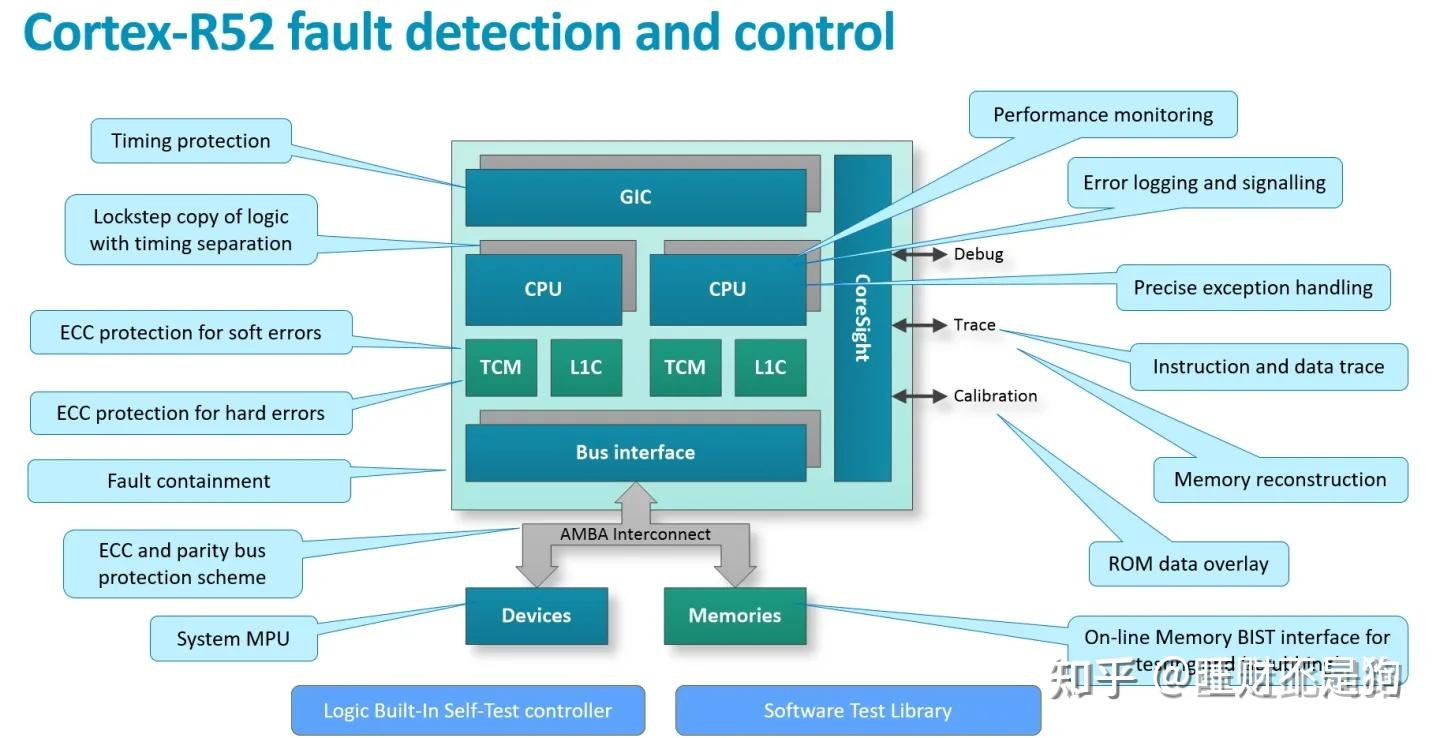
通过冗余数据位检测和纠正内存中的单/多位错误。例如,ECC 内存可修复单比特错误,避免系统崩溃。
奇偶校验(Parity)与 CRC(Cyclic Redundancy Check)
奇偶校验:通过奇偶位检测单比特错误,但无法纠正。
CRC:通过多项式计算生成校验码,检测数据传输中的错误(如网络通信)。
错误隔离与标记
对不可纠正的错误(如多比特内存故障),系统隔离错误数据并标记,防止错误扩散(例如内核内存错误可触发系统崩溃保护)。
SDDC(Single Device Data Correction)
内存控制器通过 ECC 技术,即使单个内存芯片完全故障,仍能纠正数据错误(如 Intel 的 x4 SDDC)。
内存镜像(Memory Mirroring)
全镜像:复制所有内存数据到备用模块,故障时切换(牺牲 50% 容量)。
地址范围镜像:仅镜像关键区域(如内核内存),降低成本并保护虚拟化环境中的核心状态。
- 可用性(Availability)
系统在故障时保持运行的能力,核心是容错与降级运行。
关键技术与原理
CPU 自检(BIST, Built-In Self-Test)
系统上电时自动检测硬件状态,确保基础组件(如缓存、寄存器)正常,否则阻止启动。
UPI 动态链路宽度缩减
当高速互连链路(如 Intel UPI)发生 CRC 错误时,自动减半链路宽度(如 16 位 → 8 位),以维持通信功能。
内存禁用与映射(DDR5)
检测到故障内存单元后,系统在初始化阶段将其标记为禁用(map-out),允许剩余内存正常引导至操作系统。
CXL/PCIe 热插拔
支持在不关机情况下更换故障设备(如硬盘、GPU),通过冗余链路维持系统运行。
PCIe 链路重新训练
当链路信号质量下降时,重新协商通信参数(如速率、电压),恢复稳定连接。
预测性故障分析
结合算法(如机器学习)分析硬件健康状态(如温度、电压),提前触发维护操作(如迁移数据、降频)。
无缝固件更新
通过双固件分区设计,在运行时更新微码(如 CPU 微码),无需重启系统。
- 可维护性(Serviceability)
快速诊断和修复故障的能力,核心是错误日志与访问机制。
关键技术与原理
错误报告与日志
硬件记录错误详细信息(如错误类型、位置),供管理员通过操作系统或管理接口(如 IPMI)查看。
超时定时器
检测组件响应超时(如 CPU 未收到内存响应),触发错误中断并记录日志,防止系统挂起。
带外(OOB)错误收集(如 JTAG)
通过独立于操作系统的接口(如 JTAG 调试端口)访问硬件日志,即使系统崩溃也能获取故障信息。
带内错误收集(状态寄存器)
通过操作系统直接读取硬件寄存器中的错误状态(如 PCIe 设备的配置空间),简化诊断流程。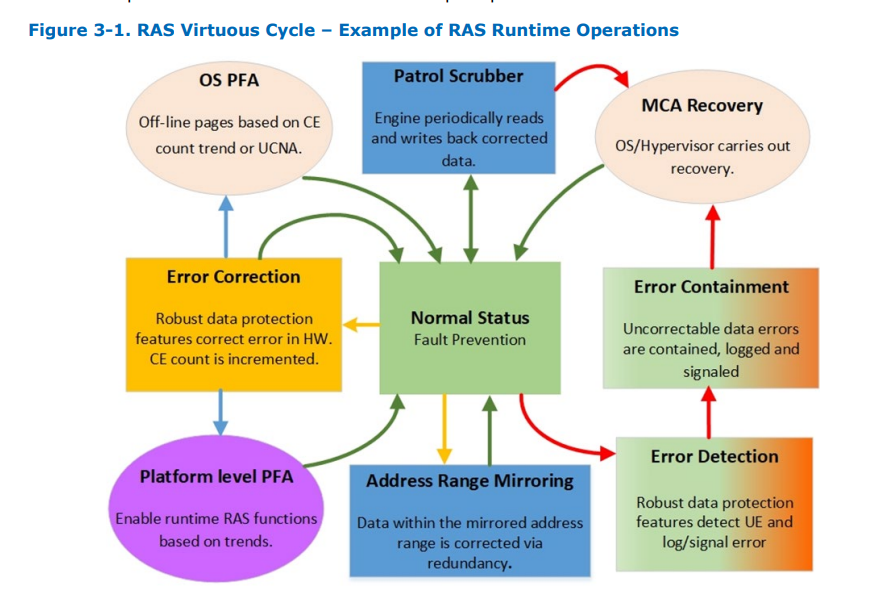
总结
可靠性:通过 ECC、镜像等技术确保数据正确性。
可用性:通过热插拔、链路恢复等技术最小化停机时间。
可维护性:通过日志、OOB 访问等技术加速故障定位。
可以观察到,高可靠性和高可维护性会导致高可用性,因为一个不发生故障的系统具有很高的可用性。如果它遇到故障,高可维护性确保系统能够更快地恢复运行,从而提高整体可用性。
评论 (0)